인지야공/딥러닝 기초 정리/56번째 글
몬테카를로 트리 탐색 — 계산을 어디에 쓸지 고르기
실행:
python NN_43_mcts.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 함께 보면 좋은 글: 강화학습 기초 편 · 추론 시간 계산 편
강화학습 기초 편에서 가치를 표로 다 적어 풀었다. 그런데 바둑이나 체스처럼 상태가 천문학적으로 많으면 표를 만들 수 없다. 그렇다고 끝까지 다 읽을 수도 없다.
몬테카를로 트리 탐색(MCTS)의 답은 뻔뻔할 만큼 단순하다 — 끝까지 아무렇게나 둬 보고, 이긴 쪽을 세라. 평가 함수도, 도메인 지식도 필요 없다. 규칙만 있으면 된다.
1. 네 단계 — 그림으로 먼저
MCTS는 같은 네 단계를 예산이 다할 때까지 반복한다.
선택에서 쓰는 기준이 이 방법의 핵심이다. 평균이 좋은 쪽으로만 가면 우연히 좋게 나온 수에 갇히고, 골고루 가면 예산이 낭비된다. UCB는 둘을 한 식에 담는다.
| 기호 | 뜻 |
|---|---|
| 그 수를 굴려 본 횟수 | |
| 그중 이긴 횟수 | |
| 부모에서 굴린 총 횟수 | |
| 탐험 상수(여기서는 1.4) |
앞항은 “좋았던 쪽으로”, 뒷항은 “덜 가 본 쪽으로”다. 적게 가 본 수는 뒷항이 커서 한 번쯤 기회를 얻고, 계속 나쁘면 자연히 밀려난다. 강화학습 기초 편의 탐험 이야기가 무작위 대신 값으로 돌아온 셈이다.
2. 직접 재 보기 A — 규칙만으로 강해진다
사목(7열×6행)에서 무작위로 두는 상대와 붙였다. 평가 함수는 없다.
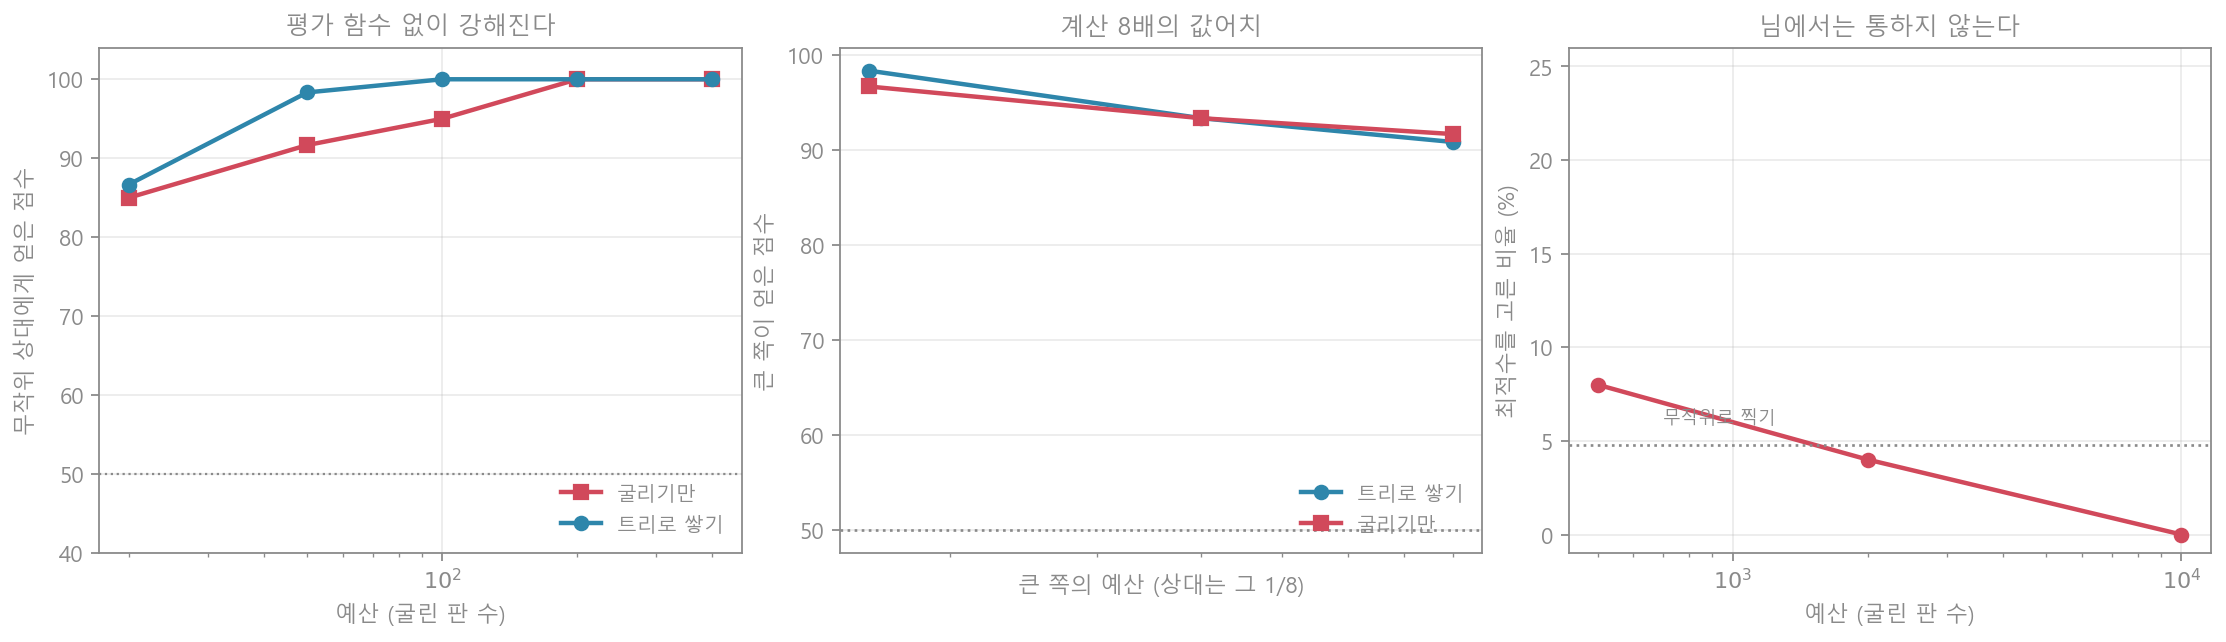
| 예산(굴린 판) | 20 | 50 | 100 | 200 | 400 |
|---|---|---|---|---|---|
| 굴리기만 (루트에서 나눠 굴림) | 85.0 | 91.7 | 95.0 | 100.0 | 100.0 |
| 트리로 쌓기 (MCTS) | 86.7 | 98.3 | 100.0 | 100.0 | 100.0 |
(60판 기준 100점 만점. 무작위 상대다.)
단 100판을 굴리는 것만으로 100점이다. 사목의 규칙 외에는 아무것도 안 넣었는데 그렇다. 이것이 MCTS가 처음 주목받은 이유다 — 도메인 지식 없이 그럭저럭 강한 플레이어를 만든다.
3. 직접 재 보기 B — 쌓아 두는 것의 값어치
그런데 “굴리기만” 해도 꽤 강하다. 그럼 트리는 왜 필요한가. 같은 예산으로 직접 붙여 봤다.
| 예산(양쪽 같음) | 100판 | 400판 | 1,600판 | 6,400판 |
|---|---|---|---|---|
| 트리로 쌓기가 얻은 점수 | 68.3 | 65.8 | 68.3 | 85.0 |
(50점이면 대등. 100·400판은 60판, 1,600·6,400판은 30판 기준.)
모든 예산에서 트리가 이기고, 예산이 클수록 격차가 벌어진다(68.3 → 85.0).
이유는 굴린 결과를 어디에 쓰느냐에 있다. 굴리기만 하는 쪽은 각 수의 승률을 재고 그걸로 끝이다. 트리는 그 결과를 저장해 두고, 다음에 어디를 굴릴지 고르는 데 다시 쓴다. 가망 없는 가지는 빨리 버리고 유망한 가지를 깊게 파므로, 예산이 많을수록 그 복리가 커진다.
실제로 예산이 쌓이면서 방문이 한쪽으로 몰리는 것을 찍었다.
처음에는 일곱 열을 고르게 굴려 보다가, 유망한 열이 드러나면 거기에 예산을 몰아준다. 그래서 MCTS는 “가장 좋은 수”를 고를 때 평균 승률이 아니라 가장 많이 굴려 본 수를 고른다 — 많이 굴렸다는 것 자체가 “계속 좋아 보였다”는 뜻이기 때문이다.
참고로 예산을 8배 준 쪽과 붙이면 트리는 98.3 / 93.3 / 90.8점을 얻었다. 계산이 곧 실력이라는 추론 시간 계산 편의 이야기가 게임에서는 이렇게 나타난다.
4. 직접 재 보기 C — 통하지 않는 판
여기까지만 보면 만능처럼 보인다. 그래서 통하지 않는 게임을 하나 가져왔다. 님(Nim)이다. 돌무더기에서 번갈아 가져가고 마지막 돌을 가져간 쪽이 이기는데, 최적 전략이 알려져 있다 (다음 상태의 XOR을 0으로 만들면 이긴다).
상태 (5, 7, 9)에서 가능한 수는 21개이고 그중 최적수는 딱 하나다. 무작위로 찍으면 4.8%다.
| 예산 | 500판 | 2,000판 | 10,000판 |
|---|---|---|---|
| 최적수를 고른 비율 | 8.0% | 4.0% | 0.0% |
예산을 20배 늘려도 무작위로 찍는 것과 다르지 않다. 오히려 떨어진다.
이유는 무작위 굴림이 재는 값이 우리가 원하는 값이 아니기 때문이다. 굴림은 “무작위로 두는 상대에게 이길 확률”을 잰다. 사목에서는 그것이 “제대로 두는 상대에게의 가치”와 대체로 같은 방향이라 잘 통했다. 그런데 님에서는 전혀 다르다 — 최적수를 두어도 무작위 상대에게는 딱히 유리하지 않고, 엉뚱한 수가 무작위 상대에게 더 잘 먹힐 수 있다. 예산을 늘리면 그 틀린 값에 더 정확히 수렴할 뿐이다.
이것이 알파고가 무작위 굴림을 신경망으로 바꾼 이유다. 굴림 대신 학습된 가치망이 국면을 평가하고, 어디를 굴릴지도 정책망이 제안한다. MCTS의 뼈대는 그대로 두고, 평가의 질만 바꾼 것이다.
5. 흔한 오해와 한계
- “MCTS는 게임을 읽는다” — 읽는 것이 아니라 굴려 본다. 그 굴림이 엉뚱하면 결과도 엉뚱하다(4절).
- “예산을 늘리면 언젠가 최적에 간다” — 이론적으로는 그렇지만, 님처럼 굴림이 편향되면 실용적인 예산 안에서는 오히려 나빠진다.
- “평균 승률이 가장 높은 수를 고른다” — 보통 가장 많이 굴려 본 수를 고른다(3절). 적게 굴린 수의 높은 승률은 우연일 수 있다.
- “트리는 항상 낫다” — 이 글의 첫 실험에서는 아니었다. 실은 제 구현에 버그가 있었고 (끝난 국면을 재방문할 때 확정된 패배 대신 굴림으로 평가했다), 고치자 3절처럼 뒤집혔다. 탐색 코드의 버그는 성능 저하로만 나타나 알아채기 어렵다.
- 이 글의 실험 — 사목과 님이라는 작은 게임이고, 상대도 무작위이거나 같은 알고리즘이다. 100.0·85.0점 같은 수는 이 설정의 값이고, 요점은 굴림으로 값을 얻는다, 쌓아 두면 복리가 붙는다, 굴림이 틀리면 전부 틀린다는 구조다.
6. 한 문단 요약
MCTS는 평가 함수 없이 규칙만으로 둔다 — 끝까지 아무렇게나 둬 보고(굴림), 그 결과를 트리에 쌓고, 다음에 어디를 굴릴지 UCB로 고른다. 사목에서 100판만 굴려도 무작위 상대를 100점으로 이겼다. 트리의 값어치는 같은 예산으로 붙여 보면 드러난다. 그냥 나눠 굴리는 쪽을 68.3점으로 이겼고, 예산을 6,400판으로 키우자 85.0점까지 벌어졌다 — 굴린 결과를 다음 굴림을 고르는 데 다시 쓰기 때문이고, 그래서 예산이 많을수록 복리가 붙는다. 다만 전제가 하나 있다. 굴림이 재는 것은 무작위 상대에게 이길 확률이지 진짜 가치가 아니다. 님에서는 그 둘이 어긋나서, 예산을 20배 늘려도 최적수를 고르는 비율이 무작위로 찍는 4.8%와 다르지 않았다. 알파고가 굴림을 가치망으로 바꾼 이유가 바로 이 한 줄이다.