인지야공/수학·공학 노트/13번째 글
립시츠 상수 — 입력을 조금 밀면 출력이 얼마나 밀리나
실행:
python 딥러닝/mathnotes/M16_lipschitz.py적대적 예제 편의 “눈에 안 보이는 변화가 답을 바꾼다”를 정리한다.
1. 확대율
함수가 입력의 변화를 얼마나 키워서 내보내는가. 그 최댓값이 립시츠 상수다.
| 기호 | 뜻 |
|---|---|
| 립시츠 상수 — 확대율의 최댓값 | |
| 벡터의 길이 |
중요한 것은 최댓값이라는 점이다. 평균이 아니다. 어떤 한 방향이라도 크게 늘어나면 은 크다.
선형 변환 에서 은 의 최대 특이값이다. 그리고 그 값을 내는 방향이 최대 특이벡터다. SVD 노트에서 봤던 그 분해가 여기서 쓰인다.
2. 직접 재 보기
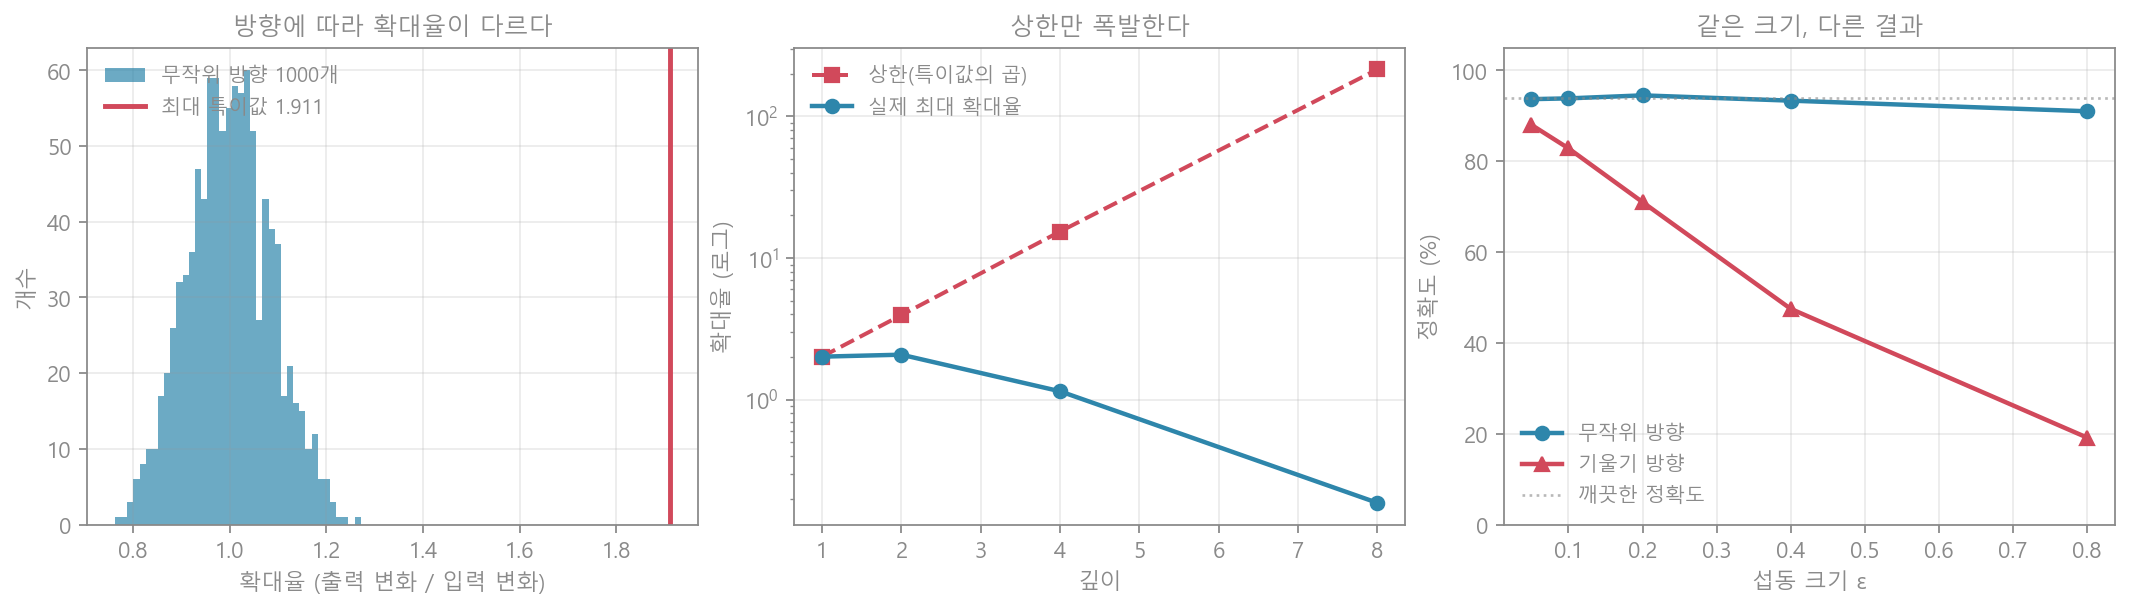
방향에 따라 확대율이 다르다
64×64 행렬 하나를 놓고, 길이 1인 방향 1000개를 무작위로 뽑아 확대율을 쟀다.
| 확대율 | |
|---|---|
| 특이값 최대 / 최소 | 1.9114 / 0.0100 |
| 무작위 방향 1000개의 평균 | 1.0009 |
| 무작위 방향 1000개의 최대 | 1.2711 |
| 최대 특이벡터 방향 | 1.9114 |
무작위로 밀면 평균 1.00배다. 그런데 제대로 고른 방향으로 밀면 1.91배다. 1000번 무작위로 뽑아도 1.27배까지밖에 못 갔다 — 좋은 방향은 우연히 만나기 어렵다.
상한은 곱해지는데, 실제로는 그렇지 않다
합성함수의 립시츠 상수는 각 층 상수의 곱 이하다. . 그래서 “깊은 망은 상수가 지수로 커진다”고 흔히 말한다. 실제로 재 봤다.
| 깊이 | 상한(층별 특이값의 곱) | 실제 최대 확대율 | 상한 / 실제 |
|---|---|---|---|
| 1 | 2.0131 | 2.0131 | 1.0배 |
| 2 | 3.9552 | 2.0785 | 1.9배 |
| 4 | 15.3958 | 1.1460 | 13.4배 |
| 8 | 215.0797 | 0.1868 | 1151.5배 |
상한은 폭발하는데 실제 확대율은 오히려 줄어든다. ReLU가 절반을 0으로 죽이므로 층을 지날 때마다 신호가 깎이기 때문이다.
이건 교과서의 “깊으면 립시츠 상수가 크다”를 뒤집는 게 아니라, 그 상한이 얼마나 쓸모없는지를 보여 준다. 8층에서 1151배 느슨하면 “이 망의 은 215 이하”라는 말은 아무것도 보증하지 못한다. 립시츠 상한으로 안전을 증명하려는 인증 방어가 실전에서 자주 헛도는 이유다.
적대적 방향은 ‘가장 늘어나는 방향’이다
32차원 입력을 받는 분류기를 학습시키고(깨끗한 정확도 93.8%), 같은 크기 으로 무작위 방향과 기울기 방향을 각각 밀었다.
| 섭동 크기 | 무작위 방향 | 기울기 방향 |
|---|---|---|
| 0.05 | 93.7% | 88.0% |
| 0.10 | 93.8% | 82.8% |
| 0.20 | 94.5% | 71.0% |
| 0.40 | 93.3% | 47.5% |
| 0.80 | 91.0% | 19.2% |
에서 무작위로 밀면 91.0%로 거의 멀쩡한데, 기울기 방향으로 밀면 19.2% 로 무너진다. 밀어 넣은 양은 똑같다.
이유는 고차원의 기하에 있다. 고차원에서 무작위로 뽑은 두 벡터는 거의 직교하므로, 무작위 방향은 “가장 늘어나는 방향”과 거의 수직이다. 그래서 아무 일도 일어나지 않는다. 공격자는 그 방향을 기울기로 곧장 찾아낸다.
3. 왜 중요한가
- 적대적 예제 편에서 잡음 증강이 방어가 못 된 이유가 위 표 자체다. 무작위 방향으로 아무리 학습시켜도 모델은 “늘어나는 방향”을 한 번도 보지 못한다. 그 글에서 같은 크기의 무작위 증강(86.2%/24.5%)과 적대적 학습(98.0%)이 갈린 것이 이 차이다.
- “사람 눈에 안 보이는 변화”라는 표현이 과장이 아니다. 픽셀 하나하나는 조금씩 바뀌지만, 그 조합이 하필 최대 확대 방향이면 출력은 크게 움직인다. 입력 차원이 높을수록 “작게 나눠 담을” 여지가 커진다.
- 방어를 설계할 때 립시츠 상수를 줄이는 것(스펙트럴 정규화, 가중치 감쇠)은 방향이 맞다. 다만 위에서 봤듯 상한은 매우 느슨해서 보증 수단으로는 약하다. 실측이 필요하다.
- 거꾸로, 학습이 잘 되려면 확대율이 너무 작아도 안 된다. 8층에서 0.19라는 것은 신호가 8층을 지나며 5분의 1로 줄었다는 뜻이고, 그것이 정규화와 잔차 편이 푸는 문제다. 같은 숫자가 강건성에서는 안전으로, 학습에서는 소실로 읽힌다.
4. 한 줄 요약
립시츠 상수는 확대율의 최댓값이고, 선형층에서는 최대 특이값이다. 무작위 방향의 확대율은 평균 1.00배인데 최대 특이벡터 방향은 1.91배였고, 학습된 분류기에서는 같은 로 밀어도 무작위 방향은 91.0%를 남기는데 기울기 방향은 19.2% 로 무너뜨렸다. 고차원에서 무작위 방향은 위험한 방향과 거의 직교하기 때문이다. 다만 층별 특이값을 곱한 상한은 8층에서 실제보다 1151배 느슨해서, 그 상한으로 안전을 보증할 수는 없다.
연결
- 적대적 예제 · 고차원의 기하 · 저계수 행렬과 SVD · 야코비안