인지야공/딥러닝 기초 정리/51번째 글
비전 트랜스포머와 CLIP — 이미지도 토큰이고, 제로샷은 공짜가 아니다
실행:
python NN_27_vit_clip.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 수학: 고차원의 기하 노트.
지금까지 20여 편이 전부 글자를 다뤘다. 그런데 트랜스포머는 텍스트 전용 장치가 아니다. “토큰의 나열”로 바꿀 수만 있으면 그대로 쓸 수 있고, 이미지가 그랬다. 그리고 이미지와 텍스트를 같은 공간에 놓으면, 분류기를 따로 학습하지 않고도 분류가 된다. 그 두 가지와, 거기 붙은 조건을 잰다.
1. ViT — 이미지를 패치로 잘라 토큰으로
트랜스포머는 토큰 사이의 관계를 본다(어텐션 편). 이미지에는 토큰이 없으니 만들면 된다 — 사진을 격자로 잘라 각 조각(패치)을 하나의 토큰으로 본다. 16×16 패치 하나를 쭉 펴서 선형층에 넣으면 그게 임베딩이고, 거기에 위치 인코딩(위치 인코딩 편)을 더하면 나머지는 글자 트랜스포머와 똑같다. 합성곱을 쓰지 않는다.
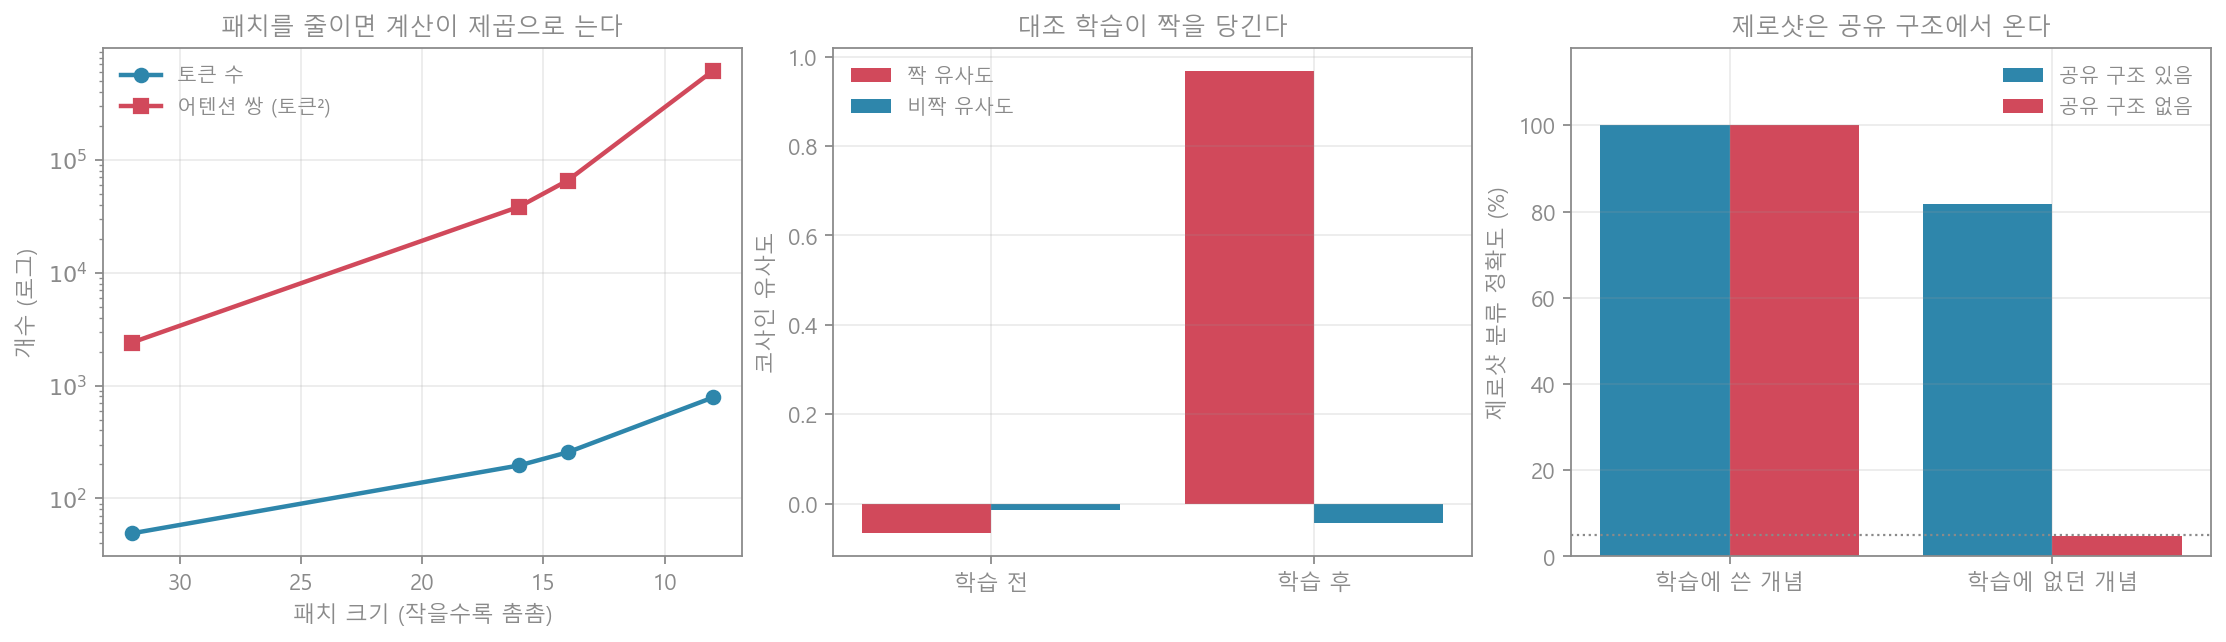
여기서 설계의 핵심은 패치 크기다. 패치가 작을수록 세밀하지만, 토큰 수는 면적에 반비례해 늘고 어텐션은 그 제곱이다.
| 기호 | 뜻 |
|---|---|
| 이미지 한 변의 픽셀 수(여기선 224) | |
| 패치 한 변의 픽셀 수 | |
| 시퀀스 길이 = 패치 개수 |
직접 재 보기 A
224×224 이미지 기준으로 셈했다.
| 패치 크기 | 32×32 | 16×16 | 14×14 | 8×8 |
|---|---|---|---|---|
| 토큰 수 | 49 | 196 | 256 | 784 |
| 어텐션 쌍 | 2,401 | 38,416 | 65,536 | 614,656 |
패치를 32에서 8로 줄이면 토큰은 16배지만 어텐션 계산은 256배다(의 4제곱). ViT가 하필 16×16을 쓰는 이유가 여기 있다(논문 제목부터 “An Image is Worth 16×16 Words”다). 고해상도 비전이 비싼 것도 같은 산수이고, 플래시 어텐션 편·상태공간모델·선형 어텐션 편이 비전에서 특히 절실한 것도 이 때문이다.
2. CLIP — 짝은 당기고 나머지는 민다
이미지 인코더와 텍스트 인코더를 따로 두고, 같은 차원의 공간으로 내보낸다. 그리고 한 배치 안에서 진짜 짝(사진, 그 설명)은 가깝게, 나머지 조합은 멀게 민다. 이것이 대조 학습이고, 손실은 유사도 행렬에 대한 소프트맥스 — 대각선이 정답인 분류 문제다(InfoNCE).
| 기호 | 뜻 |
|---|---|
| 번째 이미지와 번째 텍스트의 코사인 유사도 | |
| 배치 크기 = 후보(오답)의 수 | |
| 온도. 작을수록 날카롭게 판별한다(디코딩과 샘플링 편) |
앞항은 “이미지로 텍스트 찾기”, 뒤항은 “텍스트로 이미지 찾기”다. 라벨이 따로 필요 없다 — 인터넷의 이미지-설명 쌍이 그대로 정답표다. 그래서 4억 쌍 같은 규모가 가능했다.
직접 재 보기 B
개념 40개를 두고, 각 개념의 이미지쪽·텍스트쪽 표현을 만들어 대조 학습을 돌렸다.
| 짝 유사도 | 비짝 유사도 | |
|---|---|---|
| 학습 전 | −0.067 | −0.015 |
| 학습 후 | +0.968 | −0.043 |
학습 전에는 짝이든 아니든 전부 0 근처다 — 고차원에서 무작위 벡터가 거의 직교하기 때문이고 (고차원 기하 노트), 그래서 시작점은 “아무것도 구분 못 하는 상태”다. 학습이 한 일은 짝만 0.97로 끌어올린 것이고, 비짝은 그대로 0 근처에 둔 것이다. 이제 이미지와 글이 한 자로 잴 수 있는 공간에 있다.
3. 제로샷 — 그런데 어디서 오는가
이렇게 정렬하면 분류기를 학습하지 않고 분류할 수 있다. 후보 라벨들을 텍스트로 써서 인코딩해 두고, 이미지 벡터와 가장 가까운 것을 고르면 된다. “고양이 사진”을 본 적 없어도 “고양이”라는 글만 알면 된다는 얘기다.
정말 그런지가 이 글에서 가장 궁금했던 부분이다. 그래서 학습에 쓴 개념과 학습에서 한 번도 안 나온 개념을 갈라 쟀다. 그리고 조건 하나를 더 걸었다 — 이미지쪽과 텍스트쪽이 같은 뜻에서 나온 두 가지 보기인 판(구조 있음)과, 개념마다 두 표현을 무관하게 따로 뽑은 판(구조 없음).
직접 재 보기 C
| 학습에 쓴 개념 | 학습에 없던 개념 | |
|---|---|---|
| 공유 구조 있음 | 100.0% | 81.8% |
| 공유 구조 없음 | 100.0% | 4.8% (무작위 5%) |
두 판 모두 학습한 개념은 100%인데, 새 개념에서 완전히 갈렸다. 구조 없는 판도 학습한 개념의 정렬 격차는 1.004로 멀쩡했다 — 즉 정렬이 잘된 것과 전이되는 것은 다른 얘기다. 구조가 없으면 모델이 배울 수 있는 건 “이 이미지에는 저 글”이라는 사전 찾기뿐이고, 사전에 없는 항목은 찍는 수밖에 없다.
반대로 이미지와 텍스트가 같은 뜻의 두 가지 보기일 때, 모델은 개념 목록이 아니라 뜻을 꺼내는 방법을 배운다. 그래서 처음 보는 뜻에도 그대로 적용된다(81.8%). CLIP의 제로샷은 대조 손실이 준 선물이 아니라, 세상의 사진과 설명이 실제로 같은 것을 가리키고 있다는 사실이 준 것이다. 데이터의 규모와 다양성이 CLIP에서 유독 강조되는 이유이기도 하다.
4. 흔한 오해와 한계
- “제로샷은 학습 없이 된다” — 분류기 학습이 없을 뿐, 정렬 학습은 거대하다(CLIP은 4억 쌍). 공짜인 것은 새 분류 과제를 붙이는 비용이지 능력 자체가 아니다.
- “모델을 키우면 새 개념도 맞힌다” — 3절의 구조 없는 판이 반례다. 학습 데이터가 공유 구조를 담고 있지 않으면 크기로는 메워지지 않는다.
- “ViT가 CNN보다 항상 낫다” — 아니다. ViT는 합성곱이 공짜로 주던 가정(이웃 픽셀은 관련 있다, 위치가 옮겨져도 같다)을 버리는 대신 데이터로 배운다. 그래서 데이터가 적으면 CNN이 낫고, 많으면 ViT가 이긴다.
- “라벨 문구는 상관없다” — 상관있다. 실제 CLIP은
"a photo of a {label}"같은 프롬프트 틀에 따라 정확도가 몇 %p씩 움직인다. 텍스트 인코더가 본 문장 분포에 가까울수록 좋다. - 이 글의 실험 — 인코더도 데이터도 축소한 모형이다. 81.8%·4.8%는 이 설정의 값이고, 요점은 정렬은 쉽고 전이는 조건부라는 구조다.
5. 한 문단 요약
이미지를 패치로 잘라 토큰으로 보면 트랜스포머가 그대로 쓰인다(ViT). 대신 패치 한 변을 4분의 1로 줄이면 어텐션 계산이 256배가 되므로, 패치 크기는 해상도와 비용의 거래다. CLIP은 이미지·텍스트 인코더를 한 공간에 정렬한다 — 배치 안의 진짜 짝만 당기는 대조 손실로, 짝 유사도를 0.97까지 올리고 비짝은 0에 남겼다. 그 결과 라벨을 글로 쓰기만 하면 분류기 없이 분류가 된다. 다만 학습에 없던 개념까지 맞히는 것(81.8%)은 두 모달리티가 공유하는 구조를 배웠을 때뿐이고, 그 구조가 없으면 같은 손실·같은 정렬로도 4.8%, 곧 찍는 수준이었다. 제로샷은 손실 함수가 아니라 데이터가 주는 능력이다.