인지야공/수학·공학 노트/4번째 글
고차원의 기하 — 무작위 벡터는 왜 거의 직교한가
실행:
python 딥러닝/mathnotes/M6_highdim.py토크나이저와 임베딩 편·중첩 편· RAG 편·비전 트랜스포머와 CLIP 편의 바탕이다.
1. 저차원의 직관이 틀리는 곳
2차원 평면에서 화살표 두 개를 아무렇게나 그리면, 나란할 때도 있고 반대일 때도 있다. 평균적으로는 직각이지만 제각각이다. 그런데 차원을 올리면 사정이 달라진다 — 거의 항상 직각에 가깝다.
이유는 간단하다. 단위벡터 두 개의 코사인 유사도는 성분들의 곱을 D개 더한 것이다.
각 항은 +일 수도 −일 수도 있으므로, 더할수록 서로 상쇄된다. 평균은 0이고, 흩어진 정도(표준편차)는 개를 더한 무작위 합의 법칙대로 줄어든다.
| 기호 | 뜻 |
|---|---|
| 벡터의 차원(임베딩 크기) | |
| 두 단위벡터의 번째 성분 | |
| 두 벡터의 코사인 유사도(1이면 같은 방향, 0이면 직각) |
2. 직접 재 보기 1 — 폭이 1/√D를 그대로 따라간다
차원별로 무작위 단위벡터 20,000쌍의 유사도를 쟀다.
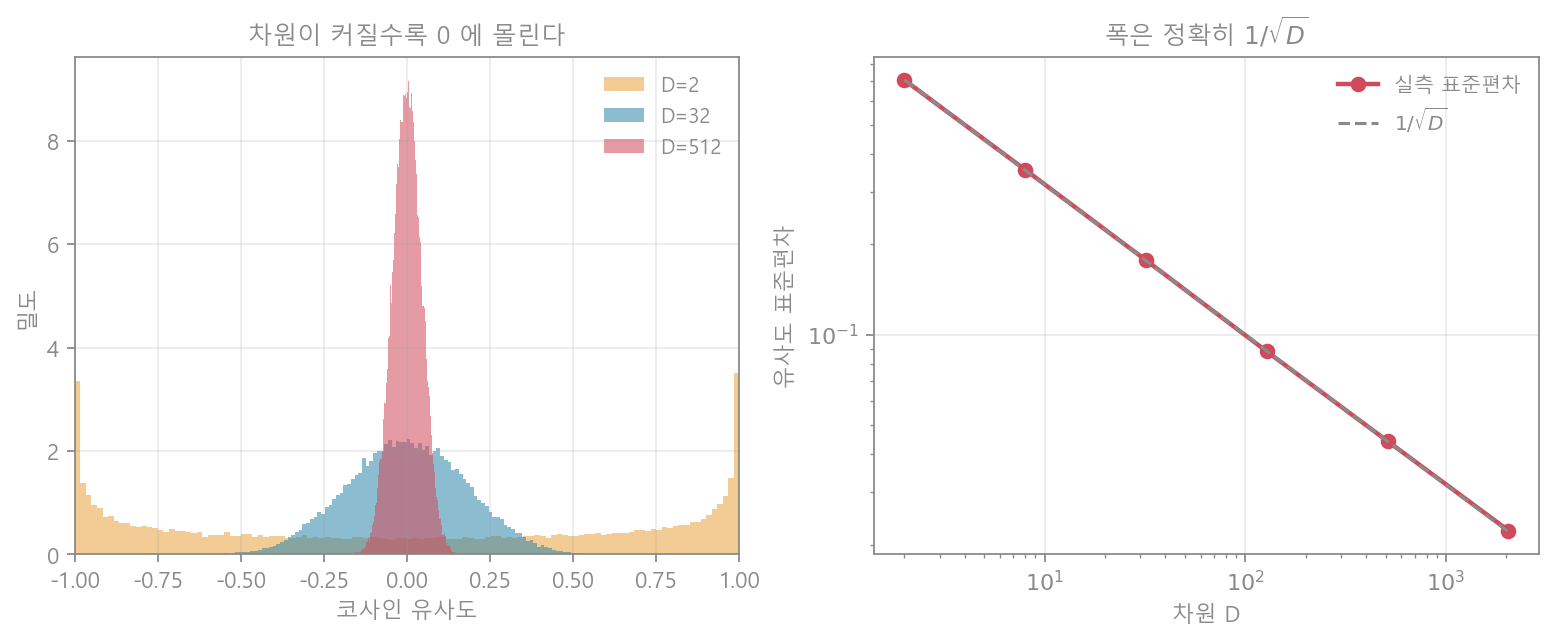
| 차원 | 2 | 32 | 128 | 512 | 2048 |
|---|---|---|---|---|---|
| 유사도 표준편차 | 0.706 | 0.177 | 0.088 | 0.044 | 0.022 |
| 0.707 | 0.177 | 0.088 | 0.044 | 0.022 | |
| |cos| 99% 지점 | 1.000 | 0.446 | 0.226 | 0.114 | 0.058 |
실측이 와 소수점 셋째 자리까지 같다. 2차원에서는 아무 두 벡터나 나란할 수 있지만(99%가 1.0까지), 2048차원에서는 100쌍 중 99쌍이 |cos| 0.058 이하 — 사실상 전부 직각이다.
3. 직접 재 보기 2 — 그래서 방을 훨씬 많이 만들 수 있다
완전히 직교하는 방향은 차원에 개뿐이다(64차원이면 64개). 그런데 “거의 직교”를 허용하면 어떨까. 64차원에 무작위 방향을 점점 더 많이 넣어 보며 가장 심하게 겹치는 쌍을 봤다.
| 64차원에 넣은 개수 | 64 | 256 | 1,024 | 4,096 | 16,384 |
|---|---|---|---|---|---|
| 최대 |cos| | 0.456 | 0.527 | 0.561 | 0.608 | 0.636 |
| 평균 |cos| | 0.102 | 0.100 | 0.100 | 0.100 | 0.100 |
개수를 256배로 늘려도 최악의 겹침은 0.456에서 0.636으로 조금 나빠질 뿐이고, 평균 겹침은 0.100으로 꿈쩍도 않는다. 즉 차원은 개의 개념이 아니라 그보다 훨씬 많은 개념을 “웬만큼 구분되게” 담는다.
4. 딥러닝에서의 의미
- 임베딩(토크나이저와 임베딩 편) — 수만 개 토큰을 수백 차원에 넣어도 서로 안 섞이는 이유가 이것이다. 모델이 굳이 직교하게 배치하지 않아도, 무작위에 가깝기만 하면 이미 거의 직교다.
- 중첩(중첩 편) — 뉴런 수보다 많은 특징을 담는 현상의 수학적 근거다. “거의 직교”를 허용하는 대가로 약간의 간섭(0.1 수준)을 감수하는 거래다.
- 벡터 검색(RAG 편) — 관계없는 문서의 유사도가 자동으로 0 근처에 모이므로, 정답 문서만 튀어 올라 검색이 성립한다.
- 대조 학습(비전 트랜스포머와 CLIP 편) — 학습 전 짝/비짝 유사도가 모두 0 근처인 것이 이 때문이고, 학습은 짝만 1로 끌어올리는 일을 한다.
- 함정 — 거꾸로 말하면 고차원에서는 “가까움”이 잘 안 생긴다. 실제로 의미 있게 가까우려면 학습이 일부러 그렇게 만들어야 한다. “차원의 저주”라 부르는 문제(최근접 이웃이 무의미해지는 현상)의 다른 얼굴이다.
5. 한 줄 요약
고차원에서는 아무 두 벡터나 거의 직각이다 — 유사도의 폭이 로 줄기 때문이고(D=2048에서 0.022), 그래서 64차원에 16,384개의 방향을 평균 겹침 0.1로 담을 수 있다. 임베딩이 섞이지 않는 것도, 검색이 성립하는 것도, 중첩이 가능한 것도 전부 이 사실 위에 서 있다.
연결
- 중첩 · 토크나이저와 임베딩 · RAG · 비전 트랜스포머와 CLIP