인지야공/오늘의 AI 이슈/6번째 글
Jev — 글자를 안 만드는 모델은 왜 수백 배 싼가
실험:
python 딥러닝/daily/2026-09-21_jev_discriminative.py(torch 2.8.0, RTX 5080) 글의 수치는 전부 그 스크립트를 돌려 얻은 것이고, 사건 내용은 2026년 9월 21일까지의 자료로 교차 확인했다.
1. 무슨 일이 있었나
2026년 9월, TypeSafe AI 가 Jev 를 공개했다. 특이하게도 이 모델은 글자를 한 자도 만들지 않는다.
Jev 에게는 상태(판단할 데이터) 와 질문 + 허용된 답 목록을 준다. 그러면 모든 질문에 대한 각 답의 확률을 한 번의 패스로 돌려준다. 분류·라우팅·점수·분기 — 코드가 바로 쓰는 “똑똑한 if 문” 이 목표다. — TypeSafe AI, Jev
주장은 강하다 — 분류 과제에서 최대 200배 빠르고 400배 싸다(한 호출 70~500ms, 입력 100만 토큰당 $0.042, 출력은 무료). TypeSafe 는 이를 빠르고 구조적인 “System One”(직관) 모델이라 부른다. 느리게 생성하며 추론하는 보통 LLM(“System Two”)과 대비된다.
어떻게 그렇게 싼가? 마법이 아니라 생성(generation)을 안 하기 때문이다. 그 뼈대를 축소 모형으로 잰다.
2. 생성 vs 판별 — 답을 ‘쓰는가’ ‘고르는가’
보통 LLM 이 분류를 하는 방식은 생성이다. “이 메일은 스팸인가?”에 답하려면 "스팸"이라는 글자를 토큰씩
지어낸다. 이것이 자기회귀(autoregressive) 다.
| 기호 | 뜻 |
|---|---|
| 답의 토큰 수 | |
| 지금까지 만든 토큰들 | |
| 토큰을 하나씩 순서대로 — 앞 토큰을 봐야 다음을 만든다 |
핵심은 순차성이다. 개 토큰을 만들려면 순전파를 번 해야 한다(앞 토큰이 정해져야 다음을 계산).
판별(discriminative) 은 다르다. 답을 짓는 대신, 허용된 답 목록 위에서 확률을 한 번에 고른다.
순전파 한 번이면 끝이고, 결과는 곧바로 숫자(확률)라 글자를 파싱할 필요도 없다. Jev 가 하는 일이 이것이다.
3. 왜 싼가 ① — 생성 비용은 답 길이에 비례한다
직접 재 보기 A
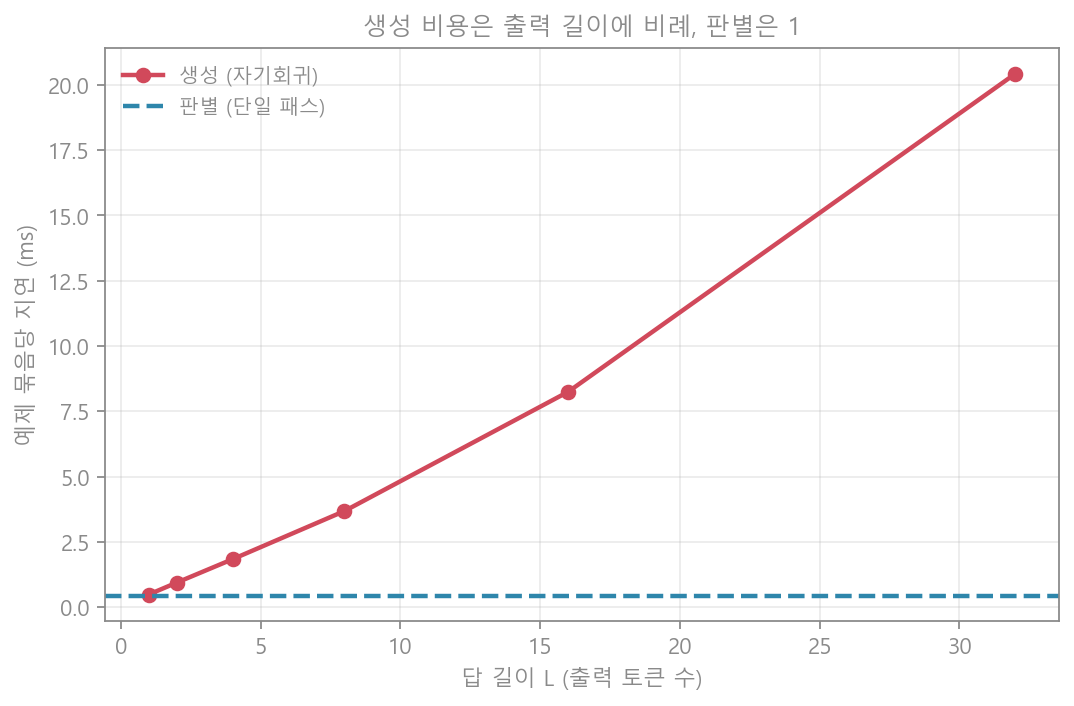
작은 트랜스포머로, 판별(단일 패스)과 생성(답 토큰을 자기회귀로) 지연을 쟀다(GPU 워밍업 후).
| 답 길이 | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|
| 생성 / 판별 배율 | 1.1× | 2.2× | 4.4× | 8.7× | 19.5× | 48.4× |
생성 비용은 답 길이에 비례해(그 이상으로) 커졌다 — 에서 판별의 48배. 판별은 답이 몇 자든 1패스로 평평하다. 실제 LLM 의 답은 추론 과정과 JSON 형식까지 붙어 수백~수천 토큰이니, 여기서만 이미 수백 배 차이가 난다. Jev 의 “200배”는 이 곱셈이 뼈대다.
4. 왜 싼가 ② — 정확도는 같은데 값만 다르다
“싼 대신 부정확한 것 아닌가?” 분류에 한해서는 아니다.
직접 재 보기 B
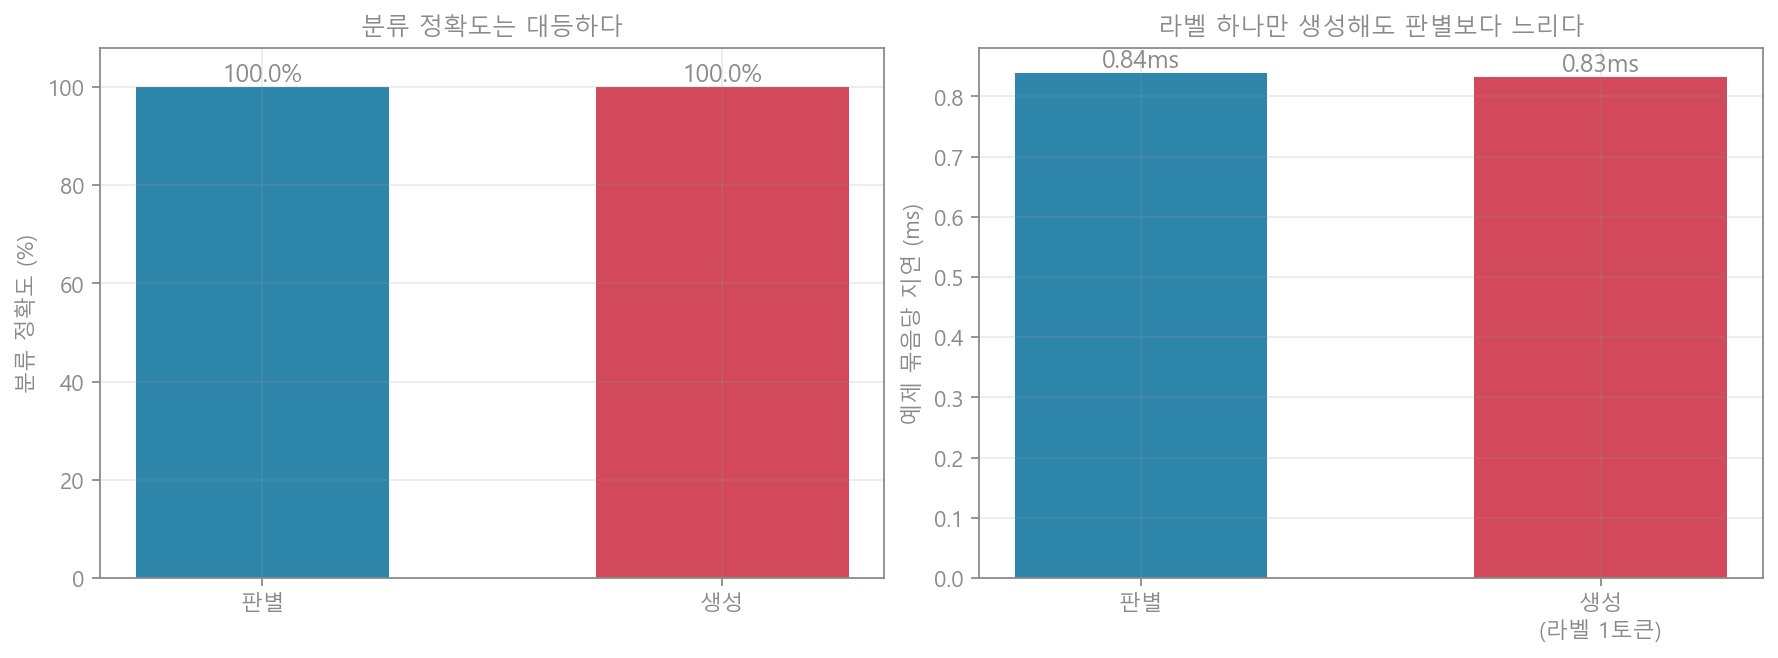
같은 분류 과제를 판별 모델과 생성 모델로 각각 학습시켰다.
| 분류 정확도 | 라벨 1토큰 지연 | |
|---|---|---|
| 판별 | 100.0% | 0.84 ms |
| 생성 | 100.0% | 0.83 ms |
둘 다 100% 로 대등했다. 분류는 애초에 “답을 고르는” 문제라, 답을 짓는 능력(생성)이 필요 없다. 생성 모델은 그 능력에 파라미터·계산을 쓰지만 분류 정확도로는 돌아오지 않는다. 그래서 Jev 처럼 판별에 특화한 작은 모델이 큰 생성 모델과 같은 정확도를 훨씬 싸게 낸다(작은 모델 + 짧은 1패스 + 출력 토큰 과금 없음이 겹쳐 “400배 싸다”가 된다).
5. 덤 — 판별은 틀린 형식을 낼 수 없다
생성 모델에게 “스팸 또는 정상만 답하라”고 해도, 확률은 전체 어휘 위에 퍼져 있어 엉뚱한 글자가 나올 수
있다(그래서 JSON 파싱 실패·재시도가 생긴다). 판별은 허용된 답 위에서만 softmax 라, 틀린 형식이 정의상 불가능하다.
직접 재 보기 C
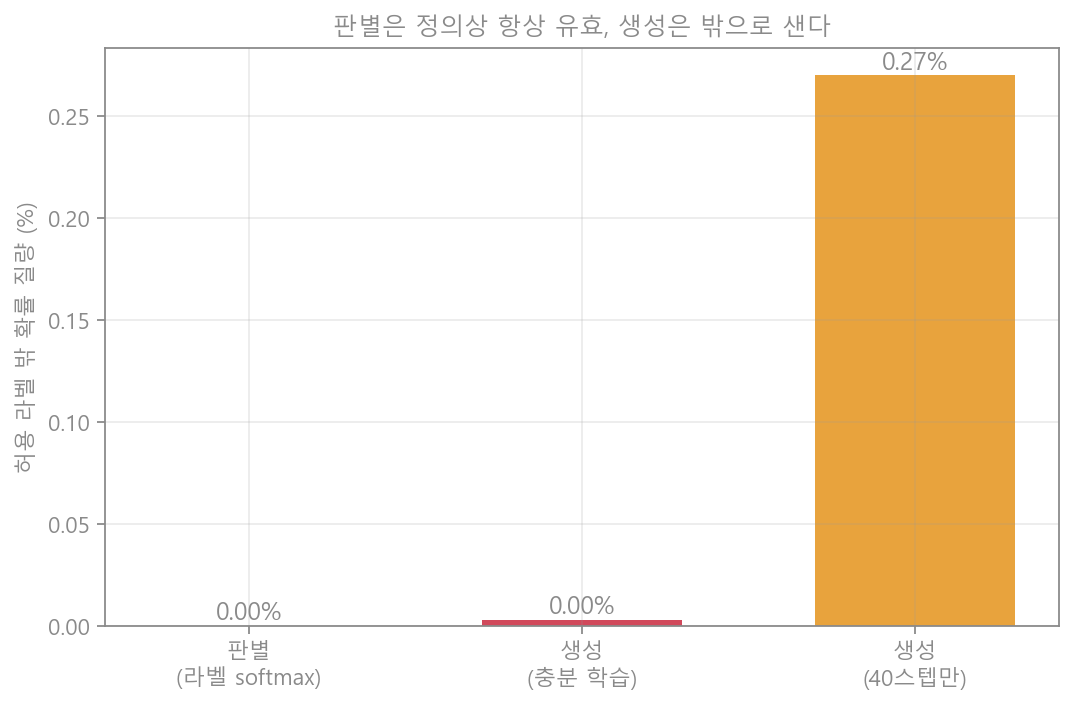
생성 모델이 허용 라벨 밖에 남긴 확률 질량을 쟀다.
| 허용 라벨 밖 확률 질량 | |
|---|---|
| 판별 (라벨 위 softmax) | 0.00% (구조적으로 불가능) |
| 생성 (충분히 학습) | ~0.00% (작지만 보장 없음) |
| 생성 (덜 학습) | 0.27% (덜 배우면 더 샌다) |
판별은 출력 공간이 허용된 답뿐이라 밖으로 샐 곳이 없다(0을 보장). 생성은 잘 학습하면 거의 0 이지만 보장은 못 하고, 덜 학습하거나 어휘가 크면 샌다. 코드가 결과를 바로 받아 분기해야 하는 자리에서, 이 타입 안전(type-safe) 이 Jev 의 이름값이다.
6. 흔한 오해와 한계
- “판별이 생성보다 우월하다” — 아니다. 판별은 답이 유한 목록일 때만 쓴다. 글쓰기·요약·번역·대화처럼 답을 지어내야 하는 일은 생성만 할 수 있다. Jev 는 LLM 을 대체하는 게 아니라 분기·라우팅을 떼어 맡는다.
- “200배는 항상” — 아니다. 답이 짧으면(1~2토큰) 배율도 작다(3절 표). 큰 배율은 답이 길 때, 그리고 모델이 작을 때 난다.
- 이 글의 실험 — Jev 재현이 아니다. 생성 vs 판별의 비용·구조 차이를 축소 모형으로 잰 것이다. 절대 수치가 아니라 “출력 길이에 비례” “정확도 대등” “밖 질량 0 보장” 같은 구조가 요점이다.
- 성능 주장은 제작사 발표 — 200배·400배는 TypeSafe 의 분류 벤치 기준이며 독립 검증은 별개다.
7. 한 문단 요약
Jev 는 글자를 만들지 않는 판별 모델이다. 보통 LLM 은 분류에도 답을 토큰씩 지어내(자기회귀) 답 길이 만큼 순전파를 반복하지만(재 보니 에서 판별의 48배), Jev 는 허용된 답 위 softmax 한 번으로 끝낸다. 분류 정확도는 둘 다 100% 로 같으니, 생성 능력은 분류에서 낭비다 — 그래서 작은 판별 모델이 같은 정확도를 훨씬 싸게 낸다(짧은 1패스 + 작은 모델 + 출력 과금 없음 = “400배”). 게다가 출력이 허용된 답뿐이라 틀린 형식이 정의상 불가능해(밖 질량 0 보장), 코드가 결과를 바로 분기에 쓸 수 있다. 요약하면 Jev 는 LLM 을 대체하는 게 아니라, “답이 유한 목록인 결정” 을 생성에서 떼어내 빠르고 안전하게 만든 것이다.