인지야공/수학·공학 노트/6번째 글
산술 강도와 메모리 대역폭 — 왜 GPU가 놀고 있나
실행:
python 딥러닝/mathnotes/M3_roofline.pyKV 캐시 편·플래시 어텐션 편의 “메모리에 묶인다”를 정리한다.
1. 산술 강도
GPU 는 초당 수십조 번 계산할 수 있지만, 그 계산에 쓸 데이터를 메모리에서 읽어 와야 한다. 연산이 데이터를 얼마나 재활용하는지를 재는 것이 산술 강도(arithmetic intensity) 다.
- 높으면(데이터 하나로 계산 많이): 계산에 묶인다(compute-bound). GPU의 계산기가 바쁘다.
- 낮으면(데이터 읽고 조금만 계산): 메모리에 묶인다(memory-bound). GPU가 데이터를 기다린다.
2. 직접 재 보기
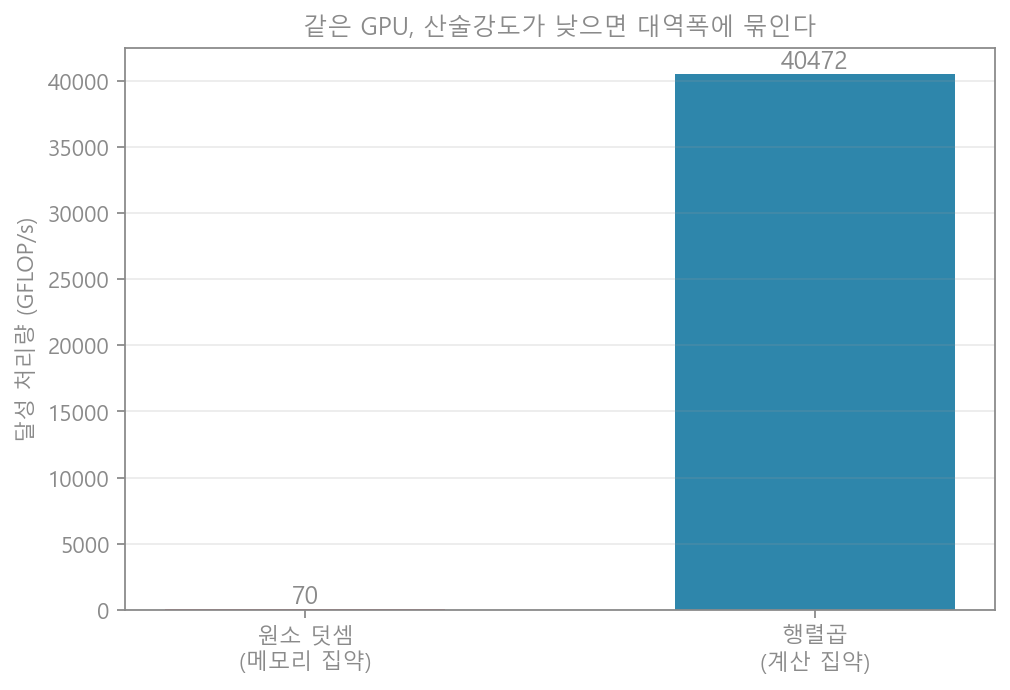
같은 GPU에서 행렬곱(산술 강도 높음)과 원소별 덧셈(낮음)의 달성 처리량을 쟀다.
| 연산 | 산술 강도 | 달성 처리량 |
|---|---|---|
| 행렬곱 | ~683 FLOP/byte | 40,472 GFLOP/s |
| 원소별 덧셈 | ~0.08 FLOP/byte | 70 GFLOP/s |
같은 GPU인데 577배 차이다. 행렬곱은 데이터 하나를 여러 번 재활용해 계산기를 꽉 채우지만, 원소별 덧셈은 읽고 한 번 더하고 쓰니 대역폭이 천장이다 — 계산기는 놀고 메모리만 바쁘다. 이 둘의 천장을 한 그림에 그린 것이 루프라인(roofline) 모델이다.
3. 왜 딥러닝에 중요한가
- 생성/추론(KV 캐시 편): 토큰 하나를 만들 때 거대한 가중치·KV 캐시를 읽는데 계산은 적다 → 메모리에 묶인다. 그래서 양자화(읽을 바이트↓)·KV 헤드 공유가 곧 속도다.
- 플래시 어텐션(플래시 어텐션 편): N×N 점수 행렬을 메모리에 쓰고 읽는 것이 병목이라, 아예 안 만들고(IO를 줄여) 빨라진다. 계산량은 비슷한데 메모리 접근을 줄인 것이다.
- 학습: 큰 배치 행렬곱은 계산에 묶여 GPU를 꽉 쓴다.
4. 한 줄 요약
산술 강도 = 연산량 / 메모리 접근량. 낮으면 GPU가 계산이 아니라 데이터 읽기를 기다린다(memory-bound). 재 보니 행렬곱(높음)은 원소별 덧셈(낮음)보다 577배 빨랐다. LLM 추론이 느리고 비싼 것은 대부분 이 대역폭 병목 때문이고, 양자화·플래시 어텐션·KV 공유가 모두 그것을 푸는 장치다.