인지야공/오늘의 AI 이슈/8번째 글
Meta 뮤즈 — 대신 해 주는 에이전트는 언제 물어봐야 하나
실행:
python 딥러닝/daily/DAILY_2026_09_25_muse_delegation.py이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
1. 무슨 일이 있었나
메타가 9월 8일 개인 AI 에이전트 뮤즈(Muse) 를 공개했다(Axios, 메타 공식). 질문에 답하는 것이 아니라 대신 일을 하는 것을 내세웠다 — 약속을 잡고, 물건을 사고, 일정을 정리한다.
9월 23일 커넥트 콘퍼런스에서 후속 발표가 이어졌다.
- 손바닥만 한 전용 기기(“Muse Charm”)를 내놓았다(Bloomberg)
- 월마트·베스트바이·갭·세포라·익스피디아·인스타카트·웨이페어와 연동한다(TechCrunch)
- AI 안경에서도 쓸 수 있고, 목소리를 고를 수 있으며, 캐나다로 확대된다
출시 뒤 250만 건 이상 내려받아 아이폰 앱스토어 무료 1위에 올랐다고 보도됐다(CNBC, CNN).
여기서 기술적으로 새로운 질문이 하나 생긴다. 연동 목록이 쇼핑과 예약이라는 점이 핵심이다. 검색 결과가 틀리면 다시 검색하면 된다. 그런데 결제와 예약은 되돌릴 수 없다.
에이전트와 도구 사용 편에서 에이전트가 스스로 관측하고 재시도하면 사슬이 되살아난다는 것을 쟀다. 이 글은 그 다음 질문이다 — 사람에게는 언제 물어야 하나.
2. 핵심 개념 — 묻는 것도 비용이다
양 끝은 쉽다. 그리고 둘 다 쓸모가 없다.
- 한 번도 안 묻는다: 빠르지만 되돌릴 수 없는 실수가 그대로 나간다.
- 매 단계 묻는다: 안전하지만 내가 다 확인할 거면 위임한 것이 아니다.
그래서 실제 설계는 가운데다. 에이전트가 자기 확신이 낮을 때만 묻는 것.
| 기호 | 뜻 |
|---|---|
| 번째 단계에서 에이전트가 가진 확신 (0~1) | |
| 문턱. 높을수록 자주 묻는다 | |
| 비가역 | 되돌릴 수 없는 단계(결제·예약)의 비율 |
이 한 줄이 제대로 동작하려면 조건이 하나 붙는다. 가 진짜여야 한다. “90% 확신한다”고 말할 때 실제로 90% 맞아야 한다는 것 — 캘리브레이션 편에서 쟀던 바로 그 성질이다. 그게 무너지면 어떻게 되는지를 아래에서 잰다.
3. 직접 재 보기
예약 한 건을 8단계(검색 → 비교 → 선택 → 일정 확인 → 결제 → 확인 → 달력 → 알림)로 놓고 4만 건을 돌렸다. 한 단계가 저절로 잘 될 확률은 92%이고, 그중 25%는 되돌릴 수 없는 단계다. 사람이 물음에 답하면 그 단계는 고쳐진다.
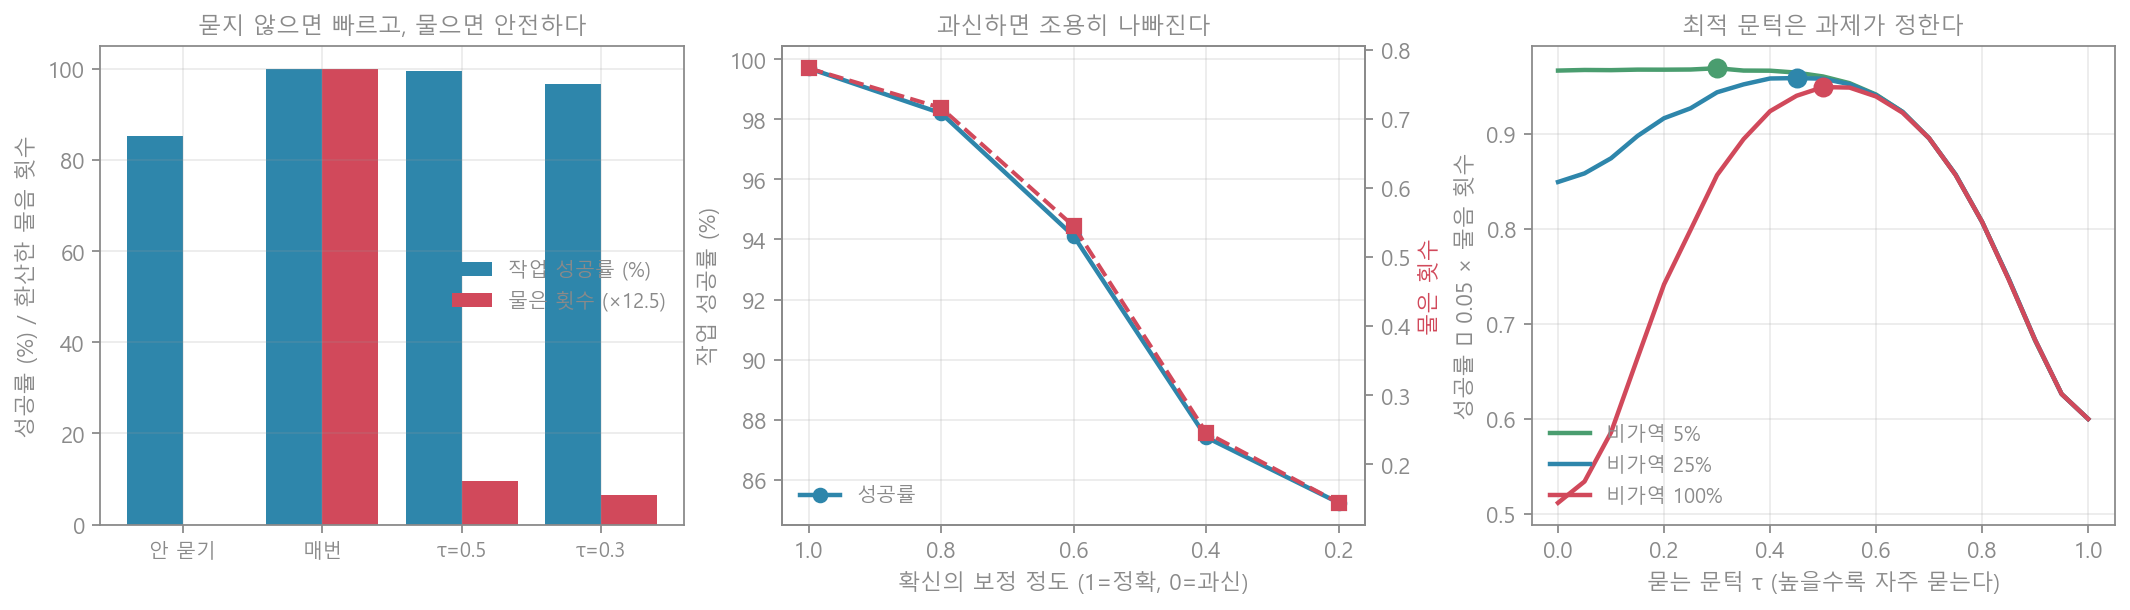
[A] 세 가지 정책
| 정책 | 작업 성공률 | 사람에게 물은 횟수 | 그중 헛물음 |
|---|---|---|---|
| 아예 안 묻는다 | 85.2% | 0.00회 | — |
| 매 단계 묻는다 | 100.0% | 8.00회 | 7.36회 |
| 확신 < 0.5 일 때만 | 99.7% | 0.77회 | 0.14회 |
| 확신 < 0.3 일 때만 | 96.7% | 0.51회 | 0.00회 |
매번 묻는 방식의 문제가 “느리다”가 아니다. 8번 물어서 그중 7.36번이 헛물음이다. 이미 잘 된 일을 확인해 달라고 부른 것이다. 사람은 곧 대충 “예”를 누르기 시작하고, 그러면 확인은 형식만 남는다.
확신이 낮을 때만 묻자 0.77회로 99.7% 가 나왔다. 물음을 10분의 1로 줄이면서 성공률은 0.3%p만 내줬다.
[B] 확신이 어긋나면 — 조용히 나빠진다
같은 정책()을 두고 에이전트의 확신이 실제와 얼마나 맞는지만 바꿨다.
| 확신의 보정 정도 | 작업 성공률 | 물은 횟수 |
|---|---|---|
| 1.0 (정확) | 99.7% | 0.77회 |
| 0.8 | 98.2% | 0.72회 |
| 0.6 | 94.1% | 0.55회 |
| 0.4 | 87.4% | 0.25회 |
| 0.2 (심한 과신) | 85.2% | 0.14회 |
두 열이 같은 방향으로 움직이는 것이 이 표의 핵심이다. 보정이 무너지면 성공률이 99.7%에서 85.2%로 떨어지는데, 묻는 횟수도 0.77에서 0.14회로 줄어든다.
쓰는 사람 입장에서는 에이전트가 덜 귀찮게 구는 것처럼 느껴진다. 실제로는 틀리면서도 확신에 차서 그냥 지나가고 있다. 85.2%는 공교롭게도 [A]의 “아예 안 묻는다”와 같은 값이다 — 과신이 충분히 심하면 묻는 기능이 있으나 마나가 된다.
[C] 되돌릴 수 없는 일이 많을수록 더 자주 물어야 한다
문턱 를 0부터 1까지 훑으며, “성공 1건 = 1, 물음 1회 = −0.05”로 점수를 매겨 가장 좋은 를 찾았다.
| 비가역 단계 비율 | 최적 문턱 τ | 그때 성공률 | 물은 횟수 |
|---|---|---|---|
| 5% | 0.30 | 99.5% | 0.52회 |
| 15% | 0.40 | 99.5% | 0.62회 |
| 25% | 0.45 | 99.3% | 0.68회 |
| 50% | 0.50 | 99.3% | 0.77회 |
| 100% | 0.50 | 98.8% | 0.76회 |
되돌릴 수 있는 일만 있으면 으로 느슨하게 둬도 된다. 잘못돼도 뒤에서 고치면 되니까. 되돌릴 수 없는 일이 절반이면 까지 올라간다.
문턱은 모델이 정하는 것이 아니라 과제가 정한다. 장바구니에 담는 것과 결제 버튼을 누르는 것에 같은 문턱을 쓰면 안 된다는 뜻이고, 뮤즈가 익스피디아·인스타카트와 연동한다는 발표가 정확히 이 지점을 건드린다.
4. 흔한 오해와 한계
1. “확인을 많이 받을수록 안전하다” — 횟수가 아니라 어디서 받느냐가 안전을 만든다. 매 단계 확인은 100%를 주지만 헛물음이 7.36회다. 사람의 주의는 무한하지 않아서, 형식적인 확인이 반복되면 실제로 중요한 확인까지 흘려보낸다.
2. “에이전트가 스스로 재시도하면 된다” — 에이전트와 도구 사용 편에서 쟀듯 그 회복은 되돌릴 수 있을 때만 작동한다. 결제·예약에는 적용되지 않는다. 그 편의 폐루프와 이 글의 물어보기는 서로 다른 실패를 막는 장치다.
3. 이 실험은 축소 모형이다 — 단계 성공률 92%, 8단계, 비가역 25%는 내가 정한 값이다. 실제 뮤즈의 수치가 아니다. 이 글이 보이는 것은 특정 숫자가 아니라 세 양(성공률·물음 횟수·비가역 비율)이 맞물리는 방식이다.
4. 확신을 어디서 얻나 — 실험에서는 확신을 주어진 것으로 놓았지만, 실제로 잘 보정된 확신을 얻는 일 자체가 어렵다. 캘리브레이션 편에서 봤듯 모델은 대체로 과신하는 쪽으로 틀린다 — 즉 [B]의 나쁜 쪽이 기본값에 가깝다.
5. 물음의 값어치도 상황마다 다르다 — [C]에서 물음 한 번을 0.05로 놓았는데, 이 값이 곧 최적 문턱을 정한다. 운전 중이라 답하기 어려우면 비용이 커지고, 책상 앞이면 작아진다. 전용 기기와 안경으로 확장한다는 발표는 이 비용을 낮추려는 시도로도 읽힌다.
5. 한 문단 요약
에이전트가 답하는 대신 행동하기 시작하면 “언제 사람에게 물어야 하나”가 설계 문제가 된다. 양 끝은 쓸모가 없다 — 안 물으면 85.2%이고, 매 단계 물으면 100%지만 8번 중 7.36번이 헛물음이라 위임이 아니다. 확신이 낮을 때만 묻자 0.77회로 99.7% 가 나왔다. 다만 이 방식은 확신이 진짜라는 가정 위에 서 있다. 확신이 어긋나자 성공률이 85.2%로 떨어지면서 묻는 횟수도 0.14회로 같이 줄었다 — 덜 귀찮아진 것처럼 보이지만 실은 틀린 채로 지나가는 것이다. 그리고 최적 문턱은 되돌릴 수 없는 단계의 비율이 정한다(5%면 τ=0.30, 50%면 τ=0.50). 뮤즈가 연동한다는 목록이 쇼핑과 예약이라는 점, 즉 되돌릴 수 없는 행동이라는 점이 이 글의 전부다.