인지야공/수학·공학 노트/1번째 글
고유값·고유벡터 — 반복 곱의 운명
실행:
python 딥러닝/mathnotes/M4_eigen.py정규화와 잔차 편·상태공간모델·선형 어텐션 편의 공통 뿌리다.
1. 한 줄 정의
대부분의 방향은 행렬 를 곱하면 방향도 크기도 바뀐다. 그런데 어떤 특별한 방향은 크기만 바뀐다.
이 방향 가 고유벡터, 그 배율 가 고유값이다. 행렬이 그 방향으로 얼마나 늘이나(줄이나)를 나타낸다.
2. 왜 중요한가 — 반복 곱의 운명을 정한다
행렬을 여러 번 곱하면(재귀·깊은 층), 결과는 가장 큰 고유값의 방향으로 쏠리고 크기는 로 변한다.
직접 재 보기
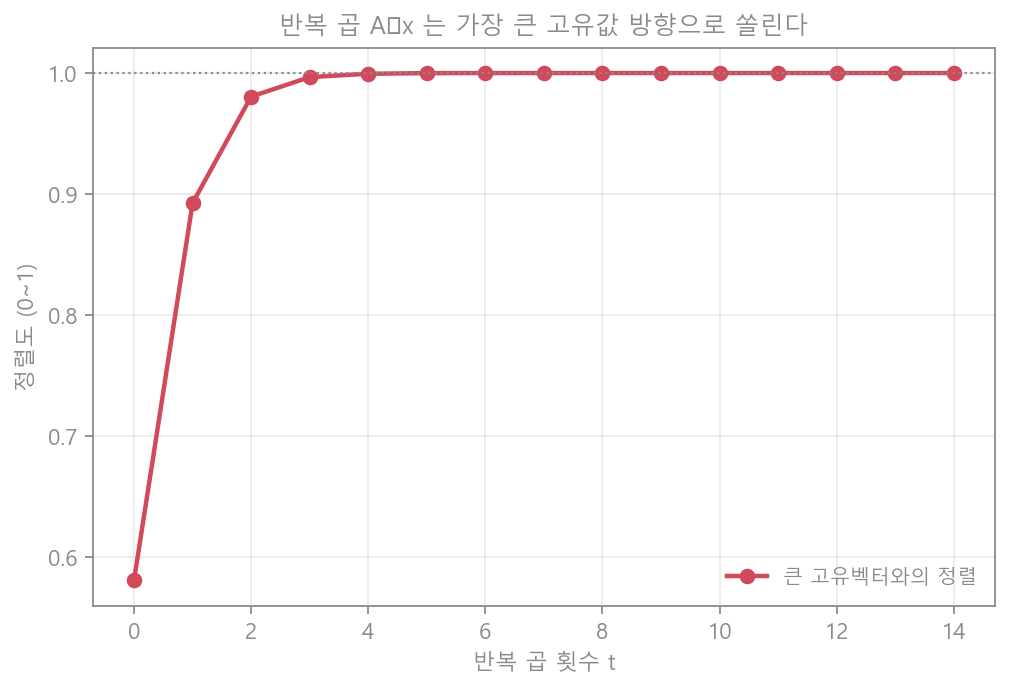
행렬(고유값 )에 임의 벡터를 반복해 곱했다.
| 결과 | |
|---|---|
| 큰 고유벡터와의 정렬 | 0.58 → 1.0 (완전 정렬) |
| 크기 비 | → 1.69 (= 최대 고유값) |
반복 곱은 최대 고유값 방향으로 쏠리고, 매번 그 배만큼 커진다(작아진다). 이것이 딥러닝 여러 현상의 뿌리다.
3. 어디에 나오나
- 그라디언트 소실·폭발(정규화와 잔차 편): 층을 쌓으면 야코비안이 반복 곱해져, 고유값이 1보다 작으면 (소실), 크면 (폭발).
- SSM 기억(상태공간모델·선형 어텐션 편): 재귀 의 임펄스 응답은 — 여기서 가 곧 (1×1) 고유값이고, 에 가까울수록 오래 기억한다.
- 조건수(최적화 편): 최대/최소 고유값의 비 가 최적화의 어려움을 정한다.
- PageRank·PCA: 가장 큰 고유값의 고유벡터가 곧 답이다.
4. 한 줄 요약
고유값은 행렬이 크기만 바꾸는 방향(고유벡터)의 배율이다. 행렬을 반복 곱하면 결과는 최대 고유값 방향으로 쏠리고 크기는 로 변한다. 그래서 고유값이 1보다 크냐 작냐가 그라디언트 소실·폭발, SSM 기억 길이, 최적화 난이도를 모두 좌우한다.
연결
- 정규화와 잔차 · 최적화 · 상태공간모델·선형 어텐션