인지야공/수학·공학 노트/9번째 글
엔트로피와 KL 발산 — 분포로 가르친다는 것
실행:
python 딥러닝/mathnotes/M9_kl.py지식 증류 편·RLHF와 DPO 편· 디코딩과 샘플링 편의 바탕이다.
1. 엔트로피 — 얼마나 모르는가
확률 분포 하나가 담은 불확실성의 양이다.
전부 똑같이 그럴듯하면 최대이고, 하나로 확정되면 0이다. 클래스 12개로 재 봤다.
| 분포 | 엔트로피 |
|---|---|
| 균등 (전부 1/12) | 2.4849 nat = (최대) |
| 교사의 soft 분포 | 1.2668 nat |
| 정답 하나(원-핫) | 0 nat |
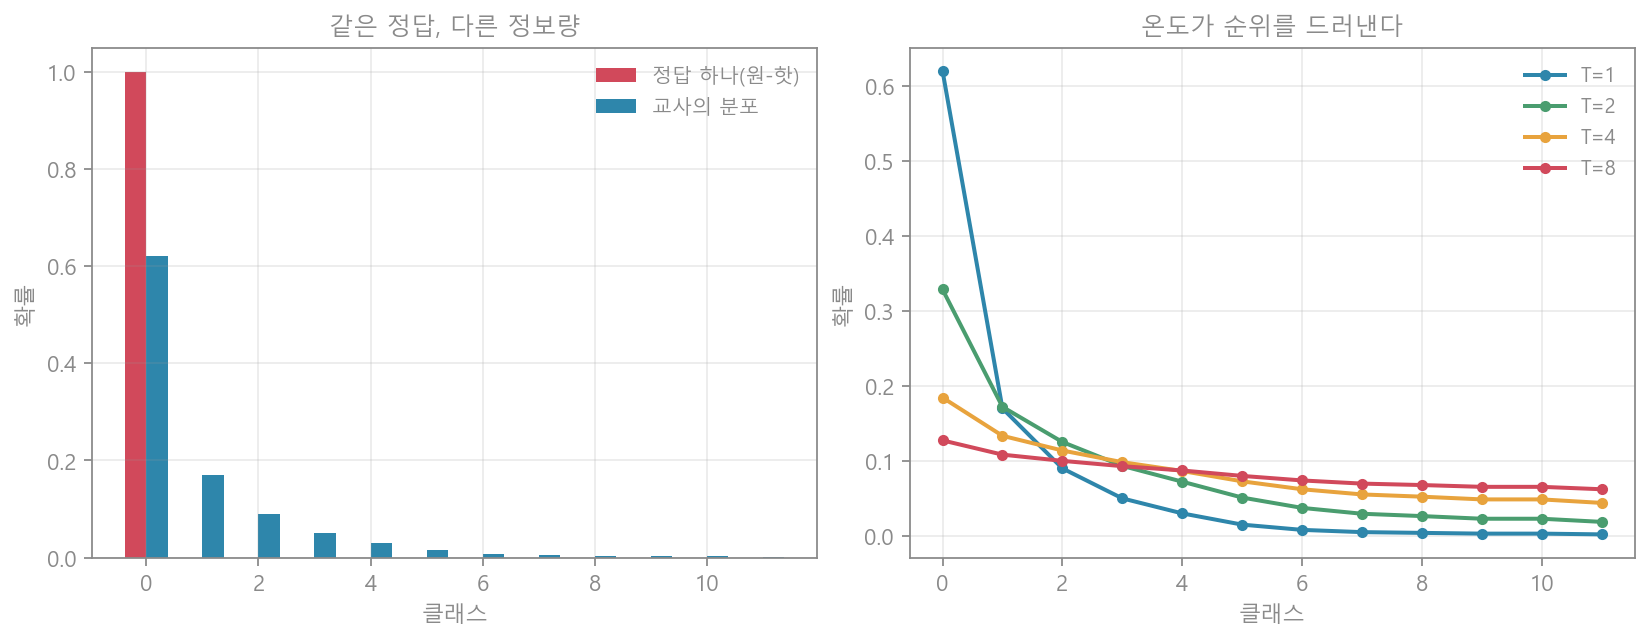
여기에 지식 증류 편의 핵심이 있다. 원-핫 라벨의 엔트로피는 0이다 — “정답은 3번”이라고만 말하고 나머지 11개에 대해서는 아무 말도 하지 않는다. 반면 교사의 분포는 “3번이 맞지만 5번도 꽤 그럴듯하고 9번은 전혀 아니다”까지 말한다. 같은 정답에 정보량이 다르다.
2. KL 발산 — 틀린 분포를 믿는 값
가 진짜인데 라고 믿으면 얼마나 손해인가.
| 기호 | 뜻 |
|---|---|
| 참(또는 교사)의 분포 | |
| 내가 믿는(학생의) 분포 |
| 잰 것 | 값 |
|---|---|
| KL(교사 ‖ 비슷한 학생) | 0.0170 |
| KL(교사 ‖ 균등) | 1.2181 |
| KL(균등 ‖ 교사) | 1.5852 |
| KL(p ‖ p) | 0.0000 |
순서를 바꾸면 값이 다르다(1.2181 vs 1.5852). 그래서 KL은 거리가 아니다. 이 비대칭은 실무에서 성격 차이로 나타난다 — 는 가 있는 곳에 가 없으면 크게 벌하므로 넓게 덮으려 하고(mode-covering), 반대 방향은 가 한 봉우리에만 몰리게 한다(mode-seeking).
교차엔트로피와의 관계
실측으로 확인했다 — 1.2838 = 1.2668 + 0.0170. 즉 우리가 쓰는 교차엔트로피 손실은 “어쩔 수 없는 불확실성 + 내 분포가 틀린 만큼”이고, 학습으로 줄일 수 있는 것은 뒷조각뿐이다. 라벨이 원-핫이면 이라 교차엔트로피가 곧 KL이 된다. 증류에서 KL을 손실로 쓰는 것이 자연스러운 이유다.
3. 온도 — 순위를 드러내는 손잡이
교사의 분포에서 정답의 확률이 0.62라면, 나머지 0.38 안의 순위가 우리가 옮기고 싶은 정보다. 그런데 그 값들이 너무 작아 손실에 거의 기여하지 못한다. 그래서 온도로 분포를 편다 (디코딩과 샘플링 편의 그 온도다).
| 온도 | 0.5 | 1.0 | 2.0 | 4.0 | 8.0 |
|---|---|---|---|---|---|
| 1등 확률 | 0.904 | 0.620 | 0.329 | 0.184 | 0.127 |
| 2등/1등 비율 | 0.075 | 0.274 | 0.524 | 0.724 | 0.851 |
| 엔트로피 | 0.399 | 1.267 | 2.061 | 2.376 | 2.459 |
에서 2등은 1등의 27%지만, 에서는 72%가 된다. 오답들 사이의 순위가 그제야 손실에 제대로 들어간다. 다만 쯤 가면 거의 균등(엔트로피 2.459 ≈ 최대 2.485)이라 정보가 아니라 잡음이 된다. 증류에서 온도를 하이퍼파라미터로 조정하는 이유이고, 지식 증류 편에서 온도를 올릴수록 오히려 나빠진 경우도 그래서 생긴다.
4. 한 줄 요약
엔트로피는 분포가 담은 불확실성이고(원-핫은 0, 그래서 정보가 적다), KL 발산은 틀린 분포를 믿는 값이며 거리가 아니다(1.2181 vs 1.5852). 둘을 더하면 우리가 쓰는 교차엔트로피가 된다(1.2838 = 1.2668 + 0.0170). 온도는 이 분포를 펴서 오답들 사이의 순위를 손실에 드러내는 손잡이다(2등/1등이 0.27에서 0.72로).