인지야공/딥러닝 기초 정리/14번째 글
스케일링 법칙 — 파라미터·데이터·계산의 균형
실행:
python NN_14_scaling_laws.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 최적화 편이 ‘어떻게 학습하나’였다면, 이 글은 ‘얼마나 키워야 하나’다.
앞 편들(정규화·최적화, 토크나이저)로 모델을 학습시키고 텍스트를 넣는 법을 갖췄다. 이제 실전의 질문 — 얼마나 키워야 하나? 모델을 키울까, 데이터를 늘릴까, 계산을 더 쓸까. 놀랍게도 이 셋과 손실의 관계는 깔끔한 멱법칙을 따르고, 그래서 미리 계산할 수 있다. 이것이 스케일링 법칙이다.
1. 손실은 멱법칙으로 준다
모델 파라미터 , 데이터 , 계산 를 늘리면 손실 이 준다. 그 줄어드는 모양이 멱법칙이다.
| 기호 | 뜻 |
|---|---|
| 손실 (낮을수록 좋음) | |
| 모델 파라미터 수 | |
| 학습 데이터(토큰) 수 | |
| 멱법칙 지수 — 클수록 키운 보람이 크다 |
멱법칙의 특징은 로그-로그 축에서 직선이라는 것이다. . 그래서 작은 규모 몇 점만 재도 기울기()를 재서 큰 규모를 외삽할 수 있다.
직접 재 보기 A · B
고정된 큰 교사망(참 함수)을 학생망이 흉내 내게 하고, ① 데이터를 넉넉히 두고 모델 폭만 키우거나 ② 모델을 고정하고 데이터만 늘려 시험 손실을 쟀다.
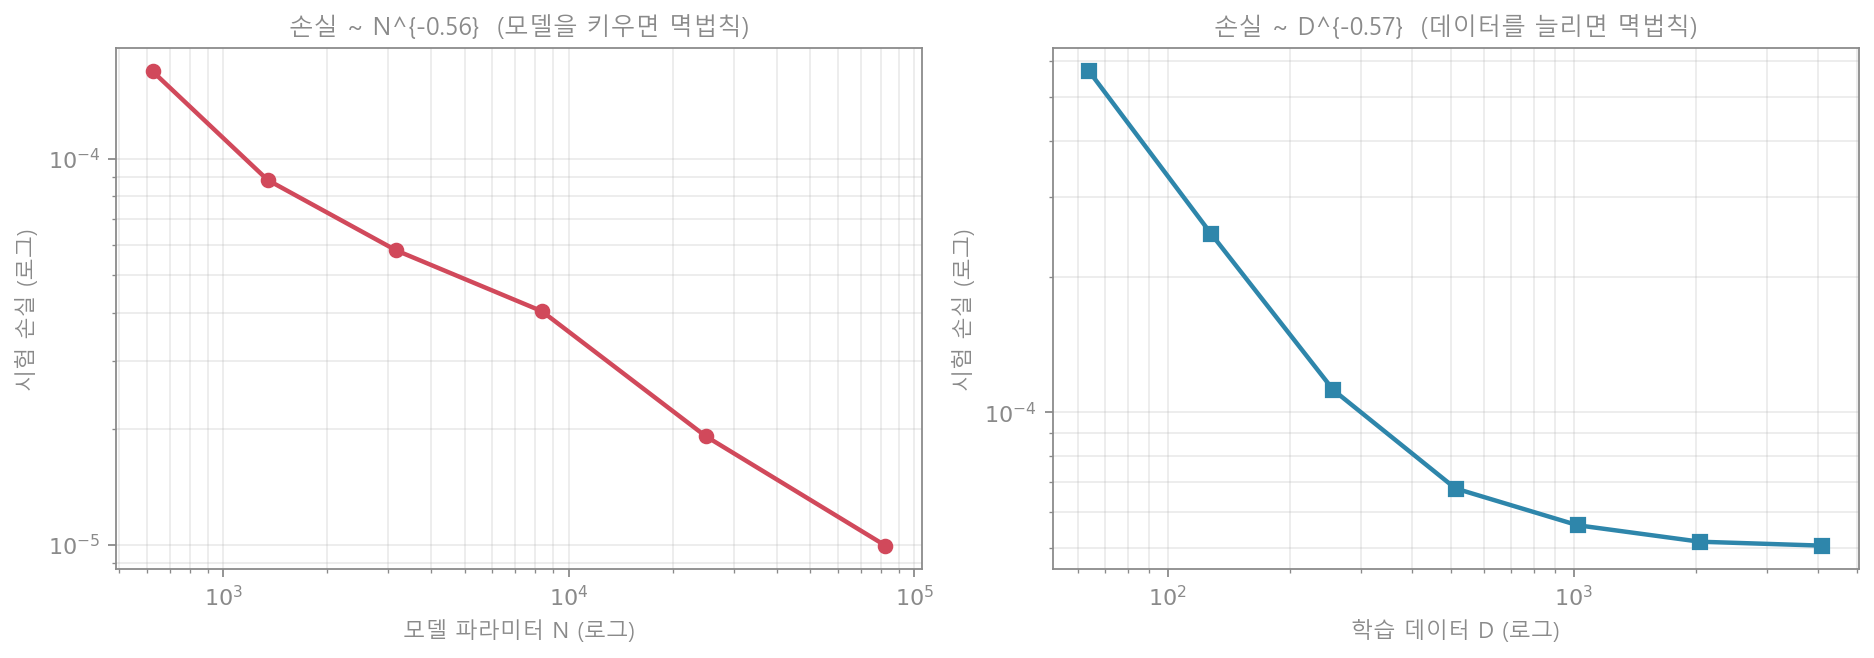
| 모델 파라미터 | 624 | 3,168 | 24,864 | 82,464 |
|---|---|---|---|---|
| 시험 손실 | 1.7e-4 | 6e-5 | 2e-5 | 1e-5 |
| 데이터 | 64 | 256 | 1,024 | 4,096 |
|---|---|---|---|---|
| 시험 손실 | 5.7e-4 | 1.1e-4 | 6e-5 | 5e-5 |
둘 다 로그-로그에서 거의 직선이었다 — 손실 ~ , 손실 ~ 모델을 키우든 데이터를 늘리든 손실은 예측 가능하게 준다. 다만 한쪽만 키우면 결국 다른 쪽이 병목이 된다(데이터 그래프 오른쪽 끝이 완만해지는 것 — 모델이 작아 더 배울 게 없다).
2. 계산은 유한하다 — C ≈ 6ND
무한히 키울 수는 없다. 실제로 정해진 것은 계산 예산 (GPU·시간·돈)다. 트랜스포머의 계산량은 간단한 어림식을 따른다.
| 기호 | 뜻 |
|---|---|
| 총 계산량 (FLOPs) | |
| 토큰 하나·파라미터 하나당 대략 6번 연산 (순전파 2 + 역전파 4) | |
| 파라미터 수 × 처리한 토큰 수 |
핵심은 가 과 의 곱이라는 것이다. 예산이 정해지면, 큰 모델을 적은 데이터로 돌리거나(큰 ·작은 ) 작은 모델을 많은 데이터로 돌릴(작은 ·큰 ) 수 있다 — 어떻게 나누느냐가 문제다.
3. 계산-최적 배분 — 골짜기를 찾는다
같은 예산 에서 을 바꾸면 이 자동으로 정해진다. 이 너무 크면 데이터가 부족해 덜 배우고, 이 너무 작으면 모델이 부족하다. 그 사이에 손실이 최저인 계산-최적 지점이 있다.
직접 재 보기 C
매 스텝 새 샘플을 뽑아(무한 데이터) 처리한 토큰 수가 곧 가 되게 하고, 예산 를 고정한 채 을 훑었다.
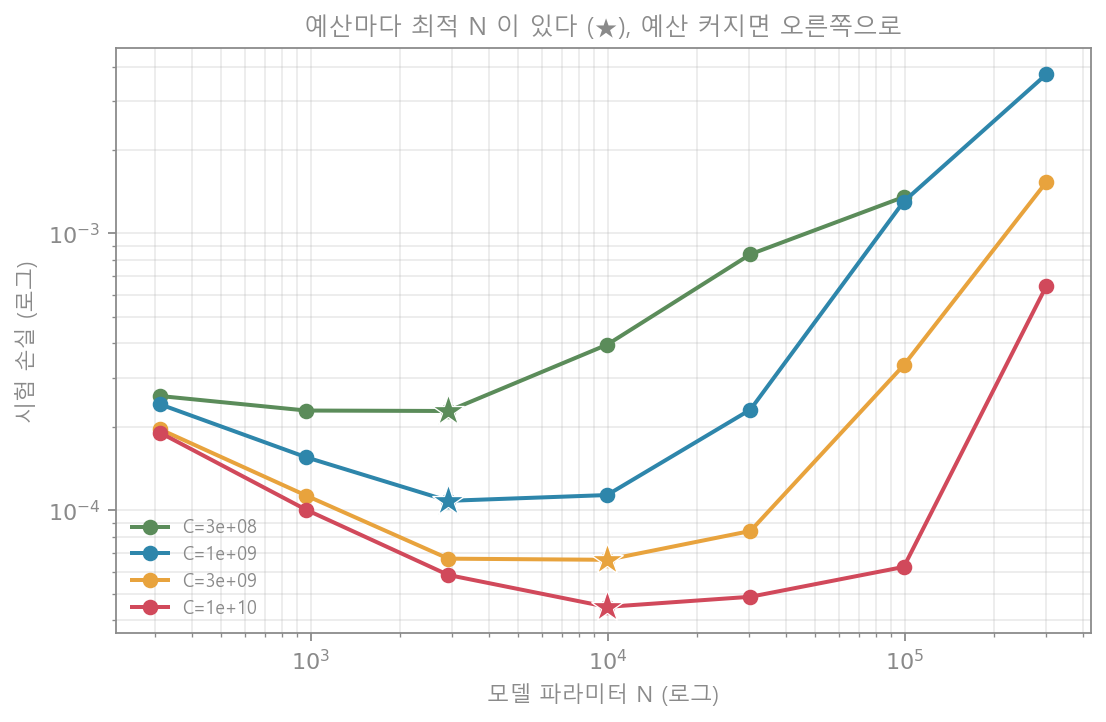
각 예산마다 U자 골짜기가 생기고(★ = 최저점), 예산이 커지면 골짜기가 오른쪽으로 옮겨 간다. 최적점만 모으면:
| 계산 예산 | 3e8 | 1e9 | 3e9 | 1e10 |
|---|---|---|---|---|
| 최적 | 2,912 | 2,912 | 9,968 | 9,968 |
| 최적 | 17,170 | 57,234 | 50,160 | 167,201 |
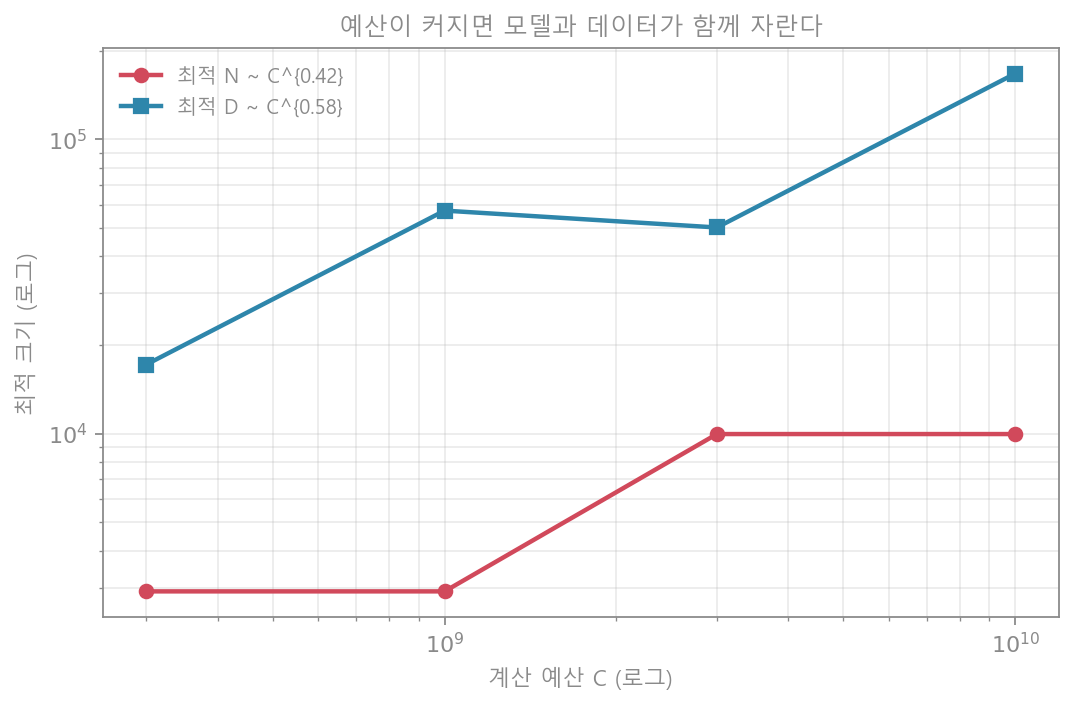
예산이 커지면 최적 과 가 함께 자란다 — 재 보니 , (지수의 합이 정확히 1인데, 라 당연하다). 둘이 대략 반반으로 자란다는 뜻이다.
4. 친칠라의 교훈 — 모델만 키우지 마라
이 “반반”이 실제 역사에서 중요했다. 2020년 카플란 팀의 첫 스케일링 법칙은 예산을 주로 모델 크기에 쓰라고 읽혔고, 그래서 거대 모델(GPT-3 175B 등)이 쏟아졌다. 2022년 딥마인드의 친칠라 논문이 이를 바로잡았다.
당시 큰 모델들은 데이터가 부족했다. 같은 예산이면 모델을 줄이고 데이터를 늘리는 편이 낫다.
친칠라(70B, 1.4조 토큰)는 3배 더 큰 고퍼(280B)를 이겼다. 계산-최적은 파라미터당 약 20토큰 근처였다 — 모델과 데이터를 함께 키우라는 것. 3절에서 잰 , 이 바로 그 “함께”의 축소판이다.
5. 흔한 오해와 한계
- “크면 무조건 좋다” — 예산이 고정이면 아니다. 데이터가 못 따라오면 큰 모델은 덜 배운다(3절 U자의 오른쪽).
- “멱법칙은 영원하다” — 아니다. 데이터가 바닥나거나(고품질 텍스트 유한) 손실이 비축소 항(잡음 바닥, 최적화 편 참고)에 닿으면 꺾인다. 멱법칙은 그 전 구간의 이야기다.
- “6ND 는 정확한 값” — 어림식이다. 어텐션·정규화·활성화 등이 빠졌지만, 규모를 가늠하는 데는 충분하다.
- 추론 비용은 별개 — 친칠라는 학습 계산 최적이다. 오래 쓸 모델은 추론이 싸도록 일부러 작게(데이터를 더) 만들기도 한다(예: 작은 모델을 아주 많은 토큰으로).
- 이 글의 실험 — 언어가 아니라 합성 회귀다. 지수 값(0.56 등)은 과제마다 다르다. 중요한 건 멱법칙 모양과 계산-최적 골짜기라는 구조다.
6. 한 문단 요약
손실은 모델·데이터·계산을 키우면 멱법칙으로 준다(재 보니 , , 로그-로그 직선). 그래서 작은 실험으로 큰 규모를 예측할 수 있다. 그런데 계산은 유한하고 라 과 의 곱이므로, 예산을 어떻게 나누느냐가 문제다. 고정 예산에서 을 훑으면 손실에 U자 골짜기가 생기고(너무 크면 데이터 부족, 너무 작으면 모델 부족), 그 최저가 계산-최적 배분이다. 예산이 10배 커질 때 최적 과 는 · 로 함께 자랐다 — 모델만 키우던 시절을 뒤집은 친칠라의 교훈(“파라미터당 약 20토큰, 데이터도 같이 키워라”)이 이 축소 실험에 그대로 나타났다. 스케일링 법칙은 “더 부으면 나아진다”를 넘어 얼마를 어디에 부을지를 계산하게 해 준다.