인지야공/딥러닝 기초 정리/48번째 글
차등 프라이버시 — 기억하지 못하게 만들기
실행:
python NN_45_privacy.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 함께 보면 좋은 글: 데이터 편
데이터 편에서 중복된 데이터가 암기를 부추긴다는 것을 봤다. 그 암기가 남기는 문제가 있다 — 모델이 학습에 쓴 사람의 정보를 흘릴 수 있다. “이 사람의 기록이 학습에 쓰였나”를 맞힐 수 있다면, 그 자체가 이미 정보 유출이다.
1. 무엇을 보장하려는 건가 — 그림으로 먼저
차등 프라이버시의 정의는 한 문장이다 — 한 사람이 데이터에 있든 없든, 결과의 분포가 거의 같아야 한다.
방법도 그림 그대로다. 한 사람이 학습에 미칠 수 있는 영향을 미리 잘라 두고(클리핑), 그 크기에 비례하는 잡음을 더한다. 그러면 한 사람이 있든 없든 결과가 잡음에 묻힌다.
| 기호 | 뜻 |
|---|---|
| 한 사람만 다른 두 데이터셋 | |
| 학습 절차(무작위성을 포함한다) | |
| 두 경우의 확률이 몇 배까지 달라도 되는가. 작을수록 강한 보장 | |
| 그 보장이 깨질 확률(여기서는 ) | |
| 클리핑 상한. 한 사람의 그래디언트가 이보다 크면 줄인다 | |
| 잡음 배수. 실제 잡음의 크기는 |
이 글의 실험은 전체 배치 경사하강이라 회계가 간단하다. 번 갱신하면 로 계산된다.
2. 직접 재 보기 A — 모델은 기억한다
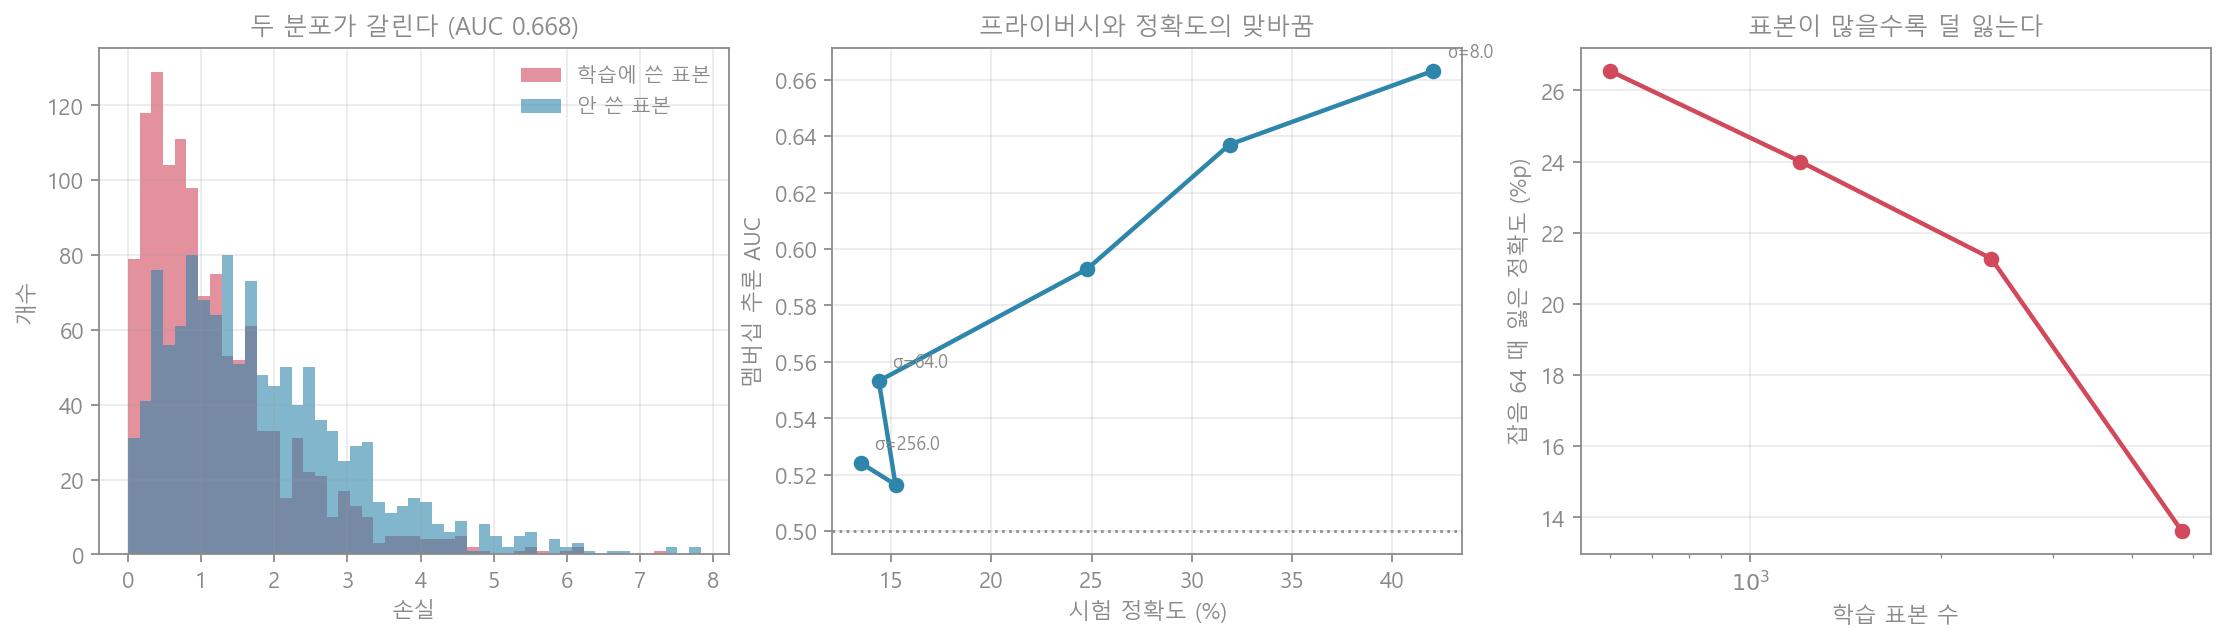
도형 12종을 분류하는 로지스틱 회귀를 1,200개로 학습시킨 뒤, 학습에 쓴 표본과 안 쓴 표본의 손실을 비교했다.
| 평균 손실 | |
|---|---|
| 학습에 쓴 표본 | 1.629 |
| 안 쓴 표본 | 1.949 |
| 멤버십 추론 AUC | 0.668 |
AUC 0.5는 “전혀 못 알아본다”, 1.0은 “완벽히 구별”이다. 0.668이면 상당히 알아본다. 손실 하나만 보고도 그렇다.
여기서 중요한 것은 공격이 전혀 정교하지 않다는 점이다. 모델 내부를 뜯어보지도 않았고, 그냥 “이 표본의 손실이 낮으면 학습에 썼겠지”라고 했을 뿐이다. 실제 공격은 훨씬 강하다.
3. 직접 재 보기 B — 지우는 값
이제 그래디언트를 자르고 잡음을 넣는다. 잡음 배수 만 바꿔 가며 쟀다.
| 잡음 배수 | 0 | 8 | 16 | 32 | 64 | 128 |
|---|---|---|---|---|---|---|
| 제한 없음 | 19.4 | 8.5 | 4.0 | 1.9 | 0.9 | |
| 시험 정확도 | 44.2% | 42.1% | 31.9% | 24.8% | 14.4% | 15.2% |
| 멤버십 AUC | 0.668 | 0.663 | 0.637 | 0.593 | 0.553 | 0.517 |
AUC는 0.668에서 0.517까지 내려간다 — 사실상 못 알아본다. 그런데 같은 줄에서 정확도가 44.2%에서 15.2%로 내려갔다. 이 과제의 찍기 수준이 8.3%이니, 거의 남지 않았다.
이것이 차등 프라이버시의 실체다. 공짜가 아니다. 특히 이 1 근처(강한 보장)로 가면 정확도가 급히 무너진다. 처럼 느슨한 보장에서는 정확도를 거의 안 잃지만, 그 정도의 은 이론적으로 의미 있는 보장이라고 보기 어렵다.
잡음을 키우면서 두 손실 분포가 어떻게 되는지 그대로 찍었다.
처음에는 빨강(학습에 쓴 것)이 왼쪽으로 치우쳐 있다가, 잡음이 커지면서 파랑과 포개진다. 1절 그림 ③이 실제로 일어나는 모습이다. 포개질수록 구별이 불가능해지고, 동시에 둘 다 오른쪽으로 밀린다 — 손실이 커진다는 뜻이고 그게 정확도의 대가다.
4. 직접 재 보기 C — 데이터가 프라이버시를 사 준다
같은 잡음이라도 표본이 많으면 덜 잃는다. 잡음을 로 고정하고 표본 수만 바꿨다.
| 학습 표본 수 | 600 | 1,200 | 2,400 | 4,800 |
|---|---|---|---|---|
| 잡음 없음 | 39.0% | 41.6% | 45.3% | 47.6% |
| 잡음 | 12.4% | 17.6% | 24.0% | 34.0% |
| 잃은 정확도 | 26.6%p | 24.0%p | 21.3%p | 13.6%p |
표본을 8배로 늘리자 잃는 양이 절반으로 줄었다(26.6%p → 13.6%p). 그러면서 AUC도 0.551에서 0.544로 비슷하게 유지된다 — 같은 프라이버시를 더 싸게 산 것이다.
이유는 평균에 있다. 잡음은 그래디언트의 합에 한 번 더해지고, 갱신할 때 표본 수로 나눈다. 표본이 많을수록 신호는 그대로인데 잡음의 몫이 작아진다. 그래서 프라이버시 보호 학습은 데이터가 많을수록 유리하고, 데이터가 적은 곳에서 가장 아프다 — 정작 프라이버시가 민감한 영역 (의료 기록 등)이 대개 데이터가 적다는 점에서 얄궂은 성질이다.
5. 흔한 오해와 한계
- “익명화하면 된다” — 이 실험은 이름을 쓴 적이 없다. 그런데도 손실만으로 AUC 0.668이 나왔다. 유출은 식별자가 아니라 모델이 기억한 것에서 나온다.
- “이 작으면 안전, 크면 위험” — 방향은 맞지만 같은 값은 보장이라 부르기 어렵다. 논문에 적힌 을 볼 때 크기를 확인해야 한다.
- “AUC가 0.5면 완전히 안전” — 이 공격 기준에서 그렇다는 뜻이다. 더 강한 공격은 다른 신호를 쓴다.
- “프라이버시는 정확도를 조금 깎는다” — 강한 보장에서는 조금이 아니었다(44.2% → 15.2%).
- 이 글의 실험 — 로지스틱 회귀와 전체 배치 경사하강이라는 단순한 설정이다. 실제 DP-SGD는 미니배치 표집이 주는 증폭을 쓰므로 같은 을 훨씬 싸게 얻는다. 0.668·15.2% 같은 수는 이 설정의 값이고, 요점은 모델은 기억한다, 자르고 더해 지운다, 그 값은 정확도이며 데이터로 깎는다는 구조다.
6. 한 문단 요약
모델은 학습에 쓴 표본을 알아본다. 손실 하나만 보는 단순한 공격으로도 멤버십 추론 AUC가 0.668이었다. 차등 프라이버시는 이것을 정의부터 막는다 — 한 사람이 있든 없든 결과의 분포가 거의 같게 만들고, 그러기 위해 한 사람의 영향을 자르고(클리핑) 그만큼 잡음을 더한다. 실제로 잡음을 키우자 AUC가 0.517까지 내려가 사실상 구별이 불가능해졌지만, 시험 정확도도 44.2%에서 15.2%로 함께 내려갔다 (찍기가 8.3%인 과제다). 강한 보장()은 결코 공짜가 아니다. 다만 값을 깎을 방법이 있다 — 표본을 8배로 늘리자 같은 잡음에서 잃는 정확도가 26.6%p에서 13.6%p로 줄었다. 잡음은 합에 한 번 더해지고 표본 수로 나뉘기 때문이다. 프라이버시는 데이터로 산다.