인지야공/딥러닝 기초 정리/17번째 글
상태공간모델·선형 어텐션 — 어텐션의 O(N²) 대안
실행:
python NN_23_ssm.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 필요한 수학: 고유값 노트.
플래시 어텐션 편이 어텐션의 메모리를 으로 줄였지만, 계산은 여전히 다 — 모든 토큰 쌍을 본다. 아주 긴 문맥에서는 이 제곱이 문제다. 상태공간모델(SSM, Mamba)·선형 어텐션은 계산까지 으로 줄인다. 어떻게, 그리고 그 대가를 잰다.
1. 계산 — O(N²) vs O(N)
어텐션은 모든 쌍의 점수를 계산한다 → . 순환 모델은 과거를 상태 하나로 요약하고 새 토큰마다 갱신한다 → 상태 갱신 번 × . 면 순환이 싸다.
직접 재 보기 A
헤드 차원 에서 연산량(FLOPs)을 쟀다.
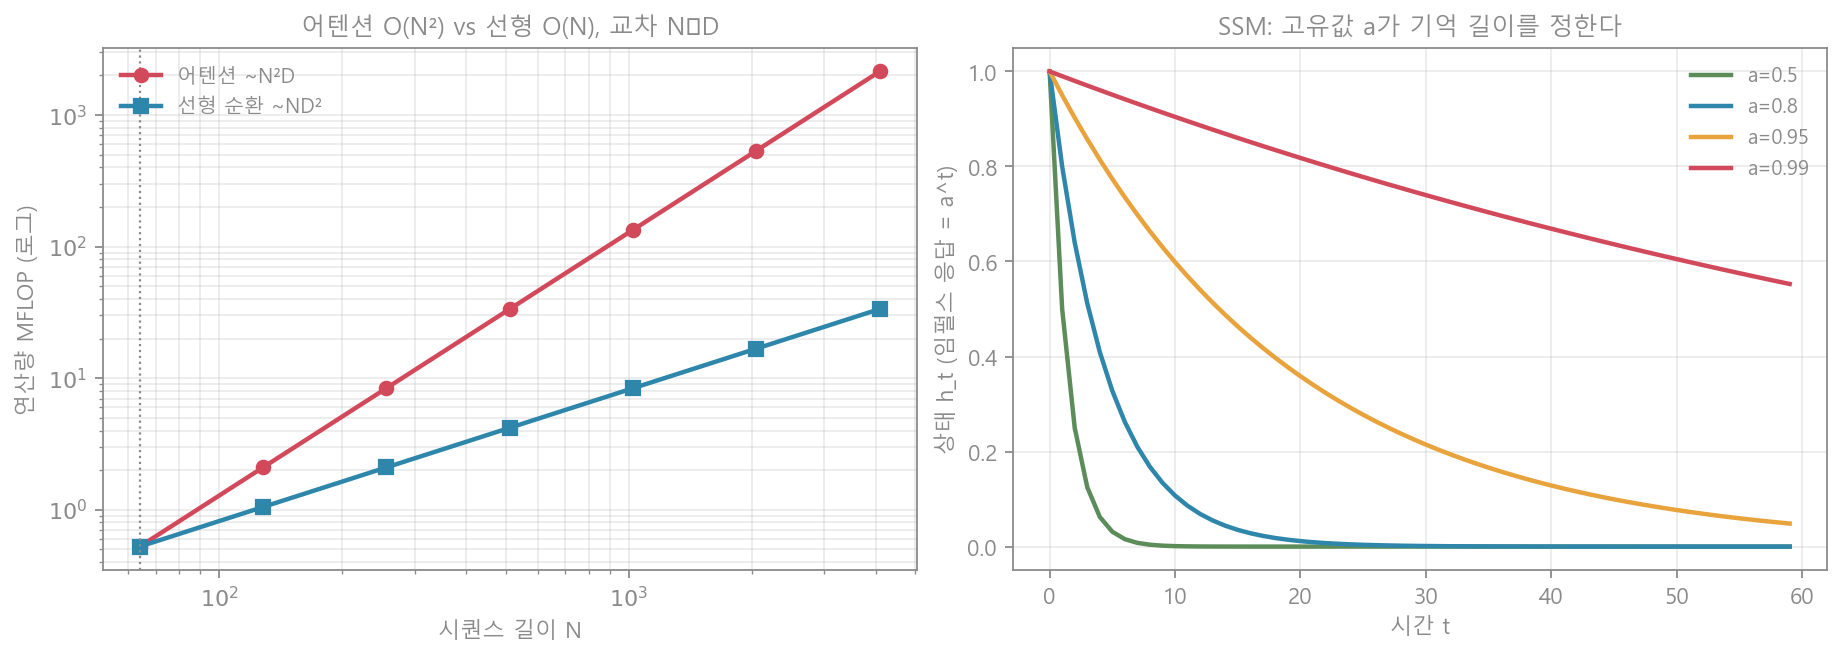
| N | 256 | 1024 | 4096 |
|---|---|---|---|
| 어텐션 ~N²D | 8.4 M | 134 M | 2,147 M |
| 선형 순환 ~ND² | 2.1 M | 8.4 M | 34 M |
| 배율 | 4× | 16× | 64× |
교차점은 이고, 그 뒤로는 어텐션이 제곱으로 벌어져 에서 64배 더 계산한다.
2. 비결 — 선형 어텐션 = 순환
어텐션에서 softmax만 빼면 결합 순서를 바꿀 수 있다. 로 두면:
괄호 안의 누적 합 , 은 running 상태다 — 새 토큰마다 더하기만 하면 된다. 그래서 행렬 없이 상태만 들고 ·상수 메모리로 돈다.
직접 재 보기 B
형태(인과 마스크)와 재귀를 비교했다.
| 결과 | |
|---|---|
| 형태 vs 재귀 | 최대 오차 4.8e-7 |
정확히 같다. 선형 어텐션은 곧 순환 신경망이다 — 학습 때는 병렬로(), 추론 때는 순환으로(·상수 메모리) 돌 수 있다. SSM(Mamba)도 같은 아이디어를, 상태 갱신을 더 정교하게(입력에 따라 게이팅) 한 것이다.
3. 대가 — 상태의 기억 길이
어텐션은 모든 과거를 그대로 본다(무한 기억, 대신 ). 순환 상태는 과거를 한 벡터로 압축하니, 오래된 정보는 잊힌다. 얼마나 기억하냐는 재귀 의 고유값 가 정한다(고유값 노트). 임펄스를 넣으면 로 준다.
직접 재 보기 C
| 고유값 | 0.5 | 0.8 | 0.95 | 0.99 |
|---|---|---|---|---|
| 반감기 | 1 스텝 | 4 스텝 | 14 스텝 | 69 스텝 |
| 유효 기억 길이 | 2 | 5 | 20 | 100 |
가 1에 가까울수록 오래 기억하지만, 1을 넘으면 발산한다. 정보 압축(고정 크기 상태) vs 정확한 회상(모든 쌍) 의 맞바꿈이 SSM과 어텐션의 근본 차이다 — SSM은 싸지만 긴 거리 정확한 회상은 약하고, 그래서 하이브리드(둘을 섞는) 구조가 많다.
4. 흔한 오해와 한계
- “SSM이 어텐션을 대체한다” — 상황에 따라 다르다. 긴 문맥·스트리밍엔 SSM이 싸지만, 정확한 회상엔 어텐션이 낫다. 실무는 자주 섞는다.
- “선형 어텐션은 근사” — 순환 형태는 형태와 정확히 같다.(2절). 다만 softmax를 뺀 것이 표현력을 조금 떨어뜨린다.
- “O(N)이면 공짜” — 아니다. 고정 크기 상태에 과거를 욱여넣으니 기억 손실이 대가다(3절).
- 이 글의 실험 — 연산량과 재귀 등가성, 기억 감쇠를 잰 축소 모형이다.
5. 한 문단 요약
어텐션은 모든 쌍을 봐 계산이 (재 보니 N=4096에서 선형의 64배 FLOP)다. 선형 어텐션은 softmax를 빼 누적 합(running 상태)의 재귀로 바꿔 ·상수 메모리로 돌고, 형태와 오차 5e-7로 정확히 같다 SSM(Mamba)도 같은 순환 아이디어다. 대신 과거를 고정 크기 상태로 압축하니 기억 손실이 대가이고, 그 기억 길이는 재귀의 고유값이 정한다(고유값 노트, 면 100스텝). 압축의 효율과 정확한 회상 사이의 맞바꿈이다.