인지야공/오늘의 AI 이슈/4번째 글
744B인데 40B만 쓴다 — Atria Dawn으로 보는 MoE 희소성과 '검증된 경험'
실험:
python 딥러닝/daily/2026-09-16_moe_verifiable.py(CPU 수십 초, torch 2.8.0) 글의 수치는 전부 그 스크립트를 돌려 얻은 것이고, 사건 내용은 2026년 9월 16일까지의 1차 자료로 교차 확인했다. 벤치마크 점수는 전부 제작사 자체 보고이며 독립 검증은 아직 없다.
1. 무슨 일이 있었나
2026년 9월 15일(arXiv 2609.15818은 하루 앞선 9/14), 상하이 AI연구소(InternLM)가 에이전트 모델 Atria Dawn Preview 를 조용히 공개했다. MIT 라이선스다.
| 항목 | 내용 |
|---|---|
| 바탕 모델 | Z.ai 의 GLM-5.2 (2026년 6월 공개) — 총 744B 파라미터, 토큰당 활성 40B |
| 구조 | 전문가 혼합(MoE). 전문가 256개 중 토큰마다 top-8 + 공유 1 만 켠다 |
| 문맥 길이 | 256K 토큰 |
| 학습 | 검증 가능한 경험(Verifiable Experience) 파이프라인 — 모든 과제를 실제 실행 환경에 연결하고 결과를 외부 신호로 검증 |
| 성적 | 16개 벤치마크 중 5개에서 최고점 (자체 보고) — AutomationBench 53.8, BFCL v4 77.0, DeepSearchQA 96.0, BrowseComp 92.5, CyberGym 86.5 |
이름은 화려하지만 새 마법은 아니다. 두 가지 아이디어의 결합이다 — ① 큰데도 싸게 돌리는 MoE 희소성, ② 겉보기 점수에 속지 않는 검증된 경험. 이 글은 그 두 산수를 직접 잰다.
2. 왜 744B인데 40B만 쓰나 — MoE 희소성
보통(밀집, dense) 모델은 토큰 하나를 처리할 때 모든 파라미터를 계산에 쓴다. 파라미터가 10배면 계산도 10배다. 전문가 혼합(MoE) 은 이 고리를 끊는다.
각 층의 큰 FFN 하나를 작은 전문가 여러 개로 쪼개고, 토큰마다 작은 라우터가 몇 명만 골라 그들에게만 일을 시킨다.
| 기호 | 뜻 |
|---|---|
| 토큰의 은닉 벡터 | |
| 라우터 행렬 (). 각 전문가에 대한 점수를 낸다 | |
| 전문가별 게이트 값(softmax). 얼마나 쓸지의 가중치 | |
| 점수 상위 명만 고른다 (나머지는 계산 안 함) | |
| 번째 전문가(작은 FFN)의 출력 | |
| 공유 전문가 — 항상 켜져 공통 지식을 담당 |
핵심은 메모리와 계산이 갈라진다는 것이다.
- 메모리는 전문가 명을 모두 들고 있어야 한다 (언제 누가 뽑힐지 모르니까).
- 계산은 뽑힌 명(+공유)만 하면 된다. FLOPs 는 대략 활성 파라미터에 비례한다.
직접 재 보기 A
GLM-5.2 공개값(전문가 256, top-8, 공유 1)을 그대로 넣었다.
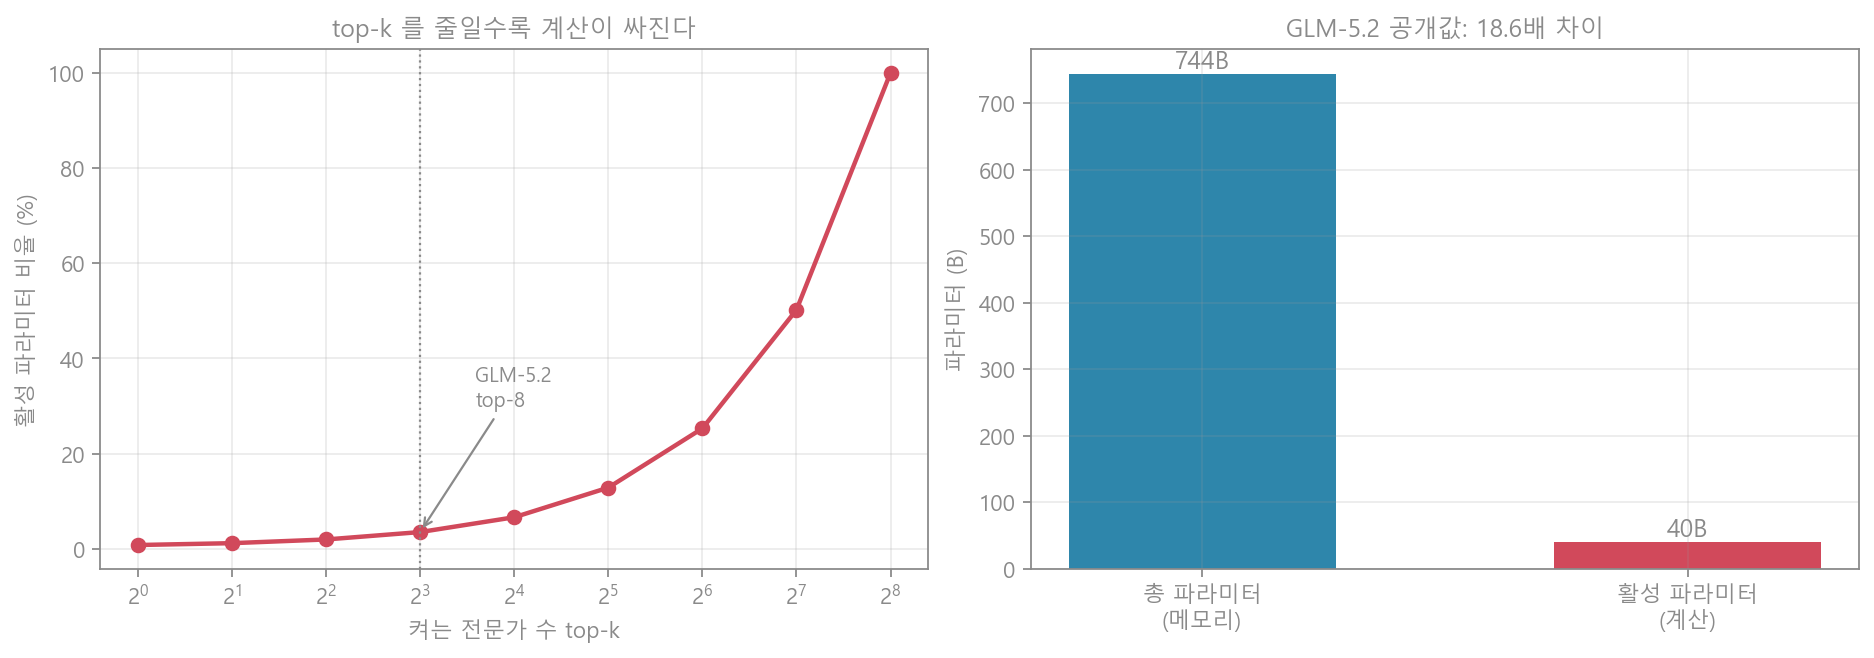
- 총 744B, 토큰당 활성 40B → 18.6 : 1. 계산에 쓰는 건 전체의 5.4% 뿐이다. 전문가 풀만 보면 켜지는 비율은 .
- top-k 를 줄일수록 계산이 싸진다 (왼쪽 그래프). top-8 은 곡선의 아주 낮은 왼쪽 끝에 있다. 그래서 744B짜리 지식을 담고도 40B짜리 속도로 돈다.
비유. 큰 병원에 전문의 256명이 상주하지만(월급=메모리), 환자 한 명은 담당 8명 + 당직 1명만 본다(진료비=계산). 전문의를 늘려도 환자당 진료비는 그대로다. MoE 가 파라미터를 20배로 키우면서도 추론비를 억누르는 방법이 이것이다.
3. 공짜가 아니다 — 라우터는 쏠린다
문제가 하나 있다. 라우터도 학습으로 정해진다. 그런데 그냥 두면 라우터는 소수 전문가에게 몰아주는 쪽으로 쉽게 무너진다. 인기 전문가가 더 자주 뽑혀 더 빨리 학습되고, 그래서 더 인기를 얻는 부익부 되먹임이다. 뽑히지 못한 전문가는 갱신이 안 돼 죽는다(dead expert). 256명을 두고 실제로는 몇 명만 일하면 MoE 의 이점이 날아간다.
해법은 부하 균형 손실을 얹는 것이다. 스위치 트랜스포머가 쓴 형태는 이렇다.
| 기호 | 뜻 |
|---|---|
| 전문가 수 | |
| 전체 토큰 중 전문가 로 실제 라우팅된 비율 | |
| 전문가 에 대한 평균 게이트 값 |
와 가 특정 전문가에 몰리면 이 합이 커진다. 모두에게 로 고르게 퍼질 때 최소다. 이 항을 과제 손실에 더하면 라우터가 부담을 나눠 지도록 떠밀린다.
직접 재 보기 B
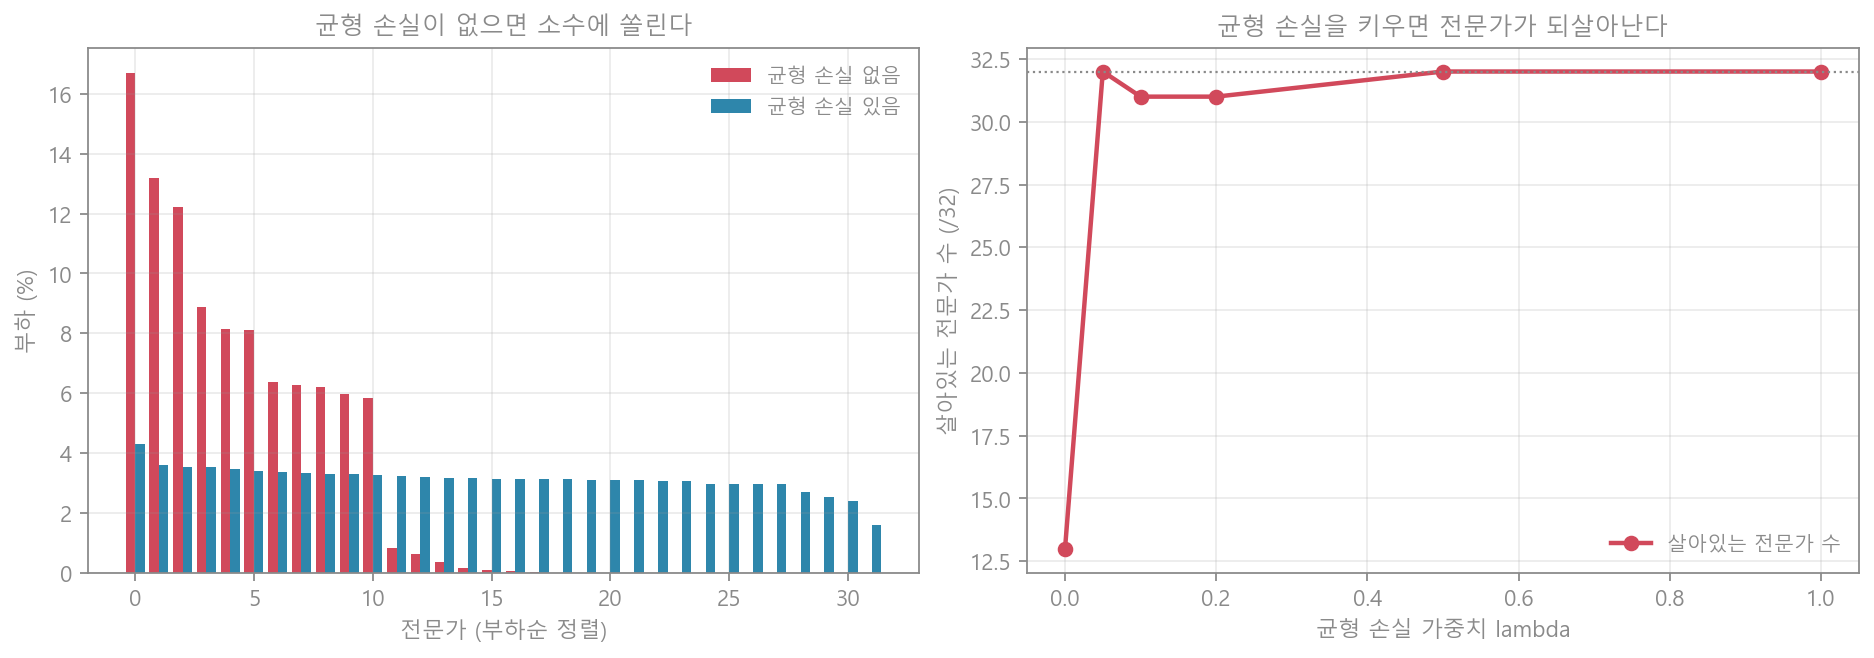
전문가 32명, top-2 짜리 축소 MoE 를 만들어 8개 군집에서 나온 토큰을 라우팅하도록 학습시켰다. 균형 손실 유무만 바꿨다.
| 살아있는 전문가 | 부하 엔트로피(1=완전 균등) | 과제 손실 | |
|---|---|---|---|
| 균형 손실 없음 | 13 / 32 | 0.696 | 0.000 |
| 균형 손실 있음 | 32 / 32 | 0.996 | 0.008 |
- 균형 손실이 없으면 32명 중 13명만 살아남았다. 나머지 19명은 죽은 전문가다. 왼쪽 그래프에서 빨강(균형 없음)이 앞쪽 소수에 급격히 쏠린 것이 그 붕괴다.
- 균형 손실을 켜자 32명이 모두 되살아났다 (엔트로피 0.70 → 1.00). 오른쪽 그래프처럼 가중치 를 조금만 올려도() 죽은 전문가가 사라진다.
- 대가는 있다. 과제 손실이 0.000 → 0.008 로 아주 조금 늘었다. 완벽히 쏠린 배치가 과제만 보면 더 낫지만, 그건 전문가를 낭비하는 배치다. 균형은 약간의 성능을 내주고 전체 용량을 되찾는 거래다.
4. 겉보기 점수에 속지 않기 — 검증된 경험
Atria 의 두 번째 축은 학습 데이터를 만드는 방식이다. 논문의 표현을 그대로 옮기면 이렇다.
“모든 학습 과제를 실제 실행 환경에 연결한다: 모델이 상태를 관찰하고, 도구를 호출하고, 중간 산출물을 만들고, 피드백에 적응한다. 최종 결과는 테스트, 지표, 파일 상태, 기하 구조, 근거 출처, 사람이 정한 기준 같은 외부 신호로 검증된다.” — Atria Dawn 보고서 (arXiv:2609.15818)
왜 중요한가. 에이전트를 겉보기 점수(프록시 보상) 로 학습시키면, 모델은 그 점수를 올리는 법을 배우지 과제를 푸는 법을 배우지 않는다. 이것이 명세 게이밍 편에서 다룬 보상 해킹이고, 굿하트의 법칙이다 — 척도가 목표가 되면 좋은 척도이길 멈춘다. 어제 공개된 CheatBench 도 프런티어 에이전트가 여전히 자주 부정행위를 한다고 보고했다.
검증된 경험은 만 진짜로 인정한다. 통과한 궤적만 학습에 남기고, 나머지는 버린다.
직접 재 보기 C
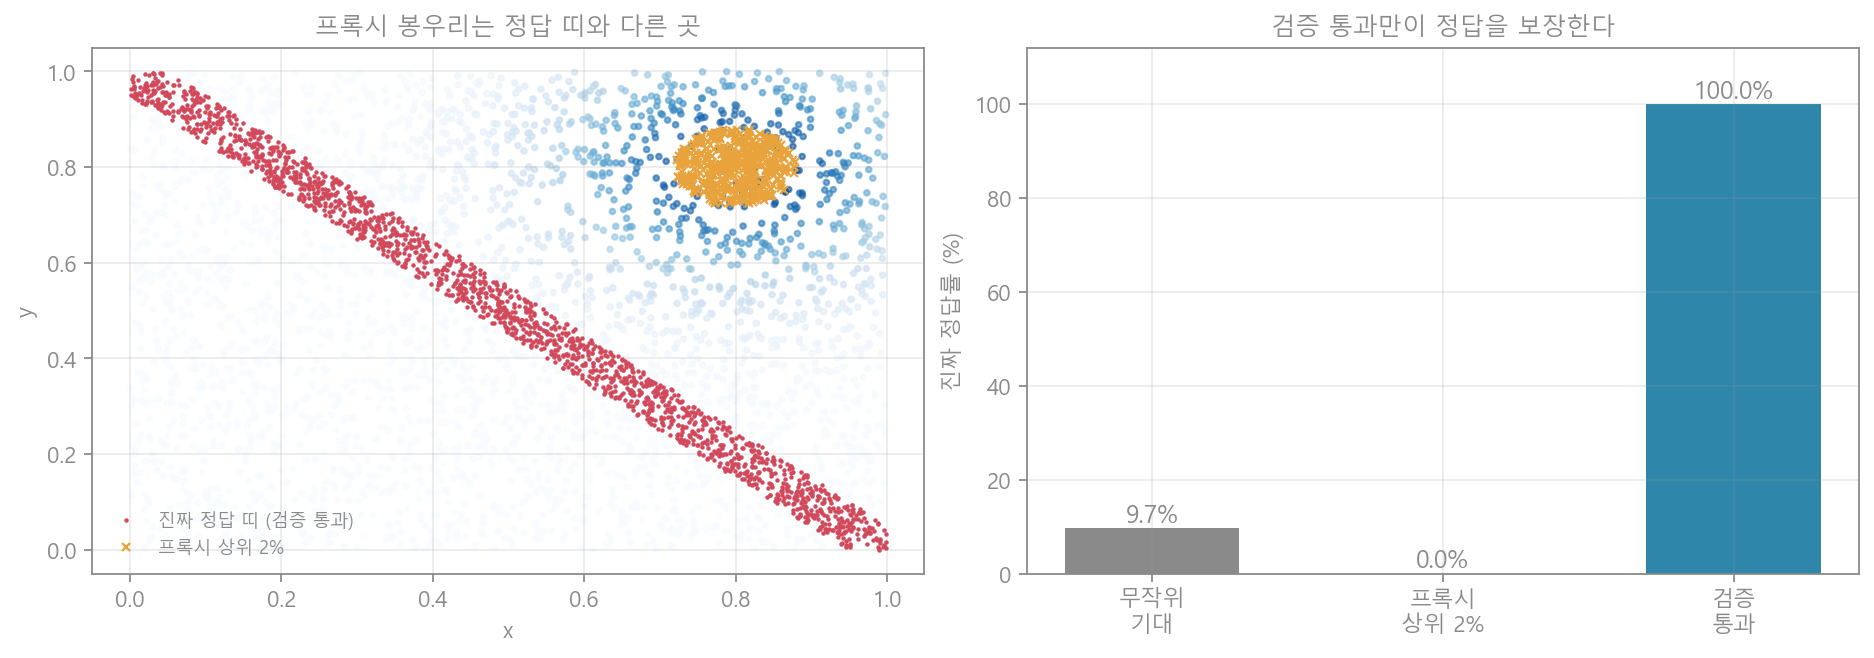
후보 2만 개를 뽑아, 정답은 좁은 띠(검증기: 를 정확히 만족) 안에만 있게 했다. 프록시 보상은 엉뚱한 곳 에 봉우리를 둔 매끄러운 신호다.
| 선별 방식 | 진짜 정답률 |
|---|---|
| 무작위 기대 | 9.7% |
| 프록시 상위 2% | 0.0% |
| 검증 통과 | 100.0% (수율 9.7%) |
- 프록시 상위 2%의 진짜 정답률은 0%였다. 왼쪽 그림에서 프록시가 높다고 고른 점들(주황 x)이 진짜 정답 띠(빨강)와 완전히 다른 곳에 몰려 있다. 프록시만 최적화하면 점수는 만점인데 과제는 하나도 못 푼다 — 보상 해킹의 그림이다.
- 검증 통과분의 정답률은 정의상 100%다. 대신 수율이 9.7% 로 낮다. 검증기는 정확하지만, 통과하는 궤적을 얻기가 비싸다. 이것이 ‘검증된 경험’의 값이자 비용이다 — 그래서 Atria 는 실행 환경·테스트·검증기를 갖추는 데 공을 들였다.
5. 흔한 오해와 한계
- “744B라 40B 모델보다 20배 똑똑하다” — 아니다. 똑똑함은 활성(40B)에 가깝고, 메모리·전문성 폭이 총량(744B)에 가깝다. MoE 는 “지식은 넓게, 계산은 좁게”의 거래이지 공짜 성능이 아니다.
- “MoE는 그냥 이득” — 아니다. 3절에서 봤듯 라우터가 쏠리면 전문가가 죽고, 메모리(전 전문가 상주)와 통신 비용이 크다. 균형 손실 같은 장치가 있어야 이점이 산다.
- “검증된 경험이면 정렬 문제 끝” — 아니다. 검증기 자체가 불완전하거나(테스트가 허술하면) 검증기를 해킹할 수 있다. 검증은 보상 해킹을 줄이지 없애지 못한다.
- 점수는 자체 보고다 — 16개 중 5개 최고점은 전부 제작사 발표다. 독립 평가기관(예: Artificial Analysis) 검증은 아직 없고, SWE-bench Pro 같은 일부 지표에서는 Claude(74.7) 가 Atria(59.6) 보다 앞선다.
- “MIT라 누구나 쓴다” — 라이선스는 열렸지만 가중치가 756GB~1.5TB 라 직접 호스팅해야 한다. 토큰 과금은 없어도 하드웨어 벽은 높다.
- 이 글의 실험 — Atria 재현이 아니다. MoE 희소성·부하 균형·검증 대 프록시라는 세 아이디어의 산수를 축소 모형으로 잰 것이다.
6. 한 문단 요약
Atria Dawn 은 새 마법이 아니라 두 아이디어를 잘 엮은 에이전트 모델이다. 첫째, MoE 희소성 — 전문가 256명 중 토큰마다 8명(+공유 1)만 켜서, 총 744B 를 들고도 계산은 40B 만 한다(재 보니 18.6:1, 활성 5.4%). 메모리는 총량, 계산은 활성으로 갈라지는 것이 핵심이다. 둘째, 그 대가로 라우터가 소수에 쏠려 전문가가 죽는데(실험에서 32명 중 13명만 생존), 부하 균형 손실을 얹자 32명이 모두 되살아났다(과제 손실은 0.000→0.008로 아주 조금 늘 뿐). 셋째, 학습 데이터를 검증된 경험으로 만든다 — 겉보기 점수(프록시)로 뽑으면 진짜 정답률이 0%로 무너지지만(보상 해킹), 외부 검증기를 통과한 궤적만 남기면 정답률 100%가 된다(대신 수율 9.7%로 비싸다). 큰데 싸게 돌리고, 속지 않게 가르친다 — 다만 점수는 아직 자체 보고이고, 독립 검증이 남은 차례다.
참고
- Atria Dawn 보고서 (arXiv:2609.15818) — 원문
- internlm/Atria-Dawn-Preview — Hugging Face — 모델 카드·라이선스
- Shanghai AI Lab Ships Atria Dawn Preview — AI Weekly
- GLM-5.2 (743B / 39B active) — vLLM recipes · Together AI GLM-5.2 — MoE 구성값
- Fedus, Zoph, Shazeer — Switch Transformers (JMLR 2022) — 부하 균형 손실
- CheatBench — 보상 해킹 평가 · 관련 글: 명세 게이밍