인지야공/딥러닝 기초 정리/38번째 글
그로킹과 이중 하강 — 일반화는 언제 오는가
실행:
python NN_36_grokking.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
데이터 편에서 외우는 것과 이해하는 것이 다르다는 걸 봤다. 그럼 모델은 언제 외우기를 멈추고 이해하기 시작할까. 답이 꽤 이상하다 — 다 외운 한참 뒤에, 갑자기.
과제는 모듈러 덧셈이다. 을 맞히는 문제인데, 가능한 쌍 9,409개 중 40%만 학습에 준다. 나머지 60%는 본 적이 없으니, 규칙을 배웠다면 맞히고 외우기만 했다면 못 맞힌다.
1. 무슨 일이 일어나는가 — 그림으로 먼저
세 장면 모두 학습 데이터(검은 점)를 정확히 지난다. 손실은 이미 0에 가깝다. 다른 것은 그 사이를 어떻게 잇느냐뿐이고, 처음에는 울퉁불퉁하게(외운 해) 잇다가 점점 단순하게(이해한 해) 바뀐다. 이 과정이 학습 손실에는 거의 안 보이고 시험 점수에서만 갑자기 드러난다.
2. 직접 재 보기 A — 외운 뒤에 한참 지나서
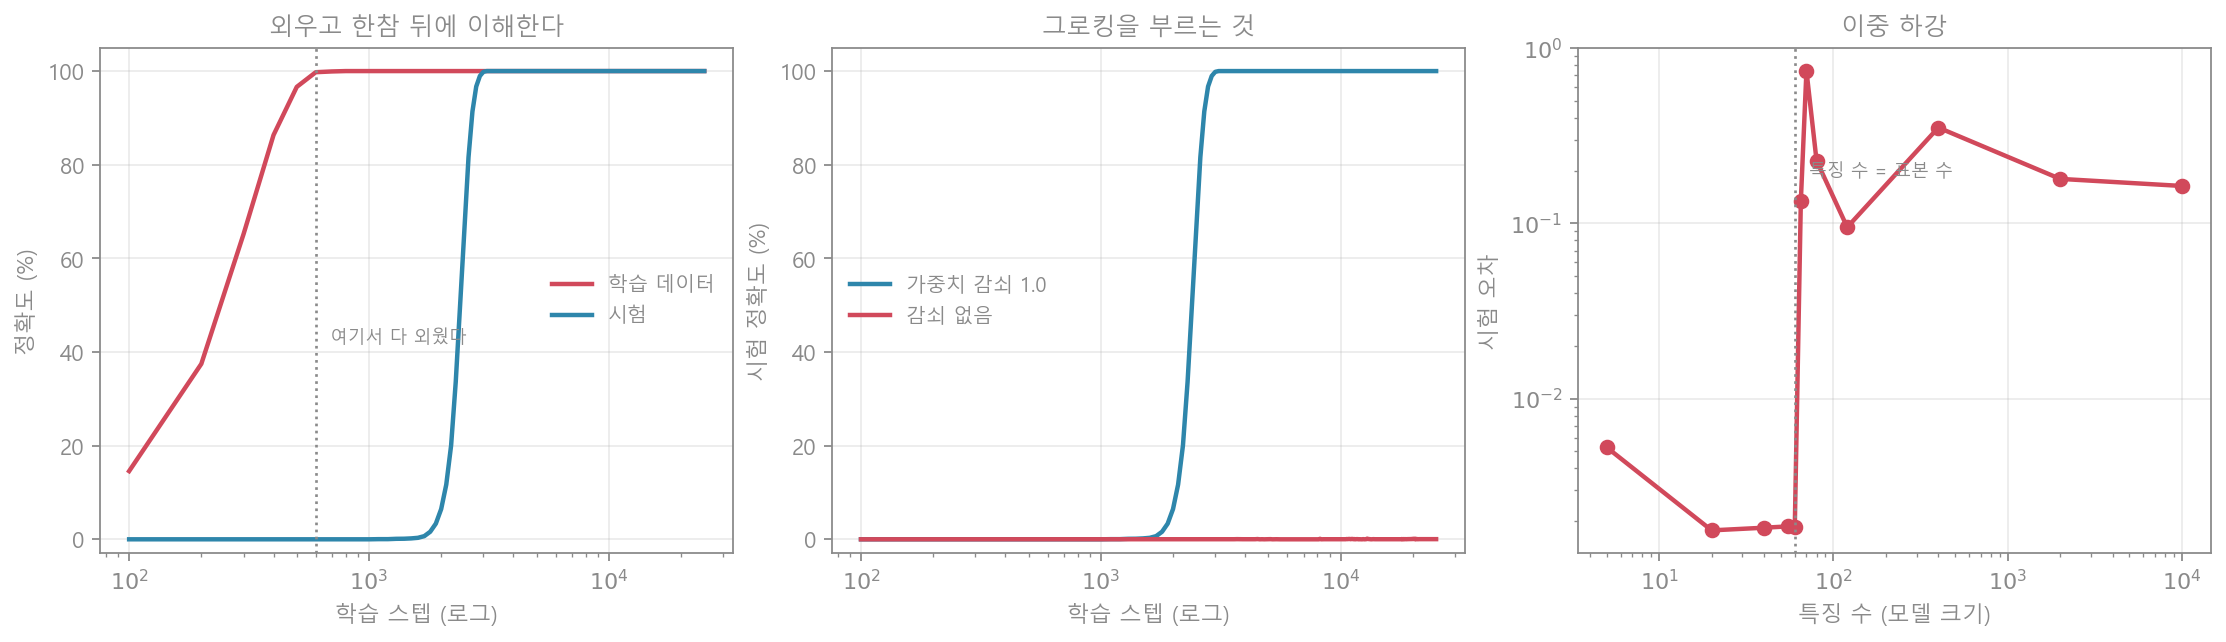
| 학습 스텝 | 500 | 1,000 | 2,000 | 5,000 | 25,000 |
|---|---|---|---|---|---|
| 학습 데이터 정확도 | 96.6% | 100.0% | 100.0% | 100.0% | 100.0% |
| 시험 정확도 | 0.0% | 0.0% | 6.5% | 100.0% | 100.0% |
| 가중치 크기 | 84.5 | 70.7 | 62.4 | 43.2 | 40.3 |
1,000스텝에서 학습 데이터는 100%인데 시험은 0.0%다. 완벽하게 외웠고 완벽하게 이해하지 못했다. 그 상태가 한참 이어지다가 2,000~5,000스텝 사이에 0%에서 100%로 뛴다. 학습 정확도 99% 도달은 600스텝, 시험 90% 도달은 2,700스텝 — 다 외운 뒤 4.5배를 더 돌려야 했다.
곡선이 그려지는 과정을 그대로 보면 이 “갑자기”가 분명하다.
빨간 선(학습)이 천장에 붙어 아무 일도 없는 것처럼 보이는 동안, 파란 선(시험)은 바닥에 눌려 있다. 손실만 보고 있었다면 1,000스텝에서 학습을 멈췄을 것이다.
3. 직접 재 보기 B — 무엇이 그로킹을 만드나
그 “한참 동안” 모델 안에서 무엇이 바뀌었을까. 위 표의 마지막 줄이 답을 준다 — 가중치 크기가 계속 줄고 있다 (84.5 → 40.3). 학습 손실은 이미 0이라 줄일 것이 없는데도, 가중치 감쇠가 계속 “더 작은 해로 가라”고 민다.
그렇다면 감쇠를 빼면 어떻게 될까.
| 마지막 시험 정확도 | 마지막 가중치 크기 | |
|---|---|---|
| 가중치 감쇠 1.0 | 100.0% | 40.3 |
| 감쇠 없음 | 0.0% | 150.1 |
감쇠를 빼자 25,000스텝을 돌려도 시험은 0.0%였다. 가중치는 오히려 150.1까지 커졌다. 즉 그로킹은 “오래 돌리면 저절로 되는 일”이 아니다. 1절 그림의 ②단계, 더 단순한 해 쪽으로 미는 힘이 있어야 한다.
여기서 최적화 편의 가중치 감쇠가 왜 정규화 이상인지가 보인다. 그것은 성능을 조금 다듬는 장치가 아니라, 외운 해와 이해한 해 중 무엇을 고를지 정하는 장치다.
4. 직접 재 보기 C — 크기 쪽의 이상함
시간축에 이상함이 있었듯 모델 크기축에도 있다. 표본 60개를 무작위 특징 개로 맞춰 봤다 (특징이 적으면 못 맞히고, 많으면 여러 해 중 크기가 가장 작은 것을 고른다).
| 특징 수 | 20 | 60 | 65 | 70 | 120 | 2,000 | 10,000 |
|---|---|---|---|---|---|---|---|
| 시험 오차 | 0.0018 | 0.0018 | 0.1341 | 0.7446 | 0.0951 | 0.1796 | 0.1636 |
, 곧 특징 수가 표본 수와 같아지는 지점까지는 잘 맞힌다. 그런데 거기서 조금만 넘기면 (70개) 오차가 400배로 치솟고, 더 키우면 다시 내려간다(0.7446 → 0.0951). 이것이 이중 하강이다.
이유는 이렇다. 에서는 데이터를 정확히 지나는 해가 딱 하나뿐이라 고를 여지가 없다 — 잡음까지 억지로 통과하느라 곡선이 요동친다. 이면 지나는 해가 무수히 많아져서 그중 가장 작은(가장 단순한) 것을 고를 수 있다. 3절에서 본 것과 같은 이야기다 — 여유가 있어야 단순한 해를 고를 수 있다.
다만 정직하게 덧붙이면, 이 설정에서 두 번째 하강은 과소모수 구간의 최저점(0.0018)까지는 돌아오지 못했다 (10,000개에서 0.1636). 이중 하강은 “키우면 항상 더 좋아진다”가 아니라 “봉우리를 지나면 다시 좋아진다”는 이야기다.
5. 흔한 오해와 한계
- “학습 손실이 0이면 다 배운 것” — 2절에서 1,000스텝의 학습 손실은 사실상 0인데 시험은 0.0%였다. 조기 종료를 손실만 보고 하면 그로킹 직전에 멈춘다.
- “오래 돌리면 언젠가 일반화된다” — 아니다(3절). 감쇠가 없으면 25,000스텝도 소용없었다.
- “모델이 클수록 과적합한다” — 고전적 직관인데 4절이 반례다. 봉우리는 근처이고 그보다 크면 오히려 나아진다.
- “그로킹은 어디서나 일어난다” — 주로 규칙이 있는 작은 과제에서 선명하게 보인다. 실제 대규모 학습에서는 데이터가 많아 외울 수가 없으니 이렇게 극적인 분리가 잘 안 나타난다.
- 이 글의 실험 — 모듈러 덧셈과 무작위 특징 회귀라는 장난감이다. 4.5배·0.7446 같은 수는 이 설정의 값이고, 요점은 손실이 0이 된 뒤에도 학습은 계속되고 있으며, 그 방향을 정하는 것은 단순함으로 미는 압력이라는 구조다.
6. 한 문단 요약
모델은 학습 데이터를 600스텝 만에 전부 외웠는데 시험은 0.0%였고, 그 상태로 한참을 가다가 2,000~5,000스텝 사이에 갑자기 100%가 됐다(그로킹). 그동안 겉으로 바뀐 것은 없었지만 가중치 크기가 84.5에서 40.3으로 줄고 있었다 — 같은 데이터를 지나는 해 중 더 단순한 것으로 계속 옮겨 간 것이다. 실제로 가중치 감쇠를 빼자 25,000스텝을 돌려도 시험은 0.0%에 머물렀다. 모델 크기 쪽에도 같은 이상함이 있어서, 특징 수가 표본 수와 같아지는 지점에서 오차가 400배로 치솟았다가 더 키우면 다시 내려간다 (이중 하강). 둘 다 같은 것을 말한다 — 데이터를 맞히는 해는 여러 개이고, 일반화를 결정하는 것은 그중 무엇을 고르느냐다.