인지야공/딥러닝 기초 정리/28번째 글
모델 병합 — 가중치를 평균내도 되는 이유
실행:
python NN_48_model_merging.py(검증 환경: torch 2.8.0+cu129, RTX 5080) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
“모델 두 개를 합친다”고 하면 보통 앙상블을 떠올린다 — 둘 다 돌리고 답을 평균낸다. 그런데 추론 비용이 두 배다. 그러지 말고 가중치 자체를 평균내면 안 될까? 모델은 한 개로 남고 비용도 그대로일 텐데.
말이 안 되는 소리처럼 들린다. 그런데 조건만 맞으면 된다. 그 조건이 무엇인지 잰다.
1. 손실 지형 — 그림으로 먼저
가중치 하나하나가 좌표인 공간을 상상하자. 모델 하나는 점 하나이고, 학습은 손실이 낮은 골짜기를 찾아 내려가는 일이다. 두 모델을 섞는다는 것은 두 점을 잇는 직선 위의 한 점을 고르는 일이다.
| 기호 | 뜻 |
|---|---|
| 모델의 가중치 전체를 늘어놓은 벡터 | |
| 섞는 비율. 0이면 A, 1이면 B | |
| 장벽 | 경로 위의 최대 손실 양 끝 손실의 평균 |
장벽이 0에 가까우면 “선형으로 이어져 있다”고 말한다. 그러면 평균이 쓸 만한 모델이 된다.
2. 직접 재 보기 A — 남남끼리는 무너진다
도형 12종 분류기를 서로 다른 초기화로 두 개 학습시키고 를 0에서 1까지 훑었다.
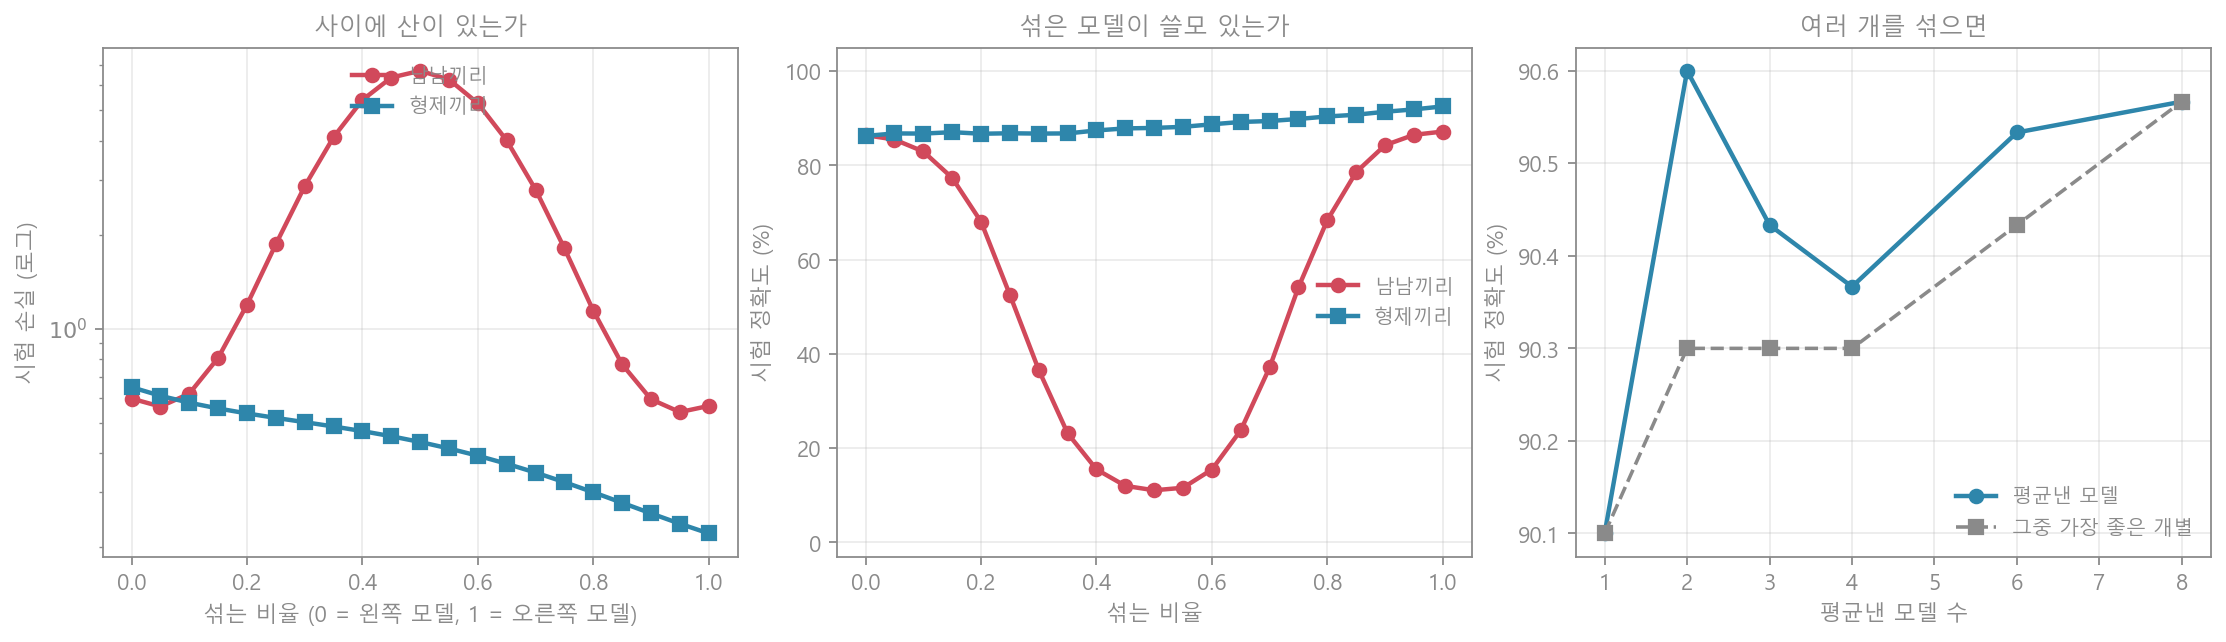
| 모델 1 () | 반씩 섞음 () | 모델 2 () | |
|---|---|---|---|
| 시험 손실 | 0.598 | 6.684 | 0.566 |
| 시험 정확도 | 86.4% | 11.1% | 87.2% |
각자 86%대인 멀쩡한 모델 둘인데, 반씩 섞으면 11.1%다. 이 과제의 찍기가 8.3%이니 사실상 파괴됐다. 손실은 0.58에서 6.68로 11배 솟았다 — 1절 그림 ①의 산등성이다.
이유는 간단하다. 초기화가 다르면 같은 일을 하는 뉴런이 서로 다른 자리에 있다. 첫 번째 모델의 17번 뉴런과 두 번째 모델의 17번 뉴런은 전혀 다른 것을 하는데, 그 둘을 평균내면 아무것도 아닌 것이 된다.
3. 직접 재 보기 B — 형제끼리는 평평하다
이번에는 공통 출발점을 만들었다. 1,200스텝 학습한 모델(85.7%)에서 복사해, 학습률과 증강만 달리해 각자 2,800스텝을 더 돌렸다.
| 자식 1 () | 반씩 섞음 | 자식 2 () | |
|---|---|---|---|
| 시험 손실 | 0.650 | 0.434 | 0.221 |
| 시험 정확도 | 86.3% | 88.0% | 92.5% |
무너지지 않는다. 그뿐 아니라 반씩 섞은 모델의 손실(0.434)이 자식 1(0.650)보다 낮다. 경로 전체에서 양 끝보다 솟는 지점이 없었다 — 장벽이 0이다.
두 경우를 나란히 놓고 를 움직여 보면 차이가 분명하다.
빨강(남남끼리)은 중간에서 바닥으로 떨어지고, 파랑(형제끼리)은 끝까지 평평하다.
같은 출발점을 공유하느냐가 전부를 가른다. 파인튜닝은 사전학습 모델에서 조금 움직이는 일이라, 그 결과물들은 대개 같은 골짜기 안에 머문다. 그래서 파인튜닝된 모델들끼리는 평균낼 수 있다 — 이것이 오늘날 모델 병합이 성립하는 이유다.
4. 직접 재 보기 C — 수프
그렇다면 여러 개를 한꺼번에 평균내면? 같은 출발점에서 학습률·증강만 조금씩 달리한 자식 8개를 만들고 (정확도 평균 89.9%, 가장 좋은 것 90.6%), 앞에서부터 개씩 평균냈다.
| 평균낸 개수 | 1 | 2 | 3 | 4 | 6 | 8 |
|---|---|---|---|---|---|---|
| 수프의 정확도 | 90.1% | 90.6% | 90.4% | 90.4% | 90.5% | 90.6% |
| 그중 가장 좋은 개별 | 90.1% | 90.3% | 90.3% | 90.3% | 90.4% | 90.6% |
전부 평균낸 수프(90.6%)는 개별 평균(89.9%)보다 0.7%p 낫고, 가장 좋은 개별과 같은 수준이다. 여기까지는 “손해는 안 본다” 정도다.
한 걸음 더 간 것이 탐욕 수프다 — 검증 점수가 좋아질 때만 하나씩 담는다(시험셋은 안 본다).
| 시험 정확도 | 시험 손실 | |
|---|---|---|
| 탐욕 수프 (2개 담음) | 91.2% | 0.288 |
| 검증으로 고른 최고 개별 모델 | 90.6% | 0.312 |
| 전부 평균낸 수프 | 90.6% | 0.329 |
최고 개별 모델보다 0.6%p 높다. 그런데 추론 비용은 모델 한 개 그대로다. 앙상블이 같은 이득을 주려면 두 모델을 다 돌려야 한다.
여기서 병합이 실무에서 쓰이는 방식이 나온다 — 하이퍼파라미터를 여러 개로 돌려 놓고 제일 좋은 하나만 쓰고 나머지를 버리는 대신, 좋은 것들을 담아 한 개로 만든다.
5. 흔한 오해와 한계
- “가중치 평균은 언제나 된다” — 아니다. 남남끼리는 11.1%로 무너졌다(2절).
- “평균이 앙상블과 같다” — 다르다. 앙상블은 출력을 평균내고 비용이 배다. 병합은 가중치를 평균내고 비용이 1배인데, 같은 골짜기 안에서만 된다.
- “많이 담을수록 좋다” — 4절에서 전부 담은 것(90.6%)보다 2개만 고른 것(91.2%)이 나았다.
- “뉴런 순서를 맞추면 남남끼리도 된다” — 실제로 그런 연구가 있다(순열 정렬 후 병합). 이 글은 그 처리를 하지 않은 날것의 평균을 잰 것이다.
- 이 글의 실험 — 작은 MLP와 도형 12종이다. 11.1%·91.2% 같은 수는 이 설정의 값이고, 요점은 같은 출발점을 공유하면 사이가 평평하다, 그래서 평균이 성립한다, 고르는 것이 담는 것보다 낫다는 구조다.
6. 한 문단 요약
가중치를 평균내는 일은 손실 지형에서 두 점을 잇는 직선 위의 한 점을 고르는 일이다. 서로 다른 초기화로 학습한 두 모델은 각자 86.4%·87.2%인데도 반씩 섞으면 11.1%로 무너졌다 (찍기가 8.3%인 과제다) — 같은 일을 하는 뉴런이 서로 다른 자리에 있어 평균이 아무것도 아닌 것이 되기 때문이다. 그런데 같은 출발점에서 갈라진 두 모델은 사이가 평평했다. 86.3%와 92.5%를 반씩 섞어 88.0%가 나왔고, 경로 어디에도 솟는 지점이 없었다. 파인튜닝이 사전학습 모델에서 조금만 움직이는 일이라는 점이 여기서 값어치를 한다. 그 위에서 여러 개를 담으면 수프가 된다. 전부 평균낸 것은 개별 평균보다 0.7%p 나았고, 검증으로 골라 담은 탐욕 수프는 최고 개별 모델보다 0.6%p 높았다 (91.2% 대 90.6%). 추론 비용은 내내 모델 한 개였다.