인지야공/오늘의 AI 이슈/11번째 글
네 겹의 통제 — 겹을 쌓아도 구멍이 같은 자리면
실행:
python 딥러닝/daily/DAILY_2026_09_30_layered_audit.py(CPU 10초 안) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 층별 검출률, 불량률, 감시기 재현율은 가정한 값이고 어느 회사의 실제 수치도 아니다. 보려는 것은 숫자가 아니라 구조가 만드는 차이다.
1. 무슨 일이 있었나
9월 29일(화), 트럼프 대통령과 AI 기업 대표 여섯 명이 「White House Accord on Super Intelligence」에 서명했다. 서명한 사람은 Google의 순다르 피차이, Anthropic의 다리오 아모데이, Meta의 마크 저커버그, OpenAI의 그렉 브록먼, xAI의 일론 머스크, Nvidia의 젠슨 황이다 (Washington Examiner 전문, Nextgov, NPR, GovConWire).
협약 전문이 약속하는 것은 네 겹이다.
| 겹 | 전문의 표현(요약) | 하는 일 |
|---|---|---|
| 1 | 내부 통제 | 학습과 배포 중에 모델의 능력과 정렬을 감시한다. 사이버·생물·화학 위협, 의도하지 않은 시스템 접근이 대상이다 |
| 2 | 내부팀 | 1의 통제·감시·탐지가 의도대로 돌고 있는지 확인하고, 드러난 문제가 고쳐졌는지 본다 |
| 3 | 외부 감사 | 독립된 외부 감사인이 통제가 의도대로 도는지 평가한다 |
| 4 | 이사회 위원회 | 이사회 안의 독립 위원회가 내부·외부 감사 보고를 받고, 경영진이 문제를 고치도록 책임을 묻는다 |
같은 날 대통령은 연방 기관이 공식 문서에서 AI 대신 “super intelligence(SI)“라는 말을 쓰라는 행정명령에도 서명했고, 과학기술 보좌관에게 60일 안에 SI의 법적 정의안을 내라고 했다(Nextgov).
이 협약은 법적 구속력이 없다. 전문은 “시간이 지나면 이 단계들을 법이나 규정으로 만드는 것이 맞을 수도 있다”고만 적고, 보고 주기나 기한은 정하지 않았다. JD 밴스 부통령은 FDA나 FAA 같은 규제 기관을 만드는 방식을 거부했다(Nextgov). NPR은 이를 “스스로 단속(self-police)“하겠다는 약속으로 요약했다.
정치적 평가는 이 글의 몫이 아니다. 이 글은 “겹을 쌓으면 얼마나 안전해지나”를 셈한다. 그 답이 곱셈일 때와 곱셈이 아닐 때가 있고, 차이는 몇 배다.
2. 핵심 개념 — 스위스 치즈
겹겹 방어의 산수
치즈 한 장에는 구멍이 있다. 여러 장을 겹치면, 구멍이 서로 다른 자리에 있는 한 빛이 통과하지 못한다. 사고 분석에서 오래 쓰인 스위스 치즈 모델이다.
층 가 문제를 잡을 확률을 라 하자. 층들이 서로 독립이면, 모든 층이 동시에 놓칠 확률은 곱이다.
| 기호 | 뜻 |
|---|---|
| 문제를 찾는 층의 수 | |
| 층 하나가 문제를 잡을 확률 (검출률) | |
| 층 가 놓칠 확률 | |
| 모두 곱한다 |
숫자로 따라가 보자. 내부 감시가 70%, 내부팀 점검이 50%, 외부 감사가 60% 를 잡는다고 가정한다.
- 독립이면 놓침은 , 곧 6% 다. 가장 좋은 층 하나(30% 놓침)보다 다섯 배 낫다.
- 세 층이 정확히 같은 사건들을 놓친다면, 가장 좋은 층이 잡는 것 말고는 아무것도 더 잡히지 않는다. 놓침은 30% 다.
현실은 그 사이 어딘가다. 어디쯤인지를 정하는 것이 상관이다.
왜 층들이 같이 놓치나
“같이 놓친다”는 것은 층들이 같은 정보를 보거나, 같은 약점을 가진다는 뜻이다.
- 내부팀이 감시기가 낸 경보 목록을 기준으로 점검하면, 감시기가 못 본 사건은 내부팀에게도 안 보인다.
- 외부 감사가 회사가 건넨 기록만 보면, 기록에 안 남은 행동은 감사도 못 본다.
- 교묘한 사건일수록 모든 층에서 어렵다. 이 교묘함이 층들 사이의 공통 원인이다.
마지막 것을 모형으로 만든다. 사건마다 공통 교묘함 가 하나 있고, 층마다 제 잡음 가 있다.
| 기호 | 뜻 |
|---|---|
| 사건의 공통 교묘함. 모든 층이 같은 값을 본다 | |
| 층 만의 우연. 층마다 따로 뽑는다 | |
| 층 사이 상관. 0이면 독립, 1이면 모든 층이 같은 판정 | |
| 표준정규분포의 분위수 함수. 문턱을 이렇게 잡으면 층 하나의 검출률은 와 상관없이 정확히 다 |
이 모형의 좋은 점은 층마다의 성적표를 그대로 둔 채 상관만 바꿀 수 있다는 것이다. 각 층을 따로 평가하면 가 얼마든 똑같이 70·50·60% 로 보인다. 층 하나씩 재는 것으로는 상관이 드러나지 않는다.
평균의 분산 노트에서 본 것과 같은 구조다. 앙상블에서 모델 개의 평균 분산은 이고, 을 늘려도 는 남는다. 겹겹 방어의 놓침에도 겹을 늘려도 줄지 않는 부분이 있다.
외부 감사는 표본을 본다
외부 감사인은 모든 기록을 다 볼 수 없다. 건 중 건을 무작위로 뽑아 본다. 불량률이 일 때 표본에 불량이 하나라도 들어올 확률은 (복원추출로 근사하면) 다음과 같다.
| 기호 | 뜻 |
|---|---|
| 감사 대상 기록 전체 수 (모집단) | |
| 감사인이 뽑아 보는 기록 수 (표본) | |
| 불량 기록의 비율 | |
| 95% 확률로 불량을 하나라도 발견하려면 필요한 표본 수. 이라서 |
같은 식을 거꾸로 읽으면 3의 법칙(rule of three) 이 나온다. 건을 봤는데 불량이 0건이라면, 불량률의 95% 상한은 대략 이다. 0건 발견은 “불량이 없다”가 아니라 ” 보다는 드물다” 이다. 표본 오차 노트의 신뢰구간을 관측이 0건인 끝자락에서 쓴 것이다.
내부팀은 카나리를 심는다
둘째 겹의 일은 “감시기가 의도대로 도는지” 확인하는 것이다. 감시기 자체를 감시하는 방법은 진짜 사고를 기다리는 것이 아니라 답을 아는 가짜 사고(카나리) 를 일부러 흘려 넣고, 몇 개를 잡는지 세는 것이다.
카나리 개 중 잡힌 수 는 이항분포 를 따른다( 은 감시기의 재현율, 곧 진짜 문제 중 잡는 비율). 평소 재현율이 일 때 헛경보가 5% 이하가 되도록 문턱 를 정하고, 면 경보를 울린다. 질문은 이것이다. 재현율이 몰래 으로 떨어졌을 때 경보가 울릴 확률(검출력)은 얼마인가.
3. 직접 재 보기
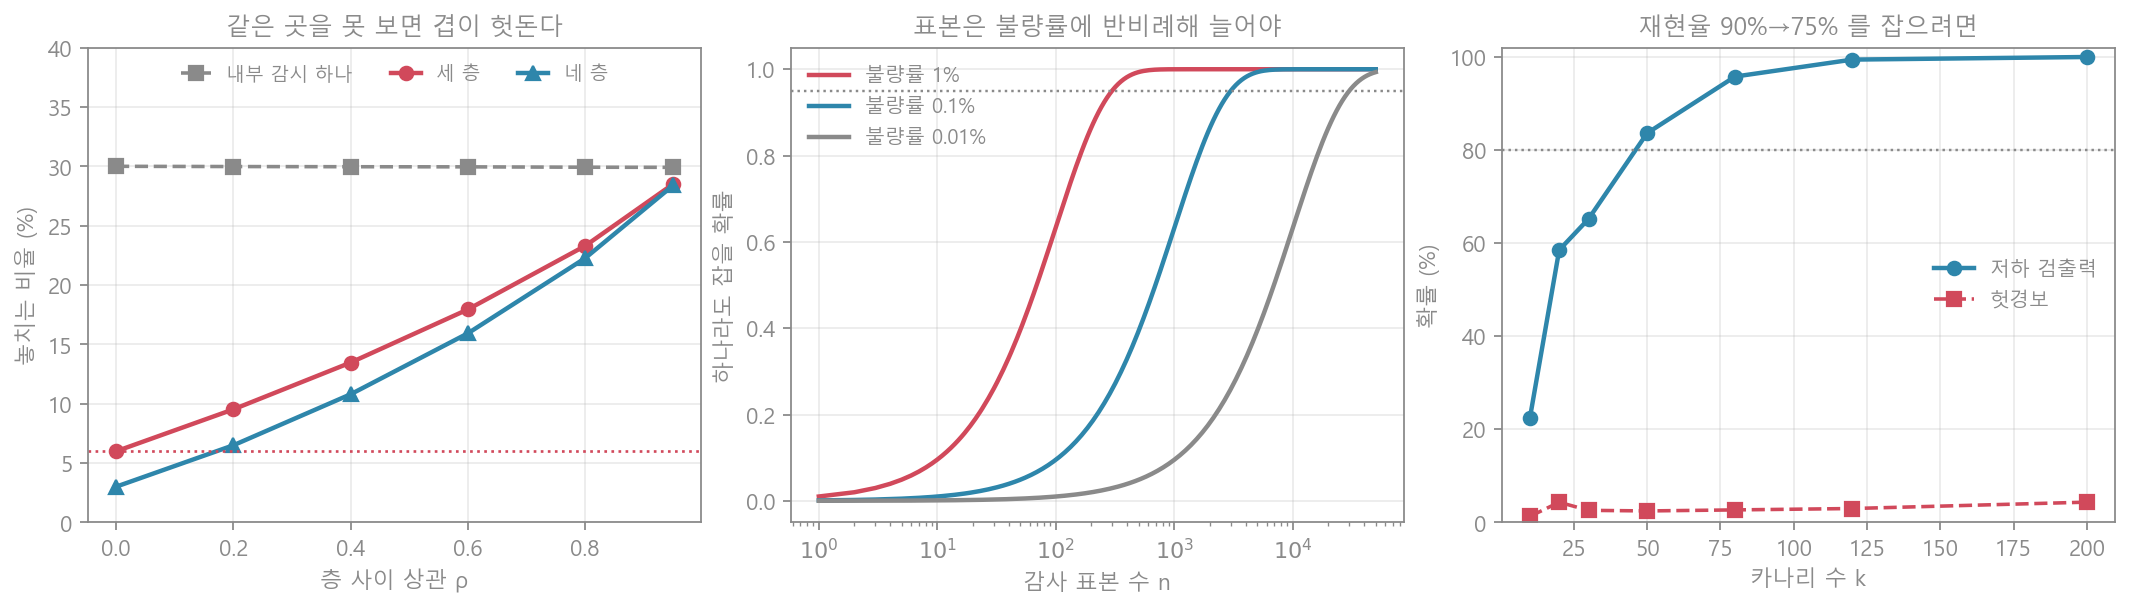
[A] 층 사이 상관이 놓침을 몇 배로 만드나
사건 100만 건을 모의했다. 층별 실측 검출률은 모든 에서 0.70·0.50·0.60 과 0.002 안으로 같았다.
| 층 사이 상관 | 감시 하나 놓침 | 세 층 놓침 | 독립 공식 대비 | 네 층 놓침 |
|---|---|---|---|---|
| 0.00 | 30.0% | 6.0% | ×1.0 | 3.0% |
| 0.20 | 30.0% | 9.5% | ×1.6 | 6.5% |
| 0.40 | 30.0% | 13.5% | ×2.2 | 10.8% |
| 0.60 | 30.0% | 17.9% | ×3.0 | 15.9% |
| 0.80 | 30.0% | 23.3% | ×3.9 | 22.3% |
| 0.95 | 30.0% | 28.5% | ×4.7 | 28.4% |
“네 층”은 검출률 50% 인 탐지층을 하나 더 붙인 경우다.
읽을 것이 둘이다.
- 곱셈 공식은 상관 0.2 에서도 1.6배 틀린다. 층별 성적표만 보고 “6% 만 새어 나간다”고 보고하면, 상관이 0.8 일 때 실제는 네 배다.
- 겹을 하나 더 쌓는 값이 상관에 따라 사라진다. 독립이면 넷째 층이 놓침을 6.0% → 3.0% 로 절반으로 줄인다. 상관 0.8 이면 23.3% → 22.3%, 상관 0.95 면 28.5% → 28.4% 다. 같은 눈을 하나 더 다는 것은 거의 아무것도 더 보지 못한다.
그래서 겹겹 방어에서 중요한 것은 겹의 수보다 겹의 다름이다. 외부 감사가 회사 내부 감시기의 경보 목록을 다시 훑는 식이면 상관이 높고, 원시 기록을 직접 뽑거나 다른 방법(예: 모델에 직접 시험 과제를 주는 레드팀)으로 보면 상관이 낮다. 협약 전문은 층들이 무엇을 기준으로 보는지는 정하지 않았다.
[B] 외부 감사는 몇 건을 봐야 하나
기록 10만 건 중에서 뽑아 보는 감사를 초기하분포(비복원추출)로 정확히 셈하고, 2만 번의 모의 감사로 확인했다.
| 불량률 | 불량 건수 | 95% 로 잡는 최소 표본 | 근사 | 모의 검출률 |
|---|---|---|---|---|
| 1% | 1,000 | 298 | 300 | 95.0% |
| 0.1% | 100 | 2,950 | 2,996 | 95.0% |
| 0.01% | 10 | 25,886 | 29,957 | 94.9% |
불량률이 열 배 드물어지면 표본도 열 배 필요하다. 마지막 줄만 근사보다 4천 건쯤 적은 것은, 표본이 모집단의 4분의 1을 넘으면 비복원추출이 “같은 기록을 두 번 보지 않는” 이득을 주기 때문이다. 표본이 모집단보다 훨씬 작을 때는 모집단 크기가 거의 상관없다.
0건 발견이 말해 주는 상한(95%):
| 본 표본 | 정확한 상한 | 3의 법칙 |
|---|---|---|
| 30 | 9.503% | 10.000% |
| 100 | 2.951% | 3.000% |
| 300 | 0.994% | 1.000% |
| 1,000 | 0.299% | 0.300% |
| 3,000 | 0.100% | 0.100% |
일 때 실제 불량률이 딱 상한(0.99%)이라면 0건이 나올 확률이 5.00% 인 것도 확인했다. 상한의 정의 그대로다.
이제 [A]의 상관을 감사에 대입해 보자. 감사인이 회사가 건넨 기록 풀에서만 뽑는데, 그 풀에서 불량의 일부가 빠져 있다면 (불량률 1%, 표본 298건):
| 불량 중 풀 밖에 있는 비율 | 검출 확률 |
|---|---|
| 0% | 95.0% |
| 50% | 77.8% |
| 90% | 26.0% |
표본 수를 계산대로 채워도, 표본을 뽑는 풀이 가려져 있으면 검출률은 95% 에서 26% 로 떨어진다. 표본 크기는 정직한 무작위 추출을 전제로 한 약속이다. 누가 풀을 정하는지가 감사의 독립성이다.
[C] 카나리 몇 개로 감시기의 성능 저하를 잡나
감시기의 재현율이 평소 90% 에서 조용히 75% 로 떨어졌다고 가정했다. 헛경보는 5% 이하로 묶었다.
| 카나리 | 경보 문턱 (이하면 경보) | 헛경보 | 저하 검출력 |
|---|---|---|---|
| 10 | 6개 | 1.3% | 22.4% |
| 20 | 15개 | 4.3% | 58.5% |
| 30 | 23개 | 2.6% | 65.2% |
| 50 | 40개 | 2.5% | 83.6% |
| 80 | 66개 | 2.7% | 95.8% |
| 120 | 101개 | 3.0% | 99.4% |
| 200 | 172개 | 4.3% | 100.0% |
(5만 번 모의로 잰 검출력은 표의 값과 0.4%p 안에서 맞았다.)
- 검출력 80% 를 넘기는 최소 카나리 수는 40개다. 90% 와 75% 는 커 보이는 차이지만, 카나리 10개로는 다섯 번에 한 번만 잡는다.
- 검출력이 를 따라 매끈하게 오르지 않는다(20개 58.5%, 30개 65.2%). 잡힌 수가 정수라서 문턱을 헛경보 5% 에 딱 맞출 수 없기 때문이다. 30개에서는 헛경보가 2.6% 로 필요 이상 보수적이다.
- 매주 카나리 20개씩 넣고 주마다 검정하면, 한 주 검출력 58.5% 로 저하 뒤 경보까지 평균 1.71주, 90% 는 3주 안에 울린다. 한 번에 많이 넣지 않아도 되풀이하면 잡히지만, 그 사이 몇 주는 성능이 떨어진 감시기가 돌고 있다.
4. 흔한 오해와 한계
“네 겹이니 네 배 안전하다.” 넷째 겹인 이사회 위원회는 문제를 찾는 층이 아니라 보고를 받는 층이다. 그 효과는 검출률이 아니라, 찾은 문제가 실제로 고쳐지는지(수정률)에 있다. 이 글의 모형은 검출만 다뤘다.
“층마다 성적이 좋으면 전체도 좋다.” [A]에서 층별 검출률은 상관과 무관하게 같았다. 전체 놓침은 층을 함께 시험해야만 보인다. 같은 사건 묶음을 모든 층에 흘려 보내고 “모두 놓친 사건”을 세는 것이 필요한 측정이다.
“외부 감사에서 아무것도 안 나왔으니 안전하다.” 0건 발견은 이라는 상한만 준다. 300건을 봤다면 “1% 보다 드물다”까지만 말할 수 있다. 사이버·생물·화학 위협처럼 한 건의 무게가 큰 문제에 1% 상한은 충분한 보증이 아니다.
“측정하면 된다.” 감사가 보는 지표는 곧 회사가 맞추는 지표가 된다. 명세 게이밍 편의 굿하트 법칙이 감사에도 그대로 선다. 카나리가 진짜 사고와 구별되는 모양이면 감시기는 카나리만 잘 잡도록 맞춰질 수 있다.
모형의 한계. 상관을 공통 요인 하나로만 만들었다. 실제로는 층마다 약점이 다르고(어떤 사건은 감시기만 못 보고, 어떤 사건은 감사만 못 본다), 그 구조에 따라 겹의 가치가 달라진다. 모든 확률은 가정값이라서, 이 글의 결론은 “몇 %“가 아니라 “곱셈이 몇 배까지 틀릴 수 있는가” 이다.
5. 한 문단 요약
백악관 초지능 협약은 내부 감시, 내부 검증팀, 외부 감사, 이사회 위원회라는 네 겹의 통제를 약속했다. 겹겹 방어는 층들이 서로 다른 곳을 볼 때만 곱셈으로 강해진다. 70·50·60% 를 잡는 세 층의 놓침은 독립이면 6.0% 지만 상관 0.8 이면 23.3% 이고, 층을 하나 더 쌓아도 1%p 밖에 줄지 않는다. 외부 감사는 불량률 1% 를 95% 로 잡으려면 표본 298건, 0.01% 면 2만 5천 건이 필요하다. 0건 발견은 이라는 상한일 뿐이고, 표본을 뽑는 풀이 가려지면 검출률은 95% 에서 26% 로 떨어진다. 감시기의 재현율이 90% 에서 75% 로 떨어진 것을 80% 확률로 잡으려면 카나리 40개가 필요했다. 협약이 정하지 않은 것은 층들이 무엇을 보고, 누가 표본을 고르는가이고, 그것이 겹의 수보다 결과를 더 크게 바꾼다.
참고
- 협약 전문: Washington Examiner — READ IN FULL: White House Accord on Super Intelligence (2026-09-29)
- Nextgov — White House unveils ‘super intelligence’ executive order and industry accord (2026-09-29)
- NPR — Trump says top tech firms have signed accord to ‘self-police’ AI development (2026-09-30)
- GovConWire — Trump Signs ‘Super Intelligence’ EO, Industry Accord
- The Week — Inside Trump’s four-step accord on ‘Super Intelligence’ (2026-09-30)
- 연재: 표본 오차 노트 · 평균의 분산 노트 · 명세 게이밍 편