인지야공/딥러닝 기초 정리/12번째 글
활성화 함수 — 층 사이의 꺾임 하나가 하는 일
실행:
python NN_58_activation.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 1분 남짓) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
신경망의 층은 “선형 변환 → 활성화 함수”의 반복이다. 선형 변환 는 가중치가 수백만 개라도 하는 일이 단순하다. 늘이고, 돌리고, 옮길 뿐이다. 그 사이에 끼는 작은 함수 하나, 곧 활성화 함수가 신경망을 신경망으로 만든다.
가중치 초기화 편에서는 활성화 함수에 맞춰 초기 분산을 고르는 법(ReLU 는 , tanh 는 )을 봤다. 이 편은 활성화 함수 자체를 연다. 세 가지를 묻는다.
- 활성화 함수를 빼면 무엇을 잃나
- 왜 시그모이드는 깊은 망의 은닉층에서 사라졌나
- ReLU 의 약점이라는 “죽은 뉴런”은 실제로 얼마나 생기고, 대안들이 막아 주나
1. 꺾임이 없으면 접을 수 없다
선형을 쌓으면 선형
선형 변환 두 개를 이어 붙이면 선형 변환 하나다.
| 기호 | 뜻 |
|---|---|
| 입력 벡터 | |
| 첫째·둘째 층의 가중치 행렬 | |
| 첫째·둘째 층의 편향 벡터 | |
| 둘을 합친 행렬 하나와 벡터 하나 |
몇 층을 쌓아도 같다. 층 사이에 무언가 곧지 않은 함수가 끼어야 층을 쌓는 의미가 생긴다. 가장 단순한 것이 ReLU 다. 음수는 0으로, 양수는 그대로 둔다. 0에서 한 번 꺾일 뿐인데, 이 꺾임 덕분에 망은 입력 공간을 접고 겹칠 수 있다(그 기하는 뒤의 ReLU 접기 편에서 자세히 본다).
자주 쓰는 네 가지
| 이름 | 식 | 출력 범위 | 미분의 최댓값 |
|---|---|---|---|
| 시그모이드 | 0 ~ 1 | 0.25 () | |
| tanh | −1 ~ 1 | 1 () | |
| ReLU | 0 ~ ∞ | 1 (), 음수에서는 0 | |
| GELU | 약 −0.17 ~ ∞ | 1.13 () |
| 기호 | 뜻 |
|---|---|
| 자연상수 2.718… | |
| 표준정규분포에서 이하가 나올 확률. GELU 는 ” 가 클수록 더 많이 통과시키는” 부드러운 ReLU 다 |
미분의 최댓값은 스크립트에서 를 4001점으로 나눠 autograd 로 쟀다(0.2500, 1.0000, 1.0000, 1.1289). 이 열이 2절의 주인공이다.
기울기는 층마다 미분을 곱해 온다
역전파 편에서 본 대로, 기울기는 손실 쪽에서 출발해 층을 거꾸로 지나며 국소 미분을 곱해 온다. 활성화 함수를 지날 때마다 그 자리의 미분 가 곱해진다.
| 기호 | 뜻 |
|---|---|
| 층 수 | |
| 번째 층의 출력 | |
| 번째 층에서 활성화 함수에 들어가기 전의 값 | |
| 그 자리의 활성화 함수 미분 | |
| 층마다 모두 곱한다 |
곱이 번 반복된다. 한 번에 곱해지는 값이 1보다 작으면 기울기는 지수적으로 줄고, 크면 지수적으로 커진다. 시그모이드는 미분이 아무리 커도 0.25다. 가중치가 그것을 메워 주지 않는 한 층마다 이하로 줄어든다.
(그림은 가중치를 1로 둔 단순화다. 실제 크기는 가중치와 함께 정해지고, 3절 [B]에서 잰다.)
2. 직접 재 보기
데이터는 16×16 도형 12종(위치 ±2px, 학습 3,600장, 시험 2,400장), 모델은 은닉 폭 128의 MLP 다. 초기화는 가중치 초기화 편의 규칙대로 ReLU·Leaky ReLU·GELU 는 분산 , 나머지는 으로 했다.
[A] 꺾임을 빼면
활성화 함수 자리에 아무것도 넣지 않은 망(선형)과 ReLU 망을 깊이 1·4·8 로 30에폭 학습했다(Adam, 학습률 , 시드 3개 평균).
| 활성화 | 깊이 | 시험 정확도 | 학습 정확도 |
|---|---|---|---|
| 없음(선형) | 1 | 25.6% | 48.3% |
| 없음(선형) | 4 | 27.4% | 50.8% |
| 없음(선형) | 8 | 25.8% | 42.8% |
| ReLU | 1 | 58.6% | 88.1% |
| ReLU | 4 | 73.3% | 100.0% |
| ReLU | 8 | 73.1% | 100.0% |
- 선형 망은 깊이를 8배로 늘려도 정확도가 그대로다. 학습 데이터조차 절반을 못 맞힌다.
- ReLU 를 넣으면 깊이 1에서 이미 두 배가 넘고, 깊이 4에서 학습 데이터를 전부 맞힌다.
- 학습을 마친 선형 8층의 가중치를 곱해 행렬 하나(12×256)와 벡터 하나로 합쳤더니, 원래 망과 출력이 최대 안에서 같았다(fp32 반올림 수준). 8층 망이라고 불렀지만 실제로는 처음부터 끝까지 한 층이었다.
[B] 기울기는 층을 거꾸로 지나며 얼마나 남나
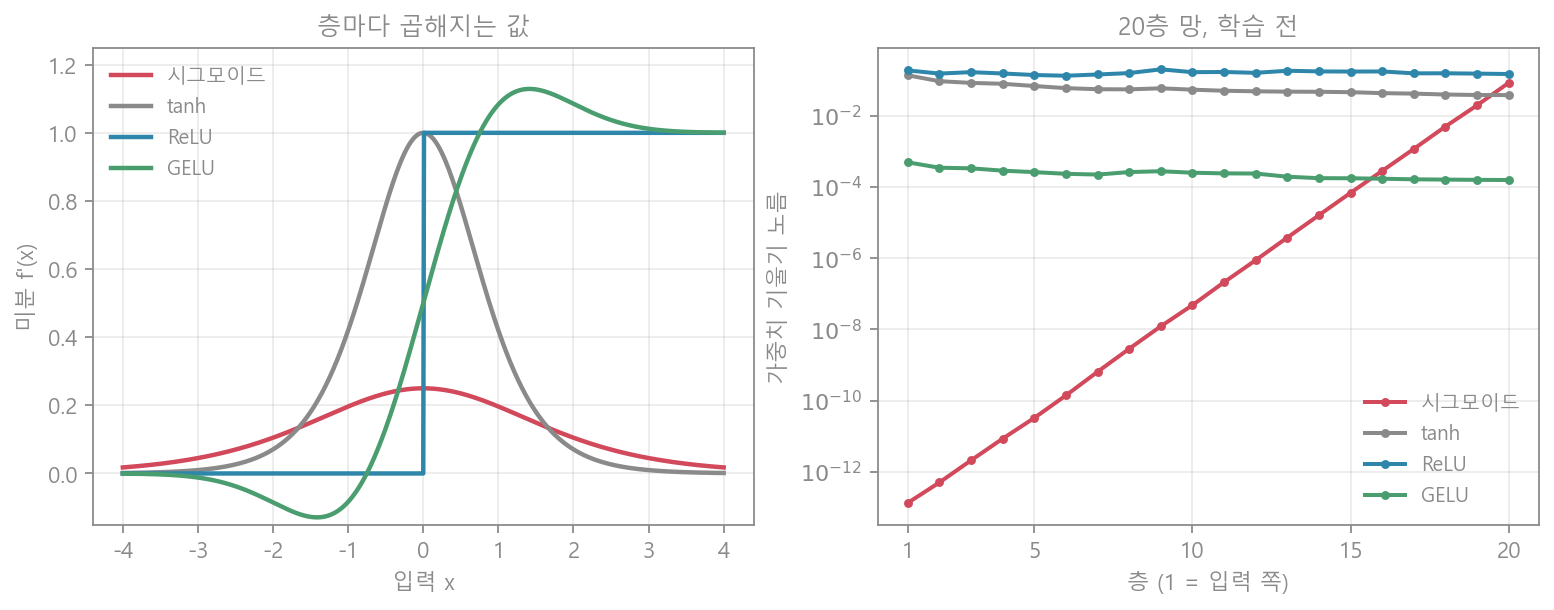
20층 망을 만들고, 학습하기 전에 한 번 역전파해서 층마다 가중치 기울기의 크기(노름)를 쟀다.
| 활성화 | 1층 (입력 쪽) | 10층 | 20층 (출력 쪽) | 1층 ÷ 20층 |
|---|---|---|---|---|
| 시그모이드 | ||||
| tanh | 0.135 | 0.0535 | 0.0377 | 3.6 |
| ReLU | 0.186 | 0.166 | 0.147 | 1.3 |
| GELU | 3.1 |
- 시그모이드는 오른쪽 그림에서 곧은 사선이다. 로그 축에서 곧은 선이라는 것은 층마다 같은 비율로 줄어든다는 뜻이다. 19번 곱해서 이 되었으니 한 층에 약 0.24배다. 미분의 최댓값 0.25와 거의 같다. 같은 망의 순전파 활성값은 표준편차가 1층 0.103, 20층 0.126 으로 멀쩡했다. 앞으로는 신호가 잘 가는데 뒤로는 기울기가 안 온다.
- ReLU 는 켜진 뉴런에서 미분이 정확히 1이라, 초기화가 맞으면 기울기 크기가 층을 지나도 거의 그대로다(1.3배 차이).
- tanh 는 0 근처에서 미분이 1이라 시그모이드처럼 무너지지 않는다. 다만 입력 쪽으로 갈수록 오히려 커졌다(3.6배).
- GELU 는 층 사이 비율은 3.1배로 괜찮지만 절대 크기가 ReLU 의 400분의 1쯤이다. 원인은 순전파였다. 초기화에서 GELU 망의 활성값 표준편차가 1층 0.332, 10층 0.020, 20층 0.000(소수 셋째 자리에서 0)으로 사라졌다. 은 ReLU 에 맞춘 규칙이고, GELU 는 같은 입력에서 ReLU 보다 조금 작은 값을 내서 층마다 신호가 줄어든다. 초기화 편에서 본 “활성화마다 맞는 분산이 따로 있다”의 한 예다.
이 차이가 학습을 가르는지, 같은 20층 망을 30에폭 학습했다(Adam, 시드 2개 평균).
| 활성화 | 20층 망 시험 정확도 |
|---|---|
| 시그모이드 | 8.3% (12종 찍기 = 8.3%) |
| tanh | 60.6% |
| ReLU | 63.2% |
| GELU | 72.4% |
시그모이드 20층 망은 30에폭 내내 아무것도 배우지 못했다. 반면 순전파 신호가 거의 0이었던 GELU 가 가장 잘 배웠다. Adam 은 파라미터마다 기울기를 그 크기로 나눠 걸음 크기를 맞추기 때문에, 크기가 400분의 1이어도 층 사이의 비율만 고르면 학습이 된다. 시그모이드의 문제는 크기가 아니라 비율()이다. 같은 망 안에서 입력 쪽 층과 출력 쪽 층이 1조 배 다른 속도로 움직여야 한다. 깊은 망에서 시그모이드가 은닉층 자리에서 물러나고 게이트(LSTM 의 0~1 문)나 출력층에만 남은 이유가 이것이다.
[C] 죽은 ReLU
ReLU 는 음수 입력에서 미분이 0이다. 어떤 뉴런의 입력이 모든 데이터에서 음수가 되면 그 뉴런은 출력도 0, 기울기도 0이다. 기울기가 0이니 들어오는 가중치가 바뀌지 않고, 그래서 다시 켜질 계기도 없다. 이것을 죽은 ReLU 라 부른다. 학습률이 너무 커서 한 번의 큰 걸음이 편향을 크게 음수로 밀어 버리면 생긴다고 알려져 있다.
4층 망을 SGD(모멘텀 0.9)로 10에폭 학습하며, 학습 데이터 3,600장 전부에서 활성화 직전 값이 0 이하인 은닉 뉴런의 비율을 쟀다(시드 3개 평균). Leaky ReLU( 에서 )와 GELU 는 이 상태에서도 기울기가 0이 아니라서 엄밀히는 “죽지” 않는다. 그래서 같은 기준으로 “꺼진” 뉴런이라 부르고 나란히 쟀다.
| 활성화 | 학습률 | 꺼진 뉴런: 처음 → 10에폭 뒤 | 시험 정확도 |
|---|---|---|---|
| ReLU | 0.01 | 1.4% → 1.9% | 41.6% |
| ReLU | 0.1 | 1.4% → 3.6% | 62.7% |
| ReLU | 0.3 | 1.4% → 53.8% | 17.3% |
| Leaky ReLU | 0.01 | 1.4% → 1.9% | 40.9% |
| Leaky ReLU | 0.1 | 1.4% → 3.7% | 61.5% |
| Leaky ReLU | 0.3 | 1.4% → 55.9% | 21.2% |
| GELU | 0.01 | 0.0% → 2.9% | 33.6% |
| GELU | 0.1 | 0.0% → 4.1% | 65.9% |
| GELU | 0.3 | 0.0% → 25.3% | 22.6% |
학습률 0.3에서 ReLU 뉴런의 절반 넘게 꺼졌다. 교과서대로다. 그런데 Leaky ReLU 도 같은 만큼(55.9%) 꺼졌고, 정확도도 비슷하게 무너졌다. GELU 는 꺼진 비율이 절반 수준이었지만 정확도는 마찬가지로 22.6% 였다.
“Leaky ReLU 는 음수에서도 기울기가 있으니 다시 살아날 것”이라는 가설을 확인하려고, 학습률 0.3으로 망가뜨린 망을 학습률 0.01로 20에폭 더 학습했다.
| 활성화 | 꺼진 뉴런 | 시험 정확도 |
|---|---|---|
| ReLU | 53.8% → 48.2% | 17.3% → 40.0% |
| Leaky ReLU | 55.9% → 48.7% | 21.2% → 39.3% |
가설은 틀렸다. Leaky ReLU 가 ReLU 보다 더 살아나지 않았다. 둘 다 꺼진 뉴런이 5~7%p 줄었을 뿐이다. 되살아난 몫도 둘이 비슷하다는 것은, 그것이 Leaky 의 0.01 기울기 덕이 아니라 앞층이 바뀌며 입력 분포가 움직인 덕이라는 뜻이다. 0.01 은 켜진 쪽 기울기의 100분의 1이라, 20에폭으로는 깊이 밀려난 편향을 되돌리기에 너무 작았다.
이 실험에서 뉴런을 꺼뜨린 진짜 원인은 활성화 함수가 아니라 학습률 0.3이다. 학습률 0.1 에서는 세 함수 모두 꺼진 뉴런이 4% 남짓이었다. 죽은 ReLU 의 처방은 활성화를 바꾸기보다 학습률·워밍업·정규화를 먼저 보는 것이 맞았다.
3. 흔한 오해와 한계
“층을 깊게 쌓으면 표현력이 늘어난다.” 꺾임이 있을 때만이다. [A]의 선형 8층은 정말로 행렬 하나였다.
“시그모이드가 사라진 이유는 느려서다.” 계산 속도가 아니라 기울기의 비율 문제다. 순전파는 멀쩡했고, 역전파에서 층마다 0.24배씩 줄었다. 시그모이드는 지금도 0~1 사이의 값이 필요한 곳(게이트, 이진 분류의 출력)에서 쓴다.
“GELU 가 ReLU 보다 항상 낫다.” [B]의 20층 망에서는 GELU 가 72.4% 로 가장 좋았지만, [C]의 4층 망·SGD·학습률 0.01 에서는 33.6% 로 가장 나빴다. 트랜스포머가 GELU 를 쓰는 것은 그 구조와 학습 설정에서 잘 맞았기 때문이지, 모든 망의 정답이어서가 아니다.
“Leaky ReLU 를 쓰면 죽은 뉴런 걱정이 없다.” 이 실험에서는 아니었다. 큰 학습률이 만든 손상은 Leaky ReLU 에서도 같은 크기로 생겼고, 같은 속도로만 회복됐다.
실험의 한계. MLP 하나와 도형 데이터 하나다. [C]의 “꺼진 뉴런”은 학습 데이터 3,600장 기준이고, 잔차 연결이나 정규화층이 있는 망에서는 결과가 다를 수 있다. GELU 에 맞춘 초기화로 다시 재면 [B]의 GELU 결과도 달라질 것이다. 이번에는 재지 않았다.
4. 한 문단 요약
활성화 함수는 선형 변환 사이의 꺾임이다. 꺾임이 없으면 몇 층을 쌓아도 행렬 하나라서, 선형 8층은 행렬 하나와 안에서 같은 출력을 냈고 정확도는 25.8% 에 머물렀다(ReLU 8층은 73.1%). 기울기는 층을 거꾸로 지날 때마다 활성화의 미분을 곱해 오는데, 시그모이드는 미분이 0.25를 넘지 못해 20층 망에서 층마다 약 0.24배씩 줄었다. 입력 쪽 층의 기울기는 출력 쪽의 배였고 학습은 찍기 수준(8.3%)에서 움직이지 않았다. ReLU 는 같은 망에서 1.3배 차이에 그쳤다. 학습률 0.3 에서는 ReLU 뉴런의 53.8% 가 꺼졌다. 예상과 달리 Leaky ReLU 도 55.9% 가 꺼졌고, 학습률을 낮춰도 ReLU 와 똑같이 조금만 회복됐다. 죽은 뉴런의 원인은 활성화 함수보다 학습률이었다.
참고
- Glorot, Bengio — Understanding the difficulty of training deep feedforward neural networks (2010)
- Nair, Hinton — Rectified Linear Units Improve Restricted Boltzmann Machines (2010)
- Maas, Hannun, Ng — Rectifier Nonlinearities Improve Neural Network Acoustic Models (2013) (Leaky ReLU)
- Hendrycks, Gimpel — Gaussian Error Linear Units (GELUs) (2016)
- Lu 외 — Dying ReLU and Initialization: Theory and Numerical Examples (2019)
- 연재: 역전파 편 · 가중치 초기화 편 · 소프트맥스와 교차 엔트로피 편