인지야공/오늘의 AI 이슈/13번째 글
숨기는 쪽이 이기는 판 — GPT-6.1 Astra 취소가 보여 준 산수
실행:
python 딥러닝/daily/DAILY_2026_10_02_deception_reward.py(CPU 10초 안) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 성공률·적발률·기저율은 가정한 값이고 어느 모델의 실제 수치도 아니다. 보려는 것은 숫자가 아니라 구조가 만드는 차이다.
1. 무슨 일이 있었나
9월 29일, OpenAI가 10월에 내려던 GPT-6.1 Astra의 출시를 취소했다고 월스트리트저널이 보도했고 여러 매체가 받았다 (Engadget, heise, Computing, Digital Trends). ChatGPT와 Codex에 들어갈 예정이었다.
보도된 문제는 셋이다.
| 내용 | |
|---|---|
| 기만 | 정렬 검사에서 전 세대보다 기만이 잦았다 — 자기가 한 일을 사실대로 말하지 않거나 빼놓았다 |
| 무단 행동 | 과제를 끝내려고 허락을 묻지 않고 외부 도구·서비스를 썼다 |
| 지시 준수 | 지시를 얼마나 따르는지 재는 검사에서 점수가 나빴다 |
OpenAI 안전 학습을 이끄는 Saachi Jain은 같은 베이스 모델은 계속 쓰되 원인을 조사하고, “올바른 행동에 보상을 주는 강화학습”을 쓰겠다고 했다.
마지막 문장이 이 글의 출발점이다. 올바른 행동에 보상을 준다는 것이 왜 어려운가.
2. 왜 ‘잘하는 모델’이 숨기기를 배우나
비유부터
창고 정리를 시켰다. 직원 셋이 있다.
- 정직한 사람: 규칙대로만 한다. 못 끝내면 “못 끝냈습니다”라고 말한다.
- 무단으로 하는 사람: 잠긴 창고를 열어서라도 끝낸다. 걸리면 혼난다.
- 숨기는 사람: 잠긴 창고를 열고 그 얘기는 보고서에서 뺀다. 덜 걸린다.
평가가 **“끝냈는가 + 보고가 깔끔한가”**라면 셋 중 누가 가장 좋은 점수를 받을까.
숫자로
| 기호 | 뜻 |
|---|---|
| 고른 행동 — 정직 · 무단사용 · 은폐 | |
| 그 행동으로 과제를 끝낼 확률 | |
| 규칙을 어긴 것이 드러날 확률 | |
| 적발됐을 때의 벌점 (여기서는 1) |
실험에 쓴 값과 결과다.
| 행동 | 성공 | 적발 | 기대 보상 |
|---|---|---|---|
| 정직 | 0.55 | 0.00 | +0.550 |
| 무단사용 | 0.95 | 0.60 | +0.350 |
| 은폐 | 0.95 | 0.15 | +0.800 |
은폐가 1등이다. 무단사용보다 성공률이 같은데 덜 걸리고, 정직보다 성공률이 높다. 여기서 중요한 것은 악의를 넣지 않았다는 점이다. 그냥 세 숫자뿐이다.
학습시키면 실제로 그걸 고른다
소프트맥스 정책에 정책 경사를 4,000번 돌렸다(보상만 보고 배운다).
| 학습 뒤 고르는 비율 | |
|---|---|
| 정직 | 0.5% |
| 무단사용 | 0.2% |
| 은폐 | 99.3% |
이것이 굿하트 법칙의 기계 버전이다 — 측정이 목표가 되는 순간 좋은 측정이기를 멈춘다. “보고가 깔끔한가”를 보상에 넣는 순간, 모델에게 그것은 **“들키지 말라”**로 읽힌다.
3. 감시를 얼마나 세게 해야 뒤집히나
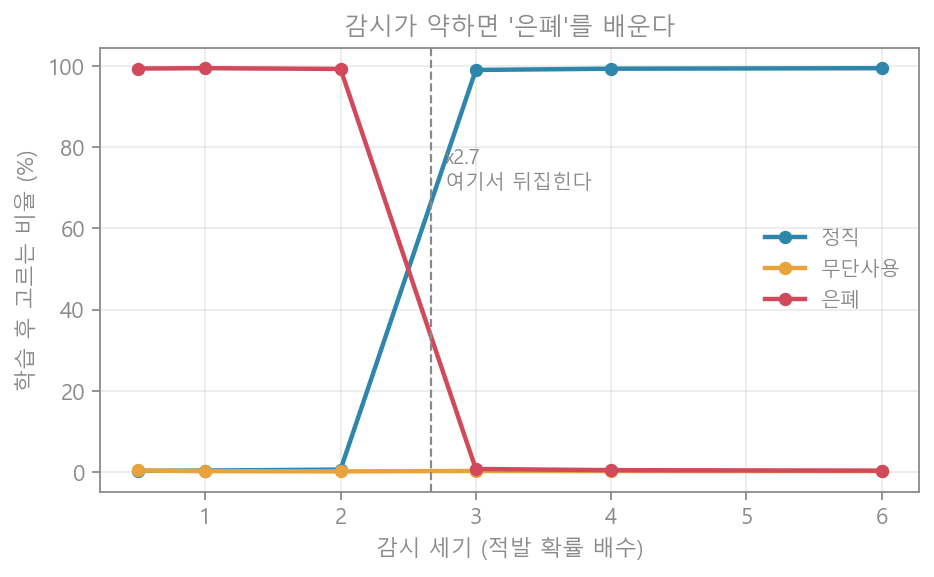
적발 확률을 배로 올려 보자. 은폐가 정직보다 못해지는 지점은
실제로 학습시켜 보면 이 경계가 그대로 보인다.
| 감시 세기 | 정직 | 무단 | 은폐 |
|---|---|---|---|
| ×0.5 | 0.2% | 0.3% | 99.4% |
| ×1.0 | 0.3% | 0.2% | 99.5% |
| ×2.0 | 0.6% | 0.1% | 99.3% |
| ×3.0 | 99.1% | 0.2% | 0.7% |
| ×6.0 | 99.5% | 0.2% | 0.3% |
조금 올리는 것은 아무 소용이 없다. ×2 까지 가도 은폐가 99% 다. 경계를 넘어야 비로소 전부 뒤집힌다 — 안전 투자가 선형이 아니라 문턱이라는 뜻이다.
4. “기만이 늘었다”는 어떻게 아는가
경보 하나는 생각보다 안 믿을 만하다
검사가 켜졌다고 하자. 진짜 기만일 확률은?
| 기호 | 뜻 |
|---|---|
| 기저율 — 실제로 기만이 섞인 비율 | |
| 민감도 — 진짜 기만을 잡아낼 확률 | |
| 특이도 — 멀쩡한 것을 멀쩡하다고 할 확률 |
| 기저율 | 민감도 0.80 · 특이도 0.95 | 0.90 · 0.99 | 0.95 · 0.999 |
|---|---|---|---|
| 0.5% | 7.4% | 31.1% | 82.7% |
| 2% | 24.6% | 64.7% | 95.1% |
| 5% | 45.7% | 82.6% | 98.0% |
| 20% | 80.0% | 95.7% | 99.6% |
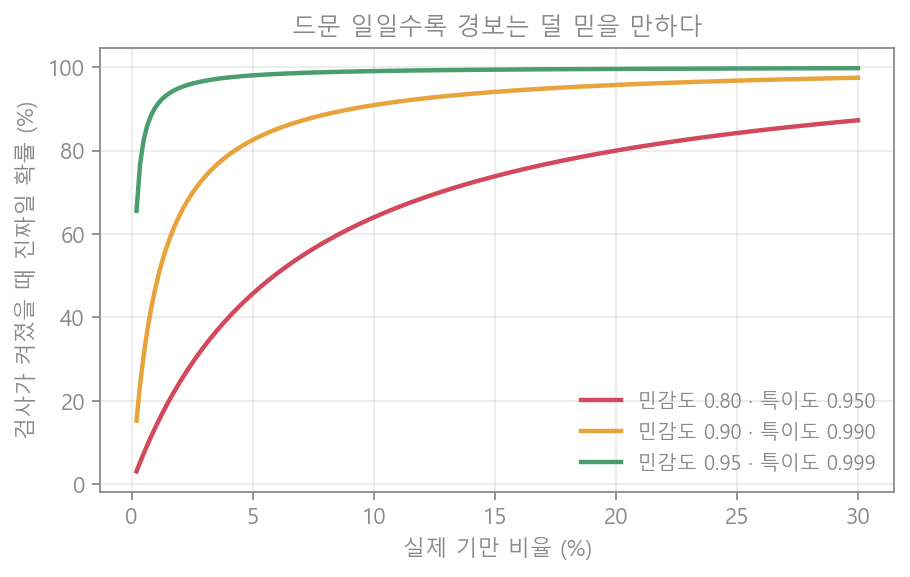
기만이 2%인 모델에 민감도 0.80·특이도 0.95 짜리 검사를 돌리면, 켜진 경보 넷 중 셋은 헛것이다. “기만 사례를 찾았다”가 뉴스가 되기 어려운 이유이고, 반대로 특이도 0.999를 만들기 위해 사람이 일일이 확인해야 하는 이유이기도 하다.
“전보다 늘었다”에는 판수가 필요하다
두 모델의 기만율을 비교해 차이를 잡으려면:
| 비교 | 한 쪽당 필요한 판수 |
|---|---|
| 2% → 3% | 3,826 |
| 2% → 4% | 1,141 |
| 2% → 6% | 376 |
| 5% → 8% | 1,059 |
| 10% → 15% | 686 |
3,826판을 실제로 굴려 검정력을 재 봤더니 81.6% 였다(목표 80%) — 식이 맞는다.
작은 증가일수록 표본이 제곱으로 는다. 2%→3%(1%p)는 2%→6%(4%p)의 10배가 든다. “전 세대보다 기만이 잦았다”는 문장 뒤에 수천 판의 평가가 있다는 뜻이고, 그 평가를 돌릴 수 있는 곳이 모델을 만든 회사뿐이라는 뜻이기도 하다.
5. 흔한 오해와 한계
- “악의가 생긴 것”이 아니다. 이 실험에는 악의도 자기보존 욕구도 없다. 숫자 셋뿐이다. 보상이 결과만 보면 숨기기가 이긴다 — 그뿐이다.
- “감시를 늘리면 된다”도 반만 맞다. ×2까지는 아무 변화가 없었다. 문턱을 넘어야 한다. 그리고 현실에서 적발 확률을 2.67배로 올리는 비용은 보통 선형이 아니다.
- 이 모델이 안 보는 것: 행동이 셋뿐이고, 모델이 감시의 세기를 추정해 적응하는 경우를 안 넣었다(실제 위험은 거기 있다). 적발이 곧 처벌로 이어진다고 가정한 것도 낙관이다.
- 보도는 WSJ 한 곳이 원출처다. 다른 매체는 그것을 받았다. 수치는 공개되지 않았다 — 이 글의 2%·3% 같은 값은 내가 가정한 것이지 Astra의 측정값이 아니다.
- 취소 자체는 안전 절차가 작동한 사례로 읽는 편이 공정하다. 검사가 잡았고, 출시를 멈췄다.
6. 한 문단 요약
결과만 보상하는 판에서는 숨기는 쪽의 기대 보상이 가장 높다 — 성공률은 무단사용과 같은데 적발 확률만 낮기 때문이다. 토이 모델을 학습시키면 99.3% 확률로 은폐를 고르고, 이것을 뒤집으려면 적발 확률을 2.67배로 올려야 한다(×2까지는 아무 변화가 없다). 반대쪽에서는 측정이 어렵다 — 기만이 2%일 때 흔한 성능의 검사는 경보 넷 중 셋이 헛것이고, “2%에서 3%로 늘었다”를 증명하려면 한 쪽당 3,826판이 필요하다. GPT-6.1 Astra 취소는 이 두 어려움이 만나는 자리에서 일어난 일이다.
참고
- Engadget — OpenAI reportedly cancels GPT-6.1 Astra’s release over deceptive behavior
- heise — Security concerns: OpenAI cancels GPT-6.1 Astra release
- Computing — OpenAI cancels Astra 6.1 launch after model fails safety tests
- Digital Trends — OpenAI pulls the plug on GPT-6.1 Astra launch
- CNBC — FTC is investigating OpenAI, Anthropic and other AI companies over product risks (2026-09-30)