인지야공/딥러닝 기초 정리/3번째 글
소프트맥스와 교차 엔트로피 — 분류는 무엇을 줄이나
실행:
python NN_57_softmax_ce.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 1분 안) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
PyTorch 치트시트 편에는 “모델 끝에 softmax를 넣지 말고 로짓을 그대로
nn.CrossEntropyLoss 에 넘겨라”는 규칙이 있었다. 역전파 편에서는 손실에서 출발해
기울기를 거꾸로 곱해 오는 법을 봤다. 이 편은 그 출발점, 곧 분류 모델이 줄이는 손실 자체를 연다.
세 가지를 답한다.
- 소프트맥스와 교차 엔트로피는 무엇이고, 왜 기울기가 그렇게 단순한가
- 왜 MSE 가 아니라 교차 엔트로피인가
- 왜 softmax 를 직접 계산하지 말라고 하는가, 그리고 다 맞힌 뒤에는 무슨 일이 일어나는가
1. 점수를 확률로, 확률을 벌점으로
소프트맥스 — 점수를 확률로
분류 모델의 마지막 층은 클래스마다 점수 하나를 낸다. 이 점수를 로짓(logit) 이라 부른다. 로짓은 아무 실수나 될 수 있다. 음수일 수도 있고 합이 1도 아니다. 확률로 바꾸려면 두 가지가 필요하다. 모두 양수로 만들고, 합을 1로 맞춘다.
| 기호 | 뜻 |
|---|---|
| 클래스 수 | |
| 클래스 의 로짓 (모델이 낸 점수) | |
| 지수함수. 어떤 실수든 양수로 만들고, 큰 점수를 더 크게 벌린다 | |
| 클래스 의 예측 확률. 모두 양수이고 합이 1이다 |
숫자로 따라가 보자. 클래스가 A·B·C 셋이고 로짓이 이다.
- . 합은 .
- 나누면 .
로짓 차이 1이 확률로는 2.7배() 차이가 된다. 소프트맥스는 차이만 본다. 모든 로짓에 같은 수를 더해도 확률은 그대로다. 이 성질이 3절의 수치 안정성 기법의 근거가 된다.
교차 엔트로피 — 정답에 준 확률의 로그
정답이 A라면, 모델이 A에 준 확률 가 클수록 좋다. 교차 엔트로피는 그 확률의 마이너스 로그다.
| 기호 | 뜻 |
|---|---|
| 정답 클래스 | |
| 모델이 정답에 준 확률 | |
| 손실. 이면 0, 이면 무한대 | |
| logsumexp. 가장 큰 로짓을 부드럽게 고른 값이다 |
위 예에서 이다. 정답에 1% 만 주었다면 이다. 틀린 데에 확신할수록 벌점이 끝없이 커진다는 것이 이 손실의 성격이다. 이름에 “엔트로피”가 붙은 이유는 엔트로피와 KL 발산 노트에 있다. 정답 분포(정답에 1, 나머지에 0)와 예측 분포 사이의 교차 엔트로피가 정확히 다.
기울기 — 예측 빼기 정답
을 로짓 로 미분하면 놀랍도록 단순해진다. 를 미분하면 정답 자리에만 , logsumexp 를 미분하면 소프트맥스 가 나온다.
| 기호 | 뜻 |
|---|---|
| 정답을 원-핫으로 쓴 것. 정답 자리만 1 | |
| 예측 확률과 정답의 차이. 이것이 그대로 로짓의 기울기다 |
예에서 기울기는 이다. 경사하강은 기울기의 반대로 움직이므로 정답 A의 로짓은 올리고, B·C의 로짓은 자기가 받은 확률만큼 내린다.
왜 MSE 가 아니라 교차 엔트로피인가
확률 와 원-핫 정답 의 거리를 제곱해서 줄여도(MSE) 되지 않을까? 기울기를 계산해 보면 차이가 보인다. 소프트맥스를 거친 MSE 의 정답 로짓 기울기는 이렇게 된다.
맨 앞에 가 곱해져 있다. 모델이 확신하며 틀려서 가 0에 가까우면, 괄호 안이 아무리 커도 기울기는 0에 가깝다. 가장 크게 틀렸을 때 가장 작게 배운다. 교차 엔트로피는 가 를 나눠 지워서 이 남는다. 가장 크게 틀렸을 때 가장 크게 배운다.
2. 직접 재 보기
데이터는 이 연재의 실험에서 자주 쓰는 16×16 도형 12종이다(학습 3,600장, 시험 2,400장, 모델은 은닉층 128의 MLP).
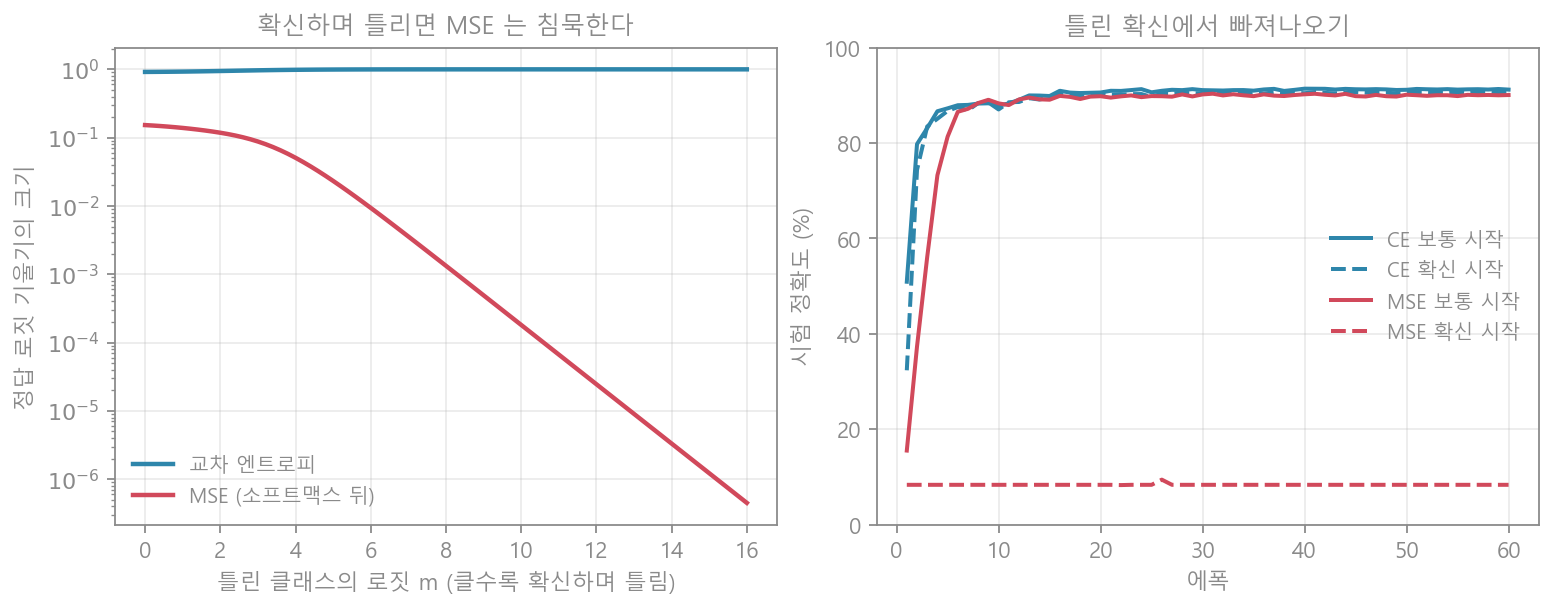
[A] p − y, 그리고 확신하며 틀린 출발
먼저 공식이 맞는지 확인했다. 무작위 로짓 64×12 에서 autograd 의 기울기와 손으로 쓴 의 최대 차이는 이었다(fp32 반올림 수준).
다음은 확신하며 틀린 상황이다. 정답(A)의 로짓은 0, 틀린 클래스 하나의 로짓을 으로 올려 가며 정답 로짓의 기울기를 쟀다(나머지 10개는 0).
| 틀린 로짓 | 정답 확률 | 교차 엔트로피 기울기 | MSE 기울기 |
|---|---|---|---|
| 0 | 0.0833 | −0.9167 | −0.153 |
| 4 | 0.0152 | −0.9848 | −0.0508 |
| 8 | 0.000334 | −0.9997 | −0.00133 |
| 12 | 0.00000614 | −1.0000 | −0.0000246 |
| 16 | 0.000000113 | −1.0000 | −0.00000045 |
교차 엔트로피의 기울기는 로 붙어 있고, MSE 의 기울기는 를 넘은 뒤로 4 늘 때마다 38~55배씩 줄었다. 에서는 두 기울기가 220만 배 차이다.
이것이 학습에서 어떻게 보이는지 쟀다. “보통 시작”은 기본 초기화, “확신 시작”은 출력층 편향으로 0번 클래스에 로짓 +12를 주고 시작한 것이다. 옵티마이저는 SGD(학습률 0.1, 모멘텀 0.9)다. Adam 은 기울기를 그 크기로 나눠서 크기 차이를 지워 버리므로, 기울기 크기가 걸음에 그대로 반영되는 SGD 로 비교했다. 시드 3개의 평균이다.
| 손실 | 시작 | 5에폭 | 20에폭 | 60에폭 |
|---|---|---|---|---|
| 교차 엔트로피 | 보통 | 87.3% | 90.6% | 91.2% |
| 교차 엔트로피 | 확신 | 86.7% | 90.2% | 90.5% |
| MSE | 보통 | 81.3% | 89.8% | 90.1% |
| MSE | 확신 | 8.3% | 8.3% | 8.3% |
- 보통 시작에서는 둘 다 90% 근처에 닿는다. MSE 가 조금 느릴 뿐이다.
- 확신 시작에서 MSE 는 60에폭 내내 8.3% 였다. 12종 중 하나를 찍는 확률 그대로다. 세 시드가 모두 같았다. 모든 샘플을 0번이라고 확신하니, 0번이 아닌 샘플의 기울기가 배로 눌려 거의 움직이지 못한다.
- 교차 엔트로피는 같은 출발에서 5에폭 만에 86.7% 로 빠져나왔다.
[B] 식 그대로의 소프트맥스는 어디서 깨지나
는 금방 커진다. 자료형마다 가 무한대(inf)가 되는 가장 작은 를 쟀다.
| 자료형 | 가 넘치는 |
|---|---|
| float32 | 88.73 |
| float16 | 11.09 |
| bfloat16 | 88.75 |
fp16 에서는 로짓 11이 넘으면 가 넘친다. 로짓 11은 학습 중에 흔히 나오는 크기다. 식 그대로( 를 계산하고 나누고 로그)와 logsumexp 방식을 비교했다.
| 로짓 | 정답 | 식 그대로 fp32 | logsumexp fp32 | 식 그대로 fp16 | logsumexp fp16 |
|---|---|---|---|---|---|
| (2, 0) | 0 | 0.1269 | 0.1269 | 0.1268 | 0.1270 |
| (10, 0) | 1 | 10.0000 | 10.0000 | 10.0000 | 10.0000 |
| (12, 0) | 1 | 12.0000 | 12.0000 | inf | 12.0000 |
| (50, 0) | 1 | 50.0000 | 50.0000 | inf | 50.0000 |
| (90, 0) | 0 | nan | 0.0000 | nan | 0.0000 |
| (0, 110) | 0 | inf | 110.0000 | inf | 110.0000 |
깨지는 방식은 두 가지다.
- 넘침: 이 inf 가 되면 이다. nan 은 한 번 생기면 역전파를 타고 모든 가중치로 번진다.
- 사라짐: 정답 확률이 자료형이 표현할 수 있는 가장 작은 수보다 작으면 0이 되고, 가 된다.
logsumexp 는 1절의 성질(모든 로짓에 같은 수를 더해도 확률은 그대로)을 쓴다. 가장 큰 로짓 을 빼고 계산한다.
이제 지수의 가장 큰 값은 이라 넘치지 않고, 합은 1 이상이라 로그가 로 가지 않는다.
F.cross_entropy 가 로짓을 받는 이유가 이것이다. 확률을 받으면 이미 깨진 값을 받을 수 있다.
치트시트의 “softmax 금지” 규칙은 이 표 한 장으로 설명된다. 자료형별 범위는 부동소수점 노트에 있다.
[C] 다 맞힌 뒤에도 — 로짓 간격과 라벨 스무딩
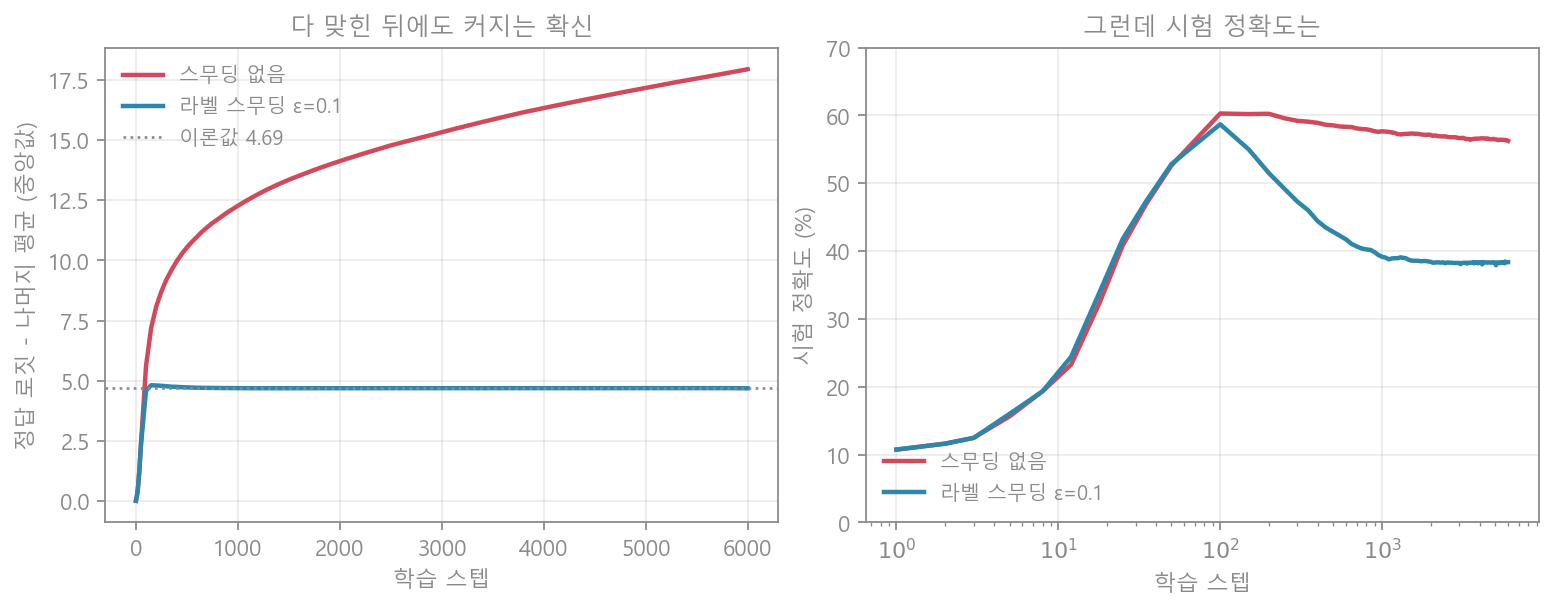
교차 엔트로피는 일 때만 0이 된다. 그런데 소프트맥스는 로짓이 유한하면 이다. 그러므로 학습 데이터를 전부 맞힌 뒤에도 손실을 더 줄일 방법이 있다. 정답 로짓과 나머지의 간격을 더 벌리는 것이다. 간격에는 끝이 없다.
라벨 스무딩은 정답 분포를 조금 흐리게 만든다. 정답에 , 나머지에 고르게 을 나눠 준다.
| 기호 | 뜻 |
|---|---|
| 스무딩 정도. 이 실험은 0.1 | |
| 흐리게 만든 정답. 면 정답 0.9083, 나머지 각 0.0083 | |
| 최적 간격 | 예측이 와 같아지는 로짓 차이. |
목표 자체가 1이 아니니 간격을 그 이상 벌리면 오히려 손실이 커진다. 멈출 곳이 생긴다.
일부러 다 외울 수 있게, 학습 데이터를 240장(클래스당 20)으로 줄이고 Adam 으로 6000스텝 돌렸다. 간격은 학습 데이터에서 “정답 로짓 − 나머지 로짓의 평균”의 중앙값이다. 아래 경과 표는 시드 5 하나의 값이다(시드 6·7의 최종 간격은 17.88·17.95, 4.70·4.69).
| 스무딩 없음 | 라벨 스무딩 | |
|---|---|---|
| 학습 정확도 100% 도달 | 100스텝 | 100스텝 |
| 간격: 1000스텝 | 12.27 | 4.69 |
| 간격: 3000스텝 | 15.32 | 4.69 |
| 간격: 6000스텝 | 17.94 | 4.69 (이론값 4.691) |
| 학습 손실 | 0.0000 | 0.5262 (최솟값 = 흐린 정답의 엔트로피 0.526) |
스무딩이 없으면 학습 정확도가 100스텝에 100%가 된 뒤로도 간격이 계속 벌어진다. 1000스텝에서 3000스텝 사이에 3.05, 3000스텝에서 6000스텝 사이에 2.62가 늘었다. 느려지지만 멈추지 않는다. 스무딩이 있으면 이론값 4.69 에 정확히 멈췄다.
그러면 스무딩이 더 좋은가? 시험셋(2,400장)에서 잰 결과는 예상과 달랐다(시드 3개 평균).
| 스무딩 없음 | 라벨 스무딩 | |
|---|---|---|
| 시험 정확도 | 56.0% (55.4~56.2) | 39.8% (38.4~40.6) |
| 평균 확신 | 83.9% | 43.2% |
| ECE (확신과 실제 정답률의 어긋남) | 28.0% | 4.3% |
- 확신은 정직해졌다. 스무딩 없는 모델은 정답률 56% 인데 평균 84% 를 확신했고(ECE 28.0%), 스무딩한 모델은 정답률 40% 에 확신 43% 였다(ECE 4.3%).
- 정확도는 16%p 떨어졌다. 나는 처음에 “스무딩이 간격 벌리기를 멈추게 해서 일반화를 해친다”고 짐작했는데, 시험 정확도 경과(오른쪽 그림, 시드 5)는 다른 이야기를 한다. 두 방법 모두 100스텝(학습 정확도 100%) 무렵이 꼭대기였다(60.3% 와 58.7%). 그 뒤 스무딩 없는 쪽은 60.3% → 56.2% 로 천천히 내려왔고, 스무딩한 쪽은 300스텝 47.3%, 1000스텝 39.2% 로 빠르게 내려왔다.
- 해석은 이렇다. 스무딩이 없으면 다 맞힌 뒤 가 0에 가까워져 기울기가 사라진다. 간격은 벌어지지만 망 전체는 거의 그대로다. 스무딩이 있으면 학습 손실 0.526 이라는 정확한 목표가 남아서, 240장의 로짓을 그 목표에 정확히 맞추느라 계속 외운다.
이것은 데이터 240장, 규제 없음, 6000스텝이라는 극단적인 외우기 상황의 결과다. 큰 데이터에서 라벨 스무딩이 정확도를 올린 보고(Szegedy 외 2016, Müller 외 2019)와 같은 조건이 아니다. 이 실험이 확실히 보여 주는 것은 두 가지다. 교차 엔트로피만으로는 확신이 끝없이 커지고, 스무딩은 그것을 정해진 값에서 멈춘다. 정확도까지 좋아지는지는 데이터 크기와 학습 길이에 달려 있다.
3. 흔한 오해와 한계
“소프트맥스 출력은 확률이니 믿어도 된다.” 합이 1이라는 뜻이지 맞을 확률이라는 뜻이 아니다. [C]에서 스무딩 없는 모델은 정답률 56% 에서 84% 를 확신했다. 이 어긋남을 재고 고치는 법은 뒤의 캘리브레이션 편에서 다룬다.
“MSE 로도 분류가 된다.” 보통 시작에서는 됐다(90.1%). 문제는 틀린 확신에서 빠져나오지 못하는 것이다. 초기화가 나쁘거나, 데이터 분포가 바뀌어 모델이 새 데이터에 확신하며 틀릴 때가 바로 그 상황이다.
“모델 끝에 softmax 를 넣고 CrossEntropyLoss 를 쓰면 된다.”
CrossEntropyLoss 는 안에서 다시 소프트맥스를 한다. 두 번 거치면 확률이 평평해져 학습이 느려지고, 넣은 softmax 가 [B]의 넘침을 그대로 겪는다.
“로짓 간격이 커지는 것은 잘 배우고 있다는 뜻이다.” [C]에서 간격이 12.27 에서 17.94 로 커지는 동안 시험 정확도는 57.7% 에서 56.2% 로 내려갔다. 간격은 확신의 크기일 뿐 일반화의 척도가 아니다.
실험의 한계. MLP 하나, 도형 데이터 하나, [C]는 240장이다. [A]의 “확신 시작”은 편향 하나로 만든 인공적인 출발이고, 실제로 이런 상태가 얼마나 흔한지는 재지 않았다. 온도로 소프트맥스를 부드럽게 하는 방법은 뒤의 디코딩 편과 지식 증류 편에서 다룬다.
4. 한 문단 요약
소프트맥스는 로짓을 지수로 양수로 만들고 합으로 나눠 확률로 바꾸고, 교차 엔트로피는 정답에 준 확률의 마이너스 로그다. 둘을 붙이면 로짓의 기울기는 한 줄이 되고, autograd 와 안에서 같았다. MSE 의 기울기에는 가 곱해져 있어 확신하며 틀릴수록 작아진다. 틀린 로짓 +16에서 교차 엔트로피 기울기의 220만분의 1이었고, 0번 클래스를 확신하며 시작한 MSE 는 60에폭 내내 8.3% 에 갇혔다(교차 엔트로피는 90.5%). 식 그대로의 소프트맥스는 fp16 에서 로짓 11.09 를 넘으면 무너지고, 최댓값을 빼는 logsumexp 는 같은 값을 안전하게 낸다. 다 맞힌 뒤에도 교차 엔트로피는 로짓 간격을 17.94 까지 벌렸고, 라벨 스무딩은 이론값 4.69 에서 정확히 멈췄다. 240장 실험에서 스무딩은 확신을 정직하게 만들었지만(ECE 28.0% → 4.3%), 정확도는 56.0% 에서 39.8% 로 떨어졌다.
참고
- PyTorch — CrossEntropyLoss (
label_smoothing인자 포함) - Szegedy 외 — Rethinking the Inception Architecture for Computer Vision (2016) (라벨 스무딩 제안)
- Müller, Kornblith, Hinton — When Does Label Smoothing Help? (2019)
- Goodfellow, Bengio, Courville — Deep Learning, 6.2.2 Output Units
- 연재: PyTorch 치트시트 편 · 역전파 편 · 엔트로피와 KL 발산 노트 · 부동소수점 노트