인지야공/오늘의 AI 이슈/16번째 글
예시 20개뿐인 사용자들을 누구와 묶어 배우게 할까 — 파레토 최적과 선호 정렬
실행:
python 딥러닝/daily/DAILY_2026_10_07_apo_pareto.py(CPU 1분 안쪽, numpy 와 scipy) 이 글의 실험 수치는 전부 그 스크립트를 돌려 얻은 것이다. 논문의 LLM 실험을 재현한 것이 아니라, 구조만 같은 10차원 장난감 문제다.
1. 무슨 일이 있었나
10월 5일, 홍콩성시대·워싱턴대·홍콩과기대 연구자 세 명(Liyan Yang, Yige Yuan, Zhiqin Yang)이 “Collaborative Personalized Preference Alignment for LLMs under Data Deficiency”를 arXiv 에 올렸다 (arXiv 2610.05898, Hugging Face 논문 페이지). 동료 평가를 거치지 않은 사전 공개 논문이다.
논문이 푸는 문제는 이렇다.
- 언어모델의 답에는 목표가 여럿 있다. 논문의 실험에서는 도움됨·안전함(Fed-ChatbotPA), 도움됨·정직함·사실성(UltraFeedback)이다.
- 사용자마다 그 목표들 사이에서 원하는 균형이 다르다.
- 한 사용자가 줄 수 있는 예시는 적다. 실험에서는 학습용 20개다.
방법의 이름은 APO(Approximate Pareto Optimality)다. 선호가 서로 맞는 사용자끼리 묶고, 묶음 안에서 함께 학습한 모델을 출발점으로 삼아 각자 20개 예시로 조금만 고친다.
논문 표 1의 수치(Llama-3.2-3B, UltraFeedback, 20개 예시로 적응한 뒤)는 평균 점수 0.74 → 0.79, 평균 하이퍼볼륨 0.41 → 0.48 이다. 비교 대상은 사용자 전원을 평균하는 FedAvg 다. 0.41 에서 0.48 은 17.1% 증가이고, 뉴스 요약들이 옮긴 “+17.1%“가 이 값과 맞는다. 표에는 조합이 넷(데이터 2종 × 모델 2종) 있고 폭은 조합마다 다르다. 모델은 30억 파라미터급 두 개(Llama-3.2-3B, Qwen2.5-3B)뿐이고, 더 큰 모델에서의 결과는 없다. 이 수치들은 논문 HTML 을 자동 추출로 읽은 것이라, 인용하려면 원문 표를 확인하기 바란다.
이 글은 논문의 세 가지 재료를 차례로 푼다. 파레토 최적, 체비쇼프 스칼라화, 하이퍼볼륨이다. 그리고 “묶으면 정말 나은가”를 작은 문제에서 재 본다.
2. 핵심 개념
파레토 최적 — 더 좋게 만들려면 다른 것을 내줘야 하는 점
중고차를 고른다고 하자. 싸고 주행거리가 짧은 차가 좋다. A 가 B 보다 싸면서 주행거리도 짧으면 B 를 볼 이유가 없다. 이럴 때 A 가 B 를 지배한다고 한다. 누구에게도 지배당하지 않는 차들만 남기면, 남은 차들 사이에서는 “더 싼 대신 더 많이 달린” 식의 맞교환만 있다. 이 남은 것들이 파레토 최적이고, 그것들을 이은 선이 파레토 앞면이다.
| 기호 | 뜻 |
|---|---|
| 모델의 파라미터. 고를 수 있는 “차” 하나에 해당한다 | |
| 목표의 수 | |
| 번째 목표의 손실. 작을수록 좋다 | |
| 파레토 최적 | 자신을 지배하는 가 하나도 없는 |
| 파레토 앞면 | 파레토 최적인 점들의 손실값 을 모은 것 |
파레토 앞면 위의 점은 전부 “최적”이다. 그중 어느 점을 고를지는 수학이 정해 주지 않는다. 사용자의 선호가 정한다.
선호와 체비쇼프 스칼라화 — 가장 아픈 곳부터 줄인다
사용자 의 선호를 가중치 벡터 로 쓴다. 성분은 모두 양수이고 합이 1 이다. 이면 목표 1 을 4배 더 중요하게 본다는 뜻이다.
여러 손실을 하나의 숫자로 합치는 것을 스칼라화라 부른다. 가장 흔한 것은 가중합이다. 논문은 다른 것을 쓴다.
| 기호 | 뜻 |
|---|---|
| 번째 목표의 가중치. 클수록 그 목표의 손실을 더 못 참는다 | |
| 가중 손실. “이 목표가 지금 얼마나 아픈가” | |
| 가중 손실 중 가장 큰 값 | |
| 병목 | 지금 가중 손실이 가장 큰 목표. 논문의 용어다 |
체비쇼프는 가장 아픈 목표(병목)만 본다. 그것을 줄이다 보면 다른 목표가 병목이 되고, 결국 모든 가중 손실이 같아지는 점에서 멈춘다. 둘째 줄이 그 뜻이다. 가중치가 4배인 목표는 손실이 4분의 1 이 된다. 선호가 손실의 비율을 직접 정한다. 논문은 이 조건을 만족하는 파레토 점을 “선호별 파레토 최적”이라 부른다.
숫자로 따라가 보자. 목표가 둘이고, 파레토 앞면 위의 점을 (0 과 1 사이) 하나로 나타낼 수 있어서 , 이라 하자(3절 실험의 문제가 이 꼴이다). 선호는 다.
| 고른 점 | 가중 손실 , | |||
|---|---|---|---|---|
| 가중합 최소 | 0.16 | 2.56 | 0.128, 0.512 | |
| 체비쇼프 최소 | 0.444 | 1.778 | 0.356, 0.356 |
가중합은 목표 1 을 거의 0 으로 누르고 목표 2 를 버렸다. 체비쇼프는 두 가중 손실을 0.356 으로 맞췄고, 손실의 비는 정확히 1 : 4 다.
지금 얼마나 치우쳐 있나 — 선호 균일도
학습 도중에는 가중 손실들이 같지 않다. 논문은 그 치우침을 숫자 하나로 잰다. 가중 손실을 합이 1 이 되게 나눈 뒤, 고른 분포 에서 얼마나 먼지를 쿨백-라이블러 발산으로 잰다.
| 기호 | 뜻 |
|---|---|
| 가중 손실 중 번째가 차지하는 몫. 전부 더하면 1 | |
| 선호 균일도. 0 이면 가중 손실이 모두 같다(원하는 균형에 있다). 클수록 한 목표에 치우쳐 있다 | |
| 자연로그 |
위 표의 가중합 답 (0.128, 0.512) 로 계산하면 몫은 (0.2, 0.8) 이고 이다. 체비쇼프 답은 몫이 (0.5, 0.5) 라서 이다.
논문의 갱신 규칙은 가 0 보다 크면 균형을 맞추는 쪽으로, 0 이면 균형을 유지한 채 모든 손실을 줄이는 쪽으로 움직인다. 이때 병목 목표는 나빠지지 않게 제약을 건다. “경사 하강에 통제된 상승을 섞는다”는 말은, 균형을 맞추려고 덜 아픈 목표의 손실이 잠시 오르는 것을 허용한다는 뜻이다.
누구와 묶을까 — 병목이 같은 사람끼리
사용자들의 갱신 방향을 평균하면 데이터 부족에서 오는 잡음이 줄어든다. 그런데 선호가 반대인 사람과 평균하면 방향이 서로를 지운다. 논문은 두 단계로 묶는다.
- 병목 순서: 같은 기준 모델에서 각 사용자의 가중 손실을 큰 순서로 줄 세운다. 순서가 같은 사용자끼리 먼저 묶는다. “지금 무엇이 가장 아픈가”가 같은 사람들이다.
- 조정 벡터: 각 묶음 안에서, 를 가장 빨리 바꾸는 방향(조정 벡터)이 가까운 사용자끼리 계층적 군집으로 다시 나눈다. 묶음의 총수는 미리 정한다(논문에서는 4 또는 8).
논문의 정리 3.3 은 묶음 안의 방향이 덜 흩어져 있을수록 함께 학습한 점이 각자의 최적에 가깝다는 것이고, 정리 3.4 는 새 사용자가 예시 개로 걸음 적응했을 때 남는 격차가 “출발점의 오차가 걸음마다 줄어드는 항 + 에 비례하는 잡음 항”으로 묶인다는 것이다. 두 정리 모두 논문이 둔 가정 아래의 결과다.
하이퍼볼륨 — 점들이 덮는 넓이
여러 해를 한꺼번에 평가하는 숫자가 하이퍼볼륨이다. 기준점(충분히 나쁜 점) 하나를 정하고, 해들이 지배하는 영역의 넓이를 잰다. 클수록 좋다.
손실이 (1, 3), (2, 2), (3, 1) 인 해 셋과 기준점 (4, 4) 로 계산해 보자.
점들이 원점 쪽으로 다가가거나(더 좋은 해) 앞면을 따라 넓게 퍼지면(더 다양한 해) 넓이가 는다. 하이퍼볼륨은 이 둘을 구별하지 않는다. 3절에서 이 점이 문제가 된다.
3. 직접 재 보기
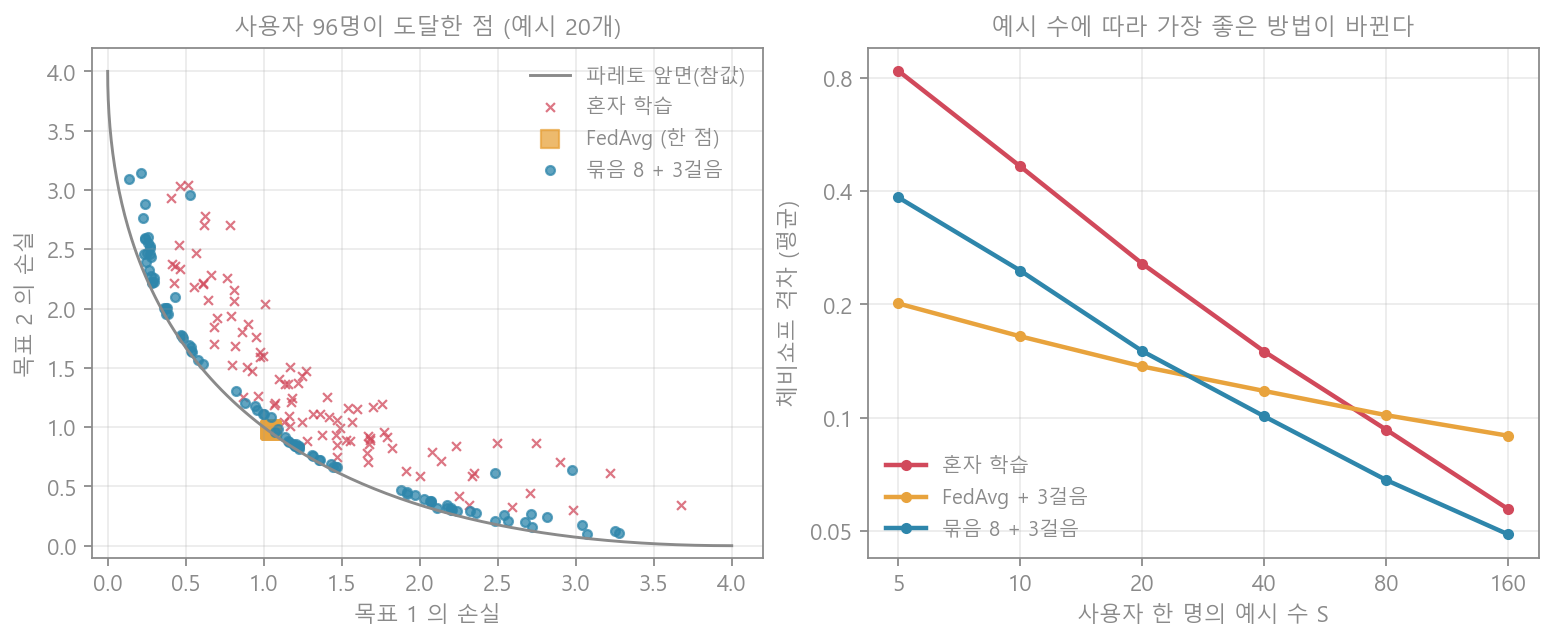
문제는 이렇게 만들었다.
- 10차원에서 목표 둘: , . 두 중심 사이의 거리는 2 다. 파레토 집합은 과 를 잇는 선분이고, 앞면은 2절 예제의 이다.
- 사용자 96명. 선호 은 0.1 과 0.9 사이에서 고르게 뽑았다.
- 데이터 부족: 사용자는 중심 를 모르고 예시 개의 평균으로 추정한다. 추정한 중심에는 좌표마다 표준편차 의 오차가 있다.
- 평가는 참값으로 한다. 사용자 가 얻은 의 체비쇼프 값에서 그 사용자의 최적값을 뺀 것을 “격차”라 부르고, 96명의 평균을 20번의 반복에 걸쳐 평균했다.
비교한 방법은 셋이다. 혼자 학습(자기 추정값으로만), 전원 평균(FedAvg, 모든 사용자의 방향을 평균해 한 점을 만든다), 묶기(논문의 2단계 묶기를 줄인 것. 묶음 안에서만 평균한다). 뒤의 둘은 그 뒤에 자기 추정값으로 걸음 더 간다. 논문의 갱신 규칙(제약이 있는 방향 찾기)과 메타 학습 단계는 구현하지 않았다. 병목 목표의 기울기를 따라가는 단순한 방법을 썼다.
[A] 예시 20개에서
| 적응 없음 | 3걸음 적응 | 30걸음 적응 | |
|---|---|---|---|
| 혼자 학습 | 0.259 | ||
| 묶음 1 (FedAvg) | 0.292 | 0.139 | 0.203 |
| 묶음 2 | 0.188 | 0.133 | 0.192 |
| 묶음 4 | 0.183 | 0.152 | 0.193 |
| 묶음 8 | 0.176 | 0.156 | 0.193 |
| 묶음 16 | 0.174 | 0.161 | 0.196 |
| 묶음 32 | 0.183 | 0.174 | 0.205 |
20번 반복의 표준오차는 0.003 안팎이다.
- 적응 없이 보면 묶기가 이긴다. FedAvg 는 0.292 로 혼자 학습(0.259)보다 나쁘다. 모두의 선호를 평균한 한 점은 누구의 것도 아니다. 묶음 8 은 0.176 으로 혼자 학습보다 32% 작다. 묶음 16 까지 줄다가 32 에서 다시 는다. 묶음이 잘게 쪼개지면 한 묶음에 3명뿐이라 잡음이 덜 지워진다.
- 3걸음 적응을 넣으면 순서가 바뀐다. FedAvg + 3걸음이 0.139 로 묶음 8 + 3걸음(0.156)보다 좋다. 가장 좋은 것은 묶음 2(0.133)이고 FedAvg 와의 차이는 표준오차의 두 배쯤이다. 나는 묶음이 많을수록 좋을 것이라 예상했는데 틀렸다. 이 문제에서는 선호의 차이가 선분 하나 위의 위치 차이뿐이라, 96명이 잡음을 지운 출발점에서 세 걸음이면 자기 자리로 꽤 간다. 잡음을 많이 지우는 쪽이 유리했다.
- 적응을 오래 하면 나빠진다. 30걸음을 가면 어느 방법이든 0.19~0.21 로 모인다. 자기 예시 20개로 만든 잘못된 목표점으로 끌려가기 때문이다. 함께 배운 출발점의 가치는 몇 걸음 안에서만 남는다. 논문이 적응을 3걸음으로 둔 것과 맞는 결과다.
[B] 예시 수를 바꾸면
| 예시 수 | 혼자 학습 | FedAvg + 3걸음 | 묶음 8 + 3걸음 |
|---|---|---|---|
| 5 | 0.834 | 0.201 | 0.385 |
| 10 | 0.465 | 0.165 | 0.246 |
| 20 | 0.257 | 0.137 | 0.150 |
| 40 | 0.150 | 0.118 | 0.101 |
| 80 | 0.093 | 0.102 | 0.068 |
| 160 | 0.057 | 0.090 | 0.049 |
- 혼자 학습의 격차는 예시가 두 배가 될 때마다 0.55~0.62 배가 됐다. 라면 0.5 배, 라면 0.71 배다. 그 사이다.
- FedAvg + 3걸음은 예시가 늘어도 0.201 에서 0.090 으로 천천히 준다. 잡음이 아니라 “세 걸음으로는 내 선호까지 다 못 간다”는 한계가 남는다. 예시 80개부터는 혼자 학습보다 나쁘다.
- 묶음 8 + 3걸음은 예시 40개부터 셋 중 가장 좋다. 예시가 아주 적을 때는 전원 평균이, 어느 정도 있을 때는 묶기가 낫다. 오른쪽 그림에서 선들이 엇갈리는 자리다.
이것은 “예시가 적을수록 묶기가 유리하다”는 내 처음 짐작과 반대다. 묶음을 나누면 한 묶음의 사람 수가 줄어 잡음이 덜 지워지는데, 예시가 아주 적으면 그 손해가 선호를 맞추는 이득보다 크다. 논문의 결과와 어긋난다는 뜻은 아니다. 논문의 문제는 목표가 셋이고 사용자의 데이터 자체가 서로 다르며, 내가 구현하지 않은 메타 학습 단계가 있다.
[C] 하이퍼볼륨은 무엇을 재는가
96명이 도달한 점들의 하이퍼볼륨을 쟀다. 기준점은 (5, 5) 다.
| 방법 | 하이퍼볼륨 | 체비쇼프 격차 ([A]) |
|---|---|---|
| 오차 없는 정답 96개 | 21.10 | 0 |
| 혼자 학습 | 20.30 | 0.259 |
| FedAvg (한 점) | 15.91 | 0.292 |
| FedAvg + 3걸음 | 19.70 | 0.139 |
| 묶음 8 | 20.70 | 0.176 |
| 묶음 8 + 3걸음 | 21.59 | 0.156 |
- FedAvg 는 모든 사용자가 한 점에 있어서 넓이가 가장 작다. 왼쪽 그림의 노란 네모다.
- 묶음 8 + 3걸음의 하이퍼볼륨(21.59)이 정답보다 크다. 정답보다 좋은 해가 나온 것이 아니다. 점들이 앞면의 양 끝 쪽으로 정답보다 더 넓게 퍼져서 넓이가 는 것이다. 각자의 격차는 0 이 아니라 0.156 이다.
- FedAvg + 3걸음은 격차가 가장 작은데(0.139) 하이퍼볼륨은 혼자 학습보다 작다(19.70 대 20.30). 두 지표의 순위가 다르다.
하이퍼볼륨은 “집단이 앞면을 얼마나 넓고 가깝게 덮는가”를 잰다. “각 사용자가 자기가 원한 점에 갔는가”는 재지 않는다. 논문이 하이퍼볼륨과 함께 점수와 IGD(정답 점들까지의 거리)를 같이 보고하는 이유가 여기에 있을 것이다. 이 문장은 내 추측이다.
4. 흔한 오해와 한계
“파레토 최적이면 좋은 해다.” 파레토 최적은 “더 나은 것이 없다”는 뜻일 뿐이다. 앞면의 한쪽 끝은 목표 하나를 완전히 버린 점인데도 파레토 최적이다. 어느 점이 좋은지는 선호가 정한다.
“가중치를 주고 더하면 선호가 반영된다.” 2절의 예제에서 가중합은 4 : 1 로 중요하다고 했더니 손실을 1 : 16 으로 만들었다. 체비쇼프는 1 : 4 로 만든다. 가중합은 앞면이 안으로 굽은 곳의 점을 아예 찾지 못한다는 것도 알려진 한계다.
“많이 묶을수록, 또는 잘게 나눌수록 좋다.” [A] 에서 묶음 수에는 가운데 어딘가에 최적이 있었고, [B] 에서 그 최적은 예시 수에 따라 움직였다. 논문도 묶음 수를 손으로 정하고, 고르는 원칙은 주지 않는다.
“하이퍼볼륨이 +17.1% 면 개인화가 17.1% 나아졌다.” [C] 에서 본 대로 하이퍼볼륨은 개인별 정확도가 아니다. 또 +17.1% 는 한 조합(UltraFeedback, Llama, FedAvg 대비)의 값이다. 같은 표에서 Fed-ChatbotPA 는 FSPO·DITTO 대비 0.61 → 0.63 으로 폭이 작다.
논문의 한계. 모델이 30억 파라미터급 둘뿐이다. 사용자가 자기 선호를 가중치 벡터로 정확히 말할 수 있다고 가정한다. 수렴 정리는 추가 가정(하강 여유 조건)에 기대고, 적응 분석은 걸음마다 새 예시를 쓴다고 가정한다. 동료 평가 전이다.
이 글 실험의 한계. 언어모델이 아니라 2차식 손실의 장난감 문제다. 목표는 둘뿐이고, 사용자 사이의 차이는 선호와 추정 오차뿐이다. 논문의 갱신 규칙과 메타 학습은 구현하지 않았다. 여기서 나온 순위를 논문의 방법에 대한 평가로 읽으면 안 된다.
5. 한 문단 요약
10월 5일 arXiv 에 올라온 APO 논문은, 목표가 여럿이고 사용자마다 원하는 균형이 다르며 예시가 20개뿐인 상황에서 언어모델을 개인화하는 방법을 제안한다. 사용자의 선호는 가중치 로 쓰고, 가중 손실의 최댓값(가중 체비쇼프)을 줄여 모든 가중 손실이 같아지는 파레토 점을 찾는다. 가중합과 달리 선호가 손실의 비율을 직접 정한다. 같은 목표가 병목인 사용자끼리 묶어 함께 학습하고, 각자 몇 걸음만 고친다. 논문은 3B 급 모델에서 FedAvg 대비 하이퍼볼륨 0.41 → 0.48 을 보고했다. 장난감 문제에서 재 보니 묶기만으로 혼자 학습보다 격차가 32% 줄었고(0.259 → 0.176), 적응을 30걸음 하면 그 이득이 사라졌다. 예시가 20개 이하일 때는 전원 평균 뒤 3걸음이 묶음 8개보다 나았고, 40개부터는 묶기가 가장 좋았다. 하이퍼볼륨은 점들의 퍼짐도 재기 때문에 정답보다 큰 값이 나올 수 있었고, 개인별 격차와 순위가 달랐다.
참고
- Yang, Yuan, Yang — Collaborative Personalized Preference Alignment for LLMs under Data Deficiency (arXiv 2610.05898, 2026-10-05) · HTML · Hugging Face 논문 페이지
- AI Weekly — AI News Today, October 7 (이 논문을 소개한 요약)
- McMahan 외 — Communication-Efficient Learning of Deep Networks from Decentralized Data (FedAvg, 2017)