인지야공/딥러닝 기초 정리/7번째 글
word2vec — 이웃을 맞히다 보면 뜻이 좌표가 된다
실행:
python NN_60_word2vec.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 1분 남짓) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 말뭉치는 구조를 알고 만든 합성 말뭉치다.
토크나이저와 임베딩 편에서 토큰은 번호가 되고, 번호는 임베딩 표에서 벡터 하나를 꺼내는 데 쓰인다고 했다. 그 벡터들은 처음에 무작위다. 그런데 학습이 끝나면 뜻이 비슷한 단어끼리 가까이 모여 있다. 누가 뜻을 알려 준 적이 없는데도 그렇다.
이 편은 그 일이 일어나는 가장 단순한 장치인 word2vec(2013)을 직접 만들어 세 가지를 잰다.
- 이웃 단어를 맞히는 것만으로 “왕 − 남자 + 여자 = 여왕” 같은 유추가 정말 되는가
- 학습된 벡터의 내적은 정확히 무엇을 담고 있는가
- 네거티브 샘플링이라는 꼼수는 왜 필요했나
1. 단어는 함께 다니는 무리로 안다
분포 가설
“단어의 뜻은 그 단어가 어울려 다니는 단어들로 알 수 있다.” 언어학에서 분포 가설이라 부르는 생각이다. ‘의사’와 ‘간호사’는 둘 다 ‘병원’, ‘환자’, ‘진료’ 옆에 나온다. 옆에 오는 단어가 비슷하면 뜻도 비슷할 것이다.
word2vec 의 스킵그램은 이것을 맞히기 과제로 바꾼다. 문장에서 단어 하나(중심 단어)를 고르고, 그 주변에 실제로 나온 단어(문맥 단어)를 맞히게 한다.
벡터 두 벌과 내적
단어마다 벡터를 두 개 둔다. 중심 단어로 쓰일 때의 벡터 와 문맥 단어로 쓰일 때의 벡터 다. 둘의 내적 가 클수록 ” 옆에 가 나올 법하다”로 읽는다.
정석대로 하면 소프트맥스와 교차 엔트로피 편의 분류 문제다. 어휘 전체가 클래스다.
문제는 분모다. 단어 쌍 하나를 학습할 때마다 어휘 개 전부와 내적을 구해야 한다. 어휘가 100만 개면 100만 번이다.
네거티브 샘플링 — 진짜와 가짜를 가르기
네거티브 샘플링은 문제를 바꾼다. “어휘 중 어느 단어인가”를 묻지 않고 “이 쌍은 진짜로 함께 나온 쌍인가, 아무렇게나 짝지은 가짜인가” 를 묻는다.
| 기호 | 뜻 |
|---|---|
| , | 말뭉치에서 실제로 함께 나온 중심 단어와 문맥 단어 (진짜 쌍) |
| , | 중심 단어 벡터, 문맥 단어 벡터 |
| 시그모이드 . 내적을 0~1 사이의 “진짜일 확률”로 바꾼다 | |
| 아무렇게나 뽑은 단어 개 (가짜 문맥, 네거티브) | |
| 진짜 쌍 하나에 붙이는 가짜의 수 | |
| 어휘 크기 |
첫 항은 진짜 쌍의 내적을 키우고, 둘째 항은 가짜 쌍의 내적을 줄인다. 한 번에 계산하는 내적은 개뿐이다. 어휘 크기와 상관이 없다.
내적이 담는 것 — PMI
이 손실을 끝까지 줄이면 내적이 어떤 값이 되는지 풀 수 있다(Levy & Goldberg 2014). 네거티브를 단어 빈도 그대로 뽑을 때 최적의 내적은 다음과 같다.
| 기호 | 뜻 |
|---|---|
| 와 가 함께 나올 확률 | |
| 둘이 서로 상관없다면 함께 나올 확률 | |
| PMI | 점별 상호정보량. 우연보다 몇 배 자주 함께 나오는가의 로그. 0이면 우연 수준, 양수면 더 자주 |
| 가짜를 개 붙인 만큼 전체가 내려가는 양 |
word2vec 은 신경망처럼 보이지만, 하는 일은 “우연보다 얼마나 자주 함께 나오는가”의 표를 낮은 차원의 벡터 두 벌로 압축하는 것이다.
2. 직접 재 보기
진짜 말뭉치로는 “유추가 됐다”를 채점하기 어렵다. 그래서 구조를 알고 있는 말뭉치를 만들었다.
- 사람 단어 12개 = 역할 6종(왕·의사·농부·가수·교사·군인) × 성별 2종.
왕_남,왕_여처럼 이름을 붙였지만, 모델에게는 번호일 뿐이다. - 문장 하나 = 사람 단어 1개 + 그 역할의 문맥어 3개 + 그 성별의 문맥어 2개 + 아무 데나 나오는 잡음어 3개.
- 어휘 82개, 문장 20,000개, (중심, 문맥) 쌍 1,440,000개.
왕_남 과 왕_여 가 같은 역할이라는 사실은 어디에도 적혀 있지 않다. 같은 역할 문맥어와 함께 나온다는 것으로만 드러난다.
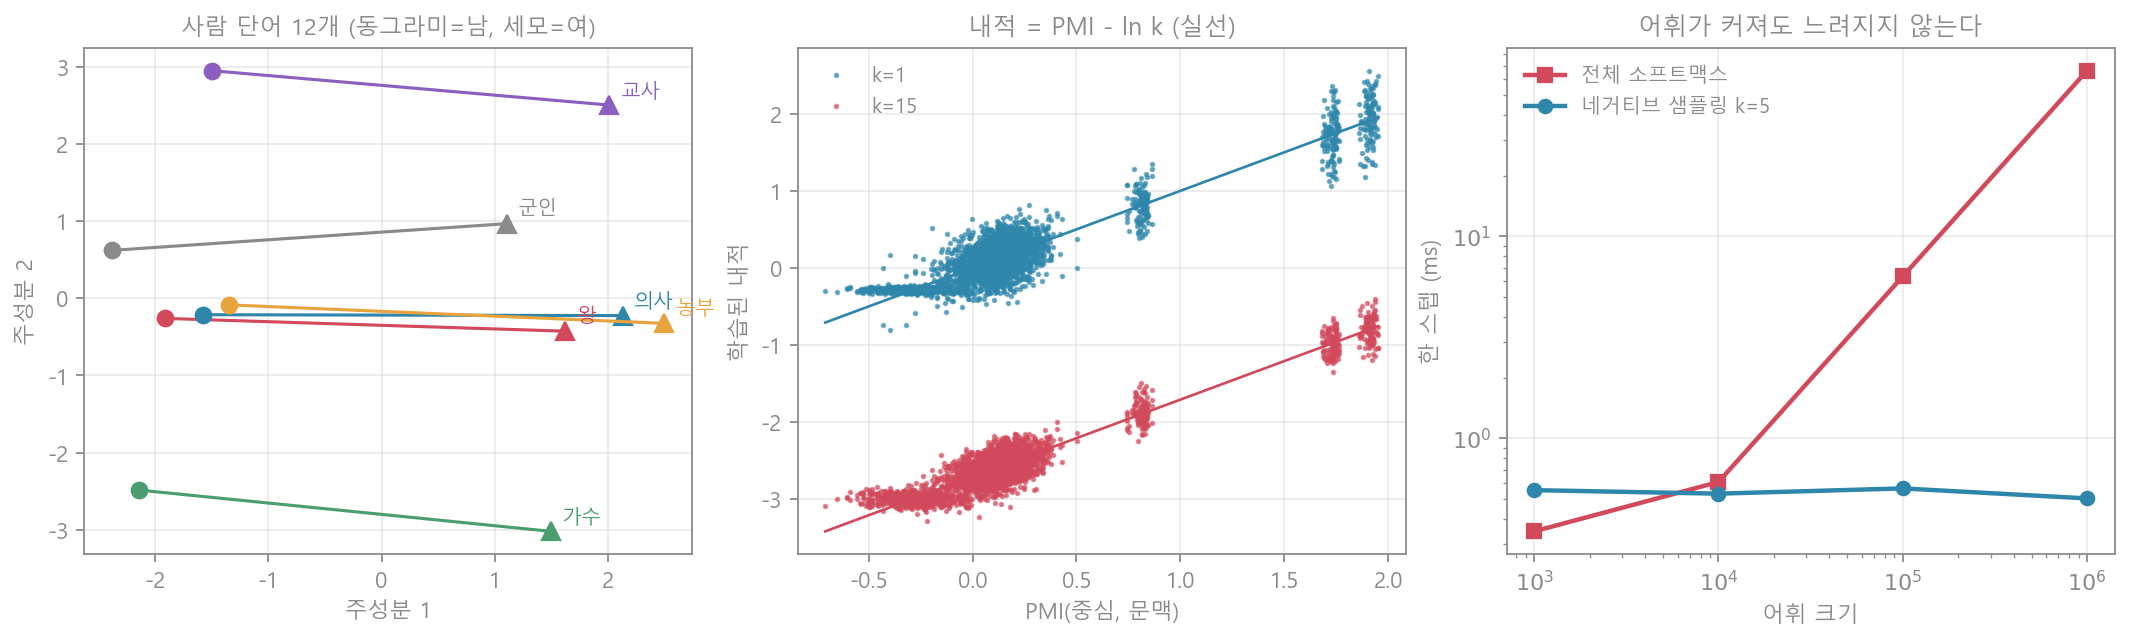
[A] 유추가 되는가
유추 문제는 “_여 − _남 + _남 에 가장 가까운 사람 단어는 _여 인가”다. 역할 쌍과 방향을 바꿔 60문제를 냈다. 질문에 쓴 세 단어를 뺀 9개 중에서 고르므로 찍으면 11.1% 다. 학습 전 무작위 벡터는 10.0% 였다.
| 임베딩 차원 | 유추 정확도 (시드 3개) | 가장 가까운 사람 단어가 같은 역할 |
|---|---|---|
| 1 | 20.0% | 16.7% |
| 2 | 58.9% (40~75) | 50.0% |
| 4 | 100.0% | 100.0% |
| 8 | 100.0% | 66.7% |
| 16 | 100.0% | 91.7% |
| 32 | 100.0% | 100.0% |
- 4차원부터 60문제를 전부 맞혔다. 예를 들어 16차원 모델에서
왕_여 − 왕_남 + 의사_남에 가까운 순서는 의사_여(0.90), 의사_남(0.65), 농부_여(0.58), 가수_여(0.54)였다. - 유추가 되는 이유는 벡터가 덧셈 구조를 갖기 때문이다. 16차원에서 역할 6개의 “여 − 남” 벡터끼리의 코사인은 평균 0.923(최소 0.860)이었다. 성별이라는 속성이 역할과 상관없이 거의 같은 방향 하나로 담겼다. 왼쪽 그림에서 여섯 선분이 나란한 것이 그것이다.
- 2차원으로는 부족했다. 역할 6종과 성별을 2차원에 덧셈 구조로 담을 자리가 없다.
- 오른쪽 열은 예상과 달랐다. 차원을 키워도 “가장 가까운 사람 단어가 같은 역할”이 늘 100% 는 아니었다(8차원 66.7%).
왕_남에게왕_여보다의사_남이 더 가까운 경우가 있다는 뜻이다. 성별도 역할만큼 강한 공통점이라서 그렇다. “비슷하다”가 어떤 속성 기준인지는 벡터가 정해 주지 않는다.
[B] 내적은 PMI − ln k 인가
말뭉치에서 PMI 를 직접 세고, 32차원 모델의 내적과 비교했다. 20번 이상 함께 나온 쌍 4,811개가 대상이다. 이론이 네거티브를 빈도 그대로 뽑는 경우의 것이라, 이 실험만 그렇게 뽑았다.
| 내적과 PMI 의 상관 | 내적 − PMI 의 평균 | 이론 | |
|---|---|---|---|
| 1 | 0.931 | +0.005 | 0.000 |
| 5 | 0.952 | −1.607 | −1.609 |
| 15 | 0.957 | −2.714 | −2.708 |
- 내적은 PMI 를 따라가고(상관 0.93~0.96), 평균적으로 정확히 만큼 아래에 있다. 가운데 그림에서 점들이 기울기 1인 실선 위에 놓인다.
- 한 번도 함께 나오지 않은 쌍 1,704개는 PMI 가 다. 모델은 이 쌍들의 내적을 평균 −9.14 로 두었다. 무한대까지 밀지는 않지만 충분히 멀리 민 것이다.
- 이론은 “차원이 충분하면”이라는 조건이 붙는다. 82×82 표를 32차원으로 담았기 때문에 완전히 같지는 않다(RMSE 0.13~0.17).
[C] 왜 네거티브 샘플링인가
배치 1,024, 100차원에서 한 스텝(순전파 + 기울기)의 시간을 어휘 크기를 바꿔 가며 쟀다.
| 어휘 크기 | 전체 소프트맥스 | 네거티브 샘플링 () | 배율 |
|---|---|---|---|
| 1,000 | 0.35 ms | 0.55 ms | 0.6배 |
| 10,000 | 0.61 ms | 0.53 ms | 1.1배 |
| 100,000 | 6.34 ms | 0.57 ms | 11.2배 |
| 1,000,000 | 66.19 ms | 0.50 ms | 131.1배 |
- 전체 소프트맥스는 어휘에 비례해 느려진다. 10만에서 100만으로 10배 늘자 시간도 10.4배가 됐다.
- 네거티브 샘플링은 어휘가 1,000배 커져도 0.5 ms 그대로다. 건드리는 벡터가 배치당 개뿐이기 때문이다.
- 어휘가 작으면 이득이 없다. 1,000개에서는 전체 소프트맥스가 오히려 빨랐다(0.35 ms 대 0.55 ms). GPU 에서 작은 행렬곱 한 번이 여러 번의 꺼내기보다 싸다.
3. 흔한 오해와 한계
“word2vec 은 단어의 뜻을 이해한다.” 함께 나오는 통계를 압축한 것이다. [B]에서 내적은 PMI 였다. 말뭉치에 함께 나오지 않는 관계는 담기지 않고, 말뭉치의 편향은 그대로 담긴다.
“유추가 되는 것은 신기한 창발이다.” 이 말뭉치에서는 사람 단어의 문맥이 “역할 문맥어 + 성별 문맥어”의 합으로 만들어졌다. PMI 가 로그라서 독립인 요인이 덧셈으로 나타나고, 벡터도 덧셈 구조를 갖는다. 진짜 언어에서는 이 독립성이 깨지는 만큼 유추도 깨진다. 실제 word2vec 의 유추 정확도가 100% 가 아닌 이유다.
“가까운 벡터는 비슷한 뜻이다.”
[A]에서 왕_남 의 가장 가까운 이웃이 왕_여 가 아닐 때가 있었다. 가깝다는 것은 “문맥을 많이 공유한다”이지, 사람이 생각하는 특정 기준의 유사성이 아니다.
“단어 하나에 벡터 하나면 충분하다.” ‘배’(과일, 탈것, 신체)는 벡터 하나에 세 뜻이 섞인다. 문맥에 따라 벡터가 달라지게 만든 것이 어텐션 이후의 모델이고, 뒤의 편들이 다룬다.
실험의 한계. 어휘 82개의 합성 말뭉치다. 실제 word2vec 이 쓰는 창 크기, 잦은 단어 솎아내기, 빈도의 0.75 제곱 같은 요령의 효과는 재지 않았다([A]에서는 0.75 제곱을 쓰고 [B]에서는 이론에 맞춰 뺐다). [C]는 GPU 한 대에서 잰 시간이고, word2vec 이 처음 돌던 CPU 환경에서는 배율이 다르다.
4. 한 문단 요약
word2vec 의 스킵그램은 중심 단어로 주변 단어를 맞히게 해서, 함께 다니는 단어가 비슷한 단어들을 가까운 벡터로 만든다. 구조를 알고 만든 말뭉치에서, 뜻을 한 번도 알려 주지 않았는데 유추 60문제를 4차원부터 전부 맞혔다(2차원은 58.9%, 찍기는 11.1%). 역할 6개의 “여 − 남” 벡터는 코사인 0.923 으로 거의 같은 방향이었다. 학습된 내적은 PMI − ln k 였다. 에서 내적과 PMI 의 차이는 평균 −1.607(이론 −1.609), 에서 −2.714(이론 −2.708)였다. 네거티브 샘플링은 “어휘 중 무엇인가”를 “진짜 쌍인가 가짜 쌍인가”로 바꿔 어휘 크기와 무관한 비용을 만든다. 어휘 100만 개에서 전체 소프트맥스보다 131배 빨랐고, 1,000개에서는 오히려 느렸다.
참고
- Mikolov 외 — Efficient Estimation of Word Representations in Vector Space (2013)
- Mikolov 외 — Distributed Representations of Words and Phrases and their Compositionality (2013) (네거티브 샘플링)
- Levy, Goldberg — Neural Word Embedding as Implicit Matrix Factorization (2014)
- Arora 외 — A Latent Variable Model Approach to PMI-based Word Embeddings (2016)
- 연재: 토크나이저와 임베딩 편 · 소프트맥스와 교차 엔트로피 편 · 엔트로피와 KL 발산 노트