인지야공/딥러닝 기초 정리/28번째 글
전이 학습과 파국적 망각 — 배운 것을 가져가는 값, 그리고 잃는 것
실행:
python NN_59_transfer.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 1분) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
지금 쓰이는 모델은 거의 전부 남이 미리 학습해 둔 것을 가져와 내 과제에 맞춘 것이다. 이것이 전이 학습이다. 이 묶음(적응과 압축)의 뒤 편들은 그 맞추는 방법을 싸게 만드는 기법을 다룬다. 그 전에 이 편은 기본 질문 셋을 잰다.
- 가져오면 얼마나 이득인가. 그 이득은 내 데이터 양에 따라 어떻게 바뀌나
- 가져온 것을 얼릴까, 고칠까
- 고치면 원래 알던 것은 어떻게 되나
1. 몸통과 머리
분류 모델을 둘로 나눠 본다.
- 몸통(body): 입력에서 특징을 뽑는 층들. 이 편의 모델에서는 합성곱 2층과 완전연결 1층이다.
- 머리(head): 특징을 받아 클래스 점수를 내는 마지막 층 하나.
과제가 달라도 몸통이 뽑는 특징의 상당 부분은 다시 쓸 수 있다. 모서리, 밝기의 기울기 같은 것은 어느 그림에나 있다. 머리는 과제마다 새로 달아야 한다. 클래스가 다르기 때문이다.
| 방법 | 몸통 | 머리 | 새 데이터로 배우는 파라미터 |
|---|---|---|---|
| 처음부터 | 무작위에서 학습 | 무작위에서 학습 | 전부 |
| 몸통 얼림 (선형 프로브) | 가져와서 고정 | 무작위에서 학습 | 머리만 |
| 미세조정 (fine-tuning) | 가져와서 계속 학습 | 무작위에서 학습 | 전부 |
어느 쪽이 좋은지는 배울 파라미터 수와 내 데이터 양의 균형으로 정해진다. 데이터가 적은데 전부 고치면 몇 장 안 되는 데이터에 몸통이 끌려가고, 데이터가 많은데 몸통을 얼리면 새 과제에 필요한 특징을 만들 수 없다.
파국적 망각
미세조정에는 대가가 있다. 신경망은 지식을 가중치에 겹쳐서 담는다. 새 과제의 기울기는 옛 과제를 모른다. 옛 과제에 중요하던 가중치도 새 손실을 줄이는 방향이면 거리낌 없이 옮긴다. 그 결과 옛 과제의 성능이 조금씩이 아니라 급격히 무너진다. 이것을 파국적 망각(catastrophic forgetting) 이라 부른다.
막는 방법 중 가장 단순한 것이 리플레이다. 옛 과제의 데이터를 조금 남겨 두었다가 새 과제 학습에 섞는다.
| 기호 | 뜻 |
|---|---|
| 몸통의 가중치 | |
| 새 과제 B 의 손실 | |
| 남겨 둔 A 샘플 몇 장으로 잰 옛 과제의 손실 |
기울기에 “옛 과제를 망치지 않는 방향”이 섞여 들어간다.
2. 직접 재 보기
데이터는 16×16 도형 12종이다. 도형은 네 계열(원, 사각형, 마름모, 십자)이고, 계열마다 세 변형(전체 밝음, 오른쪽이 어두움, 아래가 어두움)이 있다.
- 과제 A: 원·사각형 계열 6종. 클래스당 500장으로 사전학습했다(시험 정확도 97.4~98.5%, 시드 3개).
- 과제 B: 마름모·십자 계열 6종. 클래스당 5~500장.
두 과제는 도형이 다르지만 “어느 쪽이 어두운가”라는 속성을 공유한다. 전이될 것이 있지만 전부는 아닌 상황이다.
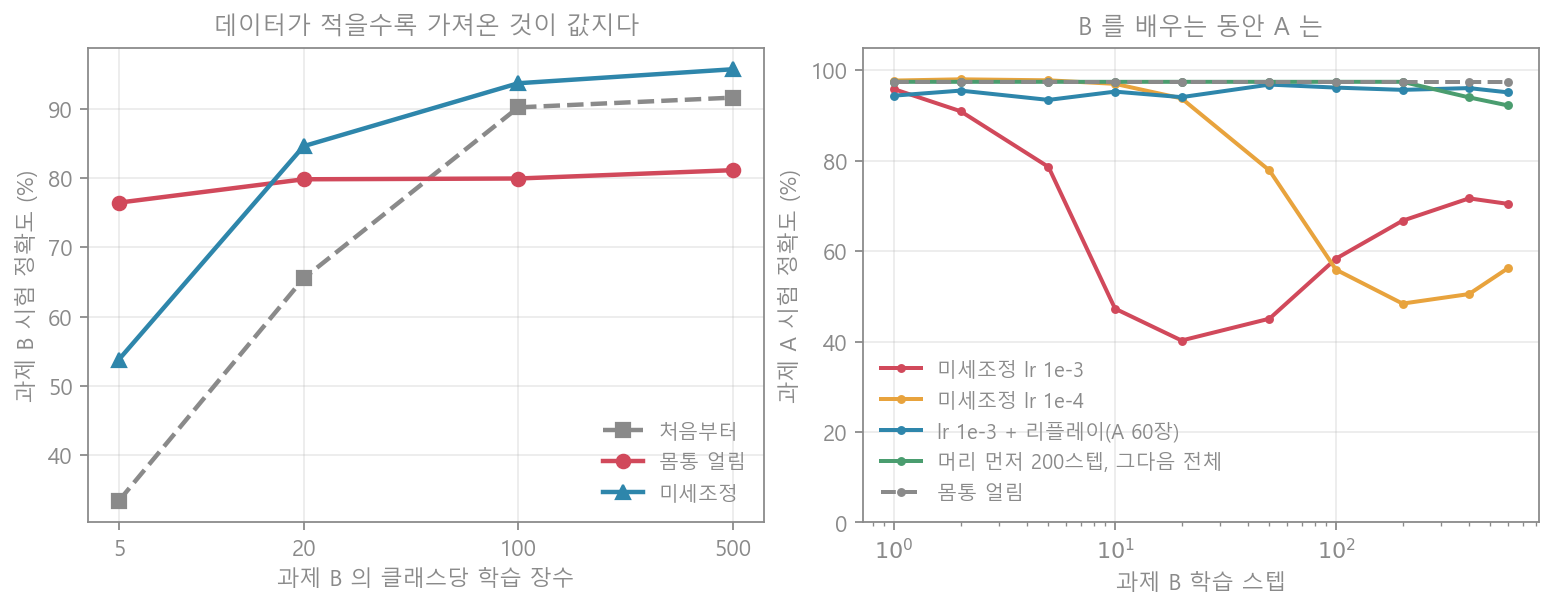
[A] 데이터 양에 따라 순위가 바뀐다
과제 B 의 시험 정확도(600스텝, 시드 3개 평균)다.
| B 의 클래스당 장수 | 처음부터 | 몸통 얼림 | 미세조정 |
|---|---|---|---|
| 5 | 33.4% | 76.4% | 53.8% |
| 20 | 65.5% | 79.8% | 84.6% |
| 100 | 90.2% | 79.9% | 93.6% |
| 500 | 91.6% | 81.1% | 95.7% |
- 5장: 몸통을 얼린 쪽이 처음부터 배운 쪽의 두 배가 넘는다(76.4% 대 33.4%). 미세조정(53.8%)은 얼린 것보다 못하다. 30장으로 몸통 전체를 고치다 좋은 특징을 망가뜨린 것이다.
- 20장: 순위가 바뀌어 미세조정이 앞선다.
- 100장 이상: 몸통 얼림은 80% 근처에서 멈춘다. 데이터를 5장에서 500장으로 100배 늘려도 4.7%p 만 올랐다. A 에서 만든 특징만으로는 B 를 그 이상 가를 수 없다. 처음부터 배운 쪽이 얼린 쪽을 넘어선다. 그래도 미세조정이 끝까지 가장 높다(500장에서 95.7% 대 91.6%).
- 몸통 얼림은 시드 사이의 차이가 13
16%p 로 컸다. 어떤 사전학습 몸통을 받았느냐에 결과가 통째로 달려 있다는 뜻이다. 미세조정은 20장 이상에서 23%p 안이었다.
[B] 어디까지 얼릴까
B 가 클래스당 20장일 때, 앞에서부터 몇 층을 얼리느냐를 바꿨다.
| 얼린 범위 | B 시험 정확도 | 시드 3개 범위 |
|---|---|---|
| 아무것도 안 얼림 (미세조정) | 84.6% | 84.0~85.5 |
| conv1 | 85.9% | 85.2~87.1 |
| conv1·conv2 | 83.9% | 81.8~86.2 |
| 몸통 전부 | 79.8% | 72.6~86.2 |
| (대조) 무작위 몸통을 전부 얼림 | 25.1% |
- 첫 합성곱층은 얼리는 편이 조금 나았다(85.9%). 다만 미세조정(84.6%)과의 차이 1.3%p 는 시드 범위와 겹쳐서, “앞층은 얼려도 손해가 없다”까지만 말할 수 있다.
- 뒤로 갈수록 얼리는 손해가 커진다. 앞층은 과제와 무관한 일반 특징을, 뒤층은 과제에 맞춘 특징을 담는다는 통설과 같은 방향이다.
- 학습하지 않은 무작위 몸통을 얼리면 25.1% 다. 얼린 몸통의 79.8% 는 구조가 아니라 A 에서 배운 것 덕이다.
[C] B 를 배우고 나면 A 는
B 를 클래스당 500장으로 600스텝 학습한 뒤, A 를 옛 머리로 다시 시험했다. 학습 전 A 정확도는 97.9% 다(시드 3개 평균).
| B 를 배운 방법 | A 정확도 (학습 뒤) | B 정확도 |
|---|---|---|
| 미세조정, 학습률 | 75.3% (68.6~86.8) | 95.5% |
| 미세조정, 학습률 | 64.9% (48.4~89.9) | 82.8% |
| 학습률 + 리플레이 (A 60장) | 95.4% (94.8~96.2) | 96.1% |
| 머리 먼저 200스텝, 그다음 전체 | 89.7% (87.8~92.2) | 94.5% |
| 몸통 얼림 | 97.9% | 81.3% |
미세조정은 A 를 22.6%p 잃었다. 경과(오른쪽 그림, 시드 0)를 보면 더 극적이다.
| 스텝 | 1 | 5 | 10 | 20 | 100 | 600 |
|---|---|---|---|---|---|---|
| A 정확도 (학습률 ) | 96% | 79% | 47% | 40% | 58% | 70% |
- 망각은 처음 20스텝에 일어난다. B 의 미니배치를 20번 본 것만으로 97% 가 40% 가 됐다. 그 뒤에는 오히려 조금 회복했다.
- 학습률을 낮추는 것은 처방이 아니었다. 에서는 같은 곡선이 느리게 그려졌을 뿐이다. 20스텝이 아니라 200스텝에 바닥(48%)을 찍었고, 600스텝에서 A 는 더 낮고(64.9%) B 도 덜 배웠다(82.8%). “살살 고치면 덜 잊는다”는 내 예상은 이 설정에서 틀렸다.
- 리플레이는 A 60장(클래스당 10장)으로 95.4% 를 지켰다. 사전학습에 쓴 3,000장의 2% 다. B 정확도도 깎이지 않았다(96.1%).
- 머리를 먼저 맞추면 덜 잊는다. 처음 20스텝의 급락이 왜 생기는지 확인하려고, 새 머리만 200스텝 먼저 학습한 뒤 전체를 풀었다. A 는 89.7% 가 남았다. 새 머리가 무작위일 때는 손실이 크고, 그 큰 기울기가 몸통으로 그대로 흘러 들어가 특징을 흔든다. 머리가 먼저 자리를 잡으면 몸통에 닿는 기울기가 작아진다.
- 몸통을 얼리면 하나도 잊지 않는다. 대신 B 는 81.3% 에서 멈춘다. 망각과 적응은 같은 가중치를 두고 다투는 거래다.
3. 흔한 오해와 한계
“사전학습 모델은 항상 미세조정하는 것이 낫다.” 클래스당 5장에서는 얼린 쪽이 22.6%p 높았다. 내 데이터가 아주 적으면 몸통을 건드리지 않는 편이 낫다.
“학습률을 낮추면 망각이 줄어든다.” 이 실험에서는 같은 망각이 늦게 왔을 뿐이다. 다만 학습 스텝 수를 600으로 고정한 결과다. 학습률을 낮추고 일찍 멈추면 다를 수 있고, 그 조합은 재지 않았다.
“망각은 오래 학습해야 생긴다.” 20스텝이면 충분했다. 미세조정을 시작하자마자 옛 성능을 확인해야 하는 이유다.
“얼린 몸통은 안전한 선택이다.” 잊지는 않지만 시드에 따라 72.6%~86.2% 로 흔들렸다. 받은 몸통이 새 과제에 맞는 특징을 우연히 갖고 있느냐에 달려 있다.
실험의 한계. 작은 합성곱망 하나와 도형 데이터다. 두 과제가 머리를 따로 쓰는 설정(과제를 알려 주는 설정)이라, 머리 하나로 12종을 모두 가르는 더 어려운 설정보다 망각이 순하게 나온다. 큰 사전학습 모델은 특징이 훨씬 일반적이라 얼린 몸통의 천장이 여기보다 높다. EWC 처럼 중요한 가중치를 묶어 두는 방법은 재지 않았다. 몸통을 얼리고 작은 덧붙임만 학습하는 중간 길은 뒤의 LoRA 편에서 다룬다.
4. 한 문단 요약
전이 학습은 다른 과제에서 배운 몸통을 가져와 새 머리를 다는 일이다. 새 과제의 데이터가 클래스당 5장일 때 처음부터 배우면 33.4%, 몸통을 얼리고 머리만 배우면 76.4% 였다. 데이터가 20장을 넘으면 몸통까지 고치는 미세조정이 앞섰고(500장에서 95.7%), 얼린 몸통은 80% 근처에서 멈췄다. 미세조정의 대가는 망각이다. 옛 과제 정확도는 97.9% 에서 75.3% 로 떨어졌고, 그 하락은 처음 20스텝에 일어났다(40% 까지). 학습률을 10분의 1로 낮춰도 같은 곡선이 늦게 왔을 뿐이다. 옛 데이터 60장을 섞는 리플레이는 95.4% 를 지켰고, 새 머리를 먼저 맞춘 뒤 전체를 푸는 것도 89.7% 를 남겼다. 몸통을 얼리면 아무것도 잊지 않지만 새 과제는 81.3% 에 머문다. 얼마나 고칠지는 얼마나 잊어도 되는지와 같은 질문이다.
참고
- Yosinski 외 — How transferable are features in deep neural networks? (2014)
- McCloskey, Cohen — Catastrophic Interference in Connectionist Networks (1989)
- Kirkpatrick 외 — Overcoming catastrophic forgetting in neural networks (2017) (EWC)
- Kumar 외 — Fine-Tuning can Distort Pretrained Features and Underperform Out-of-Distribution (2022) (머리 먼저, 그다음 전체)
- 연재: 합성곱 신경망 편 · 과적합과 규제 편