인지야공/오늘의 AI 이슈/15번째 글
출력 100만 토큰 — 길게 쓸수록 쌓이는 것
실행:
python 딥러닝/daily/DAILY_2026_10_04_long_output.py(RTX 5080, 1분 안) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 장난감 과제와 작은 신경망으로 잰 것이고, Gemini 4 Argon 의 오류율이 아니다. Argon 의 토큰당 오류율은 공개된 적이 없다.
1. 무슨 일이 있었나
9월 30일, Google DeepMind 가 Gemini 4 Argon 을 발표했다 (MarkTechPost, DataCamp, mixed-news). 이 글을 쓰는 날보다 나흘 앞선 소식이고, 이번 주 내내 보도가 이어졌다.
| 항목 | 내용 |
|---|---|
| 한 번의 출력 한도 | 64K → 1M 토큰 (문맥 창과는 별개의 수치. 문맥 창도 1M) |
| 공개 범위 | 우선 Fairwind Program 의 사이버 방어 기관에만. 유료 API 고객은 “곧”이라고만 했다 |
| 벤치마크 | DeepSWE v1.1 에서 77.9% (보도 기준) |
| 가격 | 입력 100만 토큰당 2달러, 출력 10달러 (초기 요금) |
Google 의 설명은 이렇다. 긴 작업을 여러 번의 호출로 쪼개 이어 붙이면 그 사이에 상태를 잃는다. 한 번의 흐름 안에서 생각하고, 도구를 부르고, 고치고, 큰 결과물(여러 파일에 걸친 수정, 이전 계획서)을 끝까지 낼 수 있으면 더 어려운 문제를 푼다는 것이다.
한도가 16배 늘었다. 이 글은 길이가 16배가 되면 “틀리지 않고 끝까지 가기”가 얼마나 어려워지는지를 셈한다.
2. 핵심 개념 — 곱해지는 확률
한 걸음의 실수율, 백만 걸음의 완주율
외줄을 건넌다고 하자. 한 걸음에 떨어질 확률이 이고 걸음마다 독립이라면, 걸음을 무사히 갈 확률은 한 걸음의 성공 확률을 번 곱한 것이다.
| 기호 | 뜻 |
|---|---|
| 토큰 하나가 틀릴 확률 | |
| 출력 길이 (토큰 수) | |
| 이 작을 때의 근사. 지수에 , 곧 기대 오류 수가 들어간다 |
숫자로 따라가 보자. (10만 토큰에 한 번 틀림)이라고 하자.
- : 기대 오류 수 0.64개, 전부 맞을 확률
- : 기대 오류 수 10개, 전부 맞을 확률
길이가 16배가 되면 확률이 16분의 1이 되는 것이 아니라 지수가 16배가 된다. 53% 가 0.005% 가 된다.
한 번 틀린 뒤 — 노출 편향
위 식은 “틀리면 끝”이라고 본 것이다. 실제로는 틀린 뒤에도 계속 쓴다. 그때 문제가 하나 더 생긴다. 모델은 학습할 때 올바른 글의 다음 토큰만 맞혀 봤다. 자기가 틀리게 쓴 글을 이어 쓰는 연습은 한 적이 없다. 한 번 틀리면 모델은 학습에서 본 적 없는 문맥에 놓이고, 거기서는 오류율이 훨씬 높다. 이것을 노출 편향(exposure bias) 이라 부른다.
처방 — 구간마다 검증하고 되돌리기
토큰을 한 번에 쓰지 않고 토큰씩 끊어, 구간마다 검사한다(테스트 실행, 컴파일, 규칙 대조). 틀렸으면 그 구간만 버리고 다시 쓴다.
| 기호 | 뜻 |
|---|---|
| 검증 구간의 길이 (토큰) | |
| 검증 한 번의 비용 (토큰으로 환산) | |
| 구간 하나가 한 번에 통과할 확률. 그 역수가 구간당 평균 시도 횟수다 | |
| 총비용이 가장 작은 구간 길이 |
구간이 짧으면 검사비 를 자주 내고, 길면 다시 쓰는 양이 늘어난다. 둘이 만나는 곳이 다. GPU 120만 개 글의 체크포인트 주기 과 같은 모양이다. 고장 사이의 평균 간격 자리에 오류 사이의 평균 간격 이 들어갔을 뿐이다.
3. 직접 재 보기
진짜 모델의 100만 토큰 출력을 채점할 방법은 없다. 그래서 정답을 기계적으로 확인할 수 있는 장난감 과제를 만들었다.
- 숫자(0~9) 수열이다. 다음 숫자는 직전 세 숫자로 정해진다(무작위로 만든 규칙표, 상태 1,000가지).
- 작은 신경망이 이 규칙을 일부 궤적에서만 배운다. 1,000가지 상태 중 296가지만 봤다.
- 본 상태에서는 가장 높은 확률을 고르면 100% 맞고, 못 본 상태에서는 11.2% 다(찍기 10%).
- 생성은 모델의 확률에서 뽑는다. 온도를 조절해 토큰당 오류율 을 맞췄다.
- 토큰이 “맞다”는 것은 모델이 쓴 숫자가 자기가 쓴 직전 세 숫자에 규칙을 적용한 값과 같다는 뜻이다.
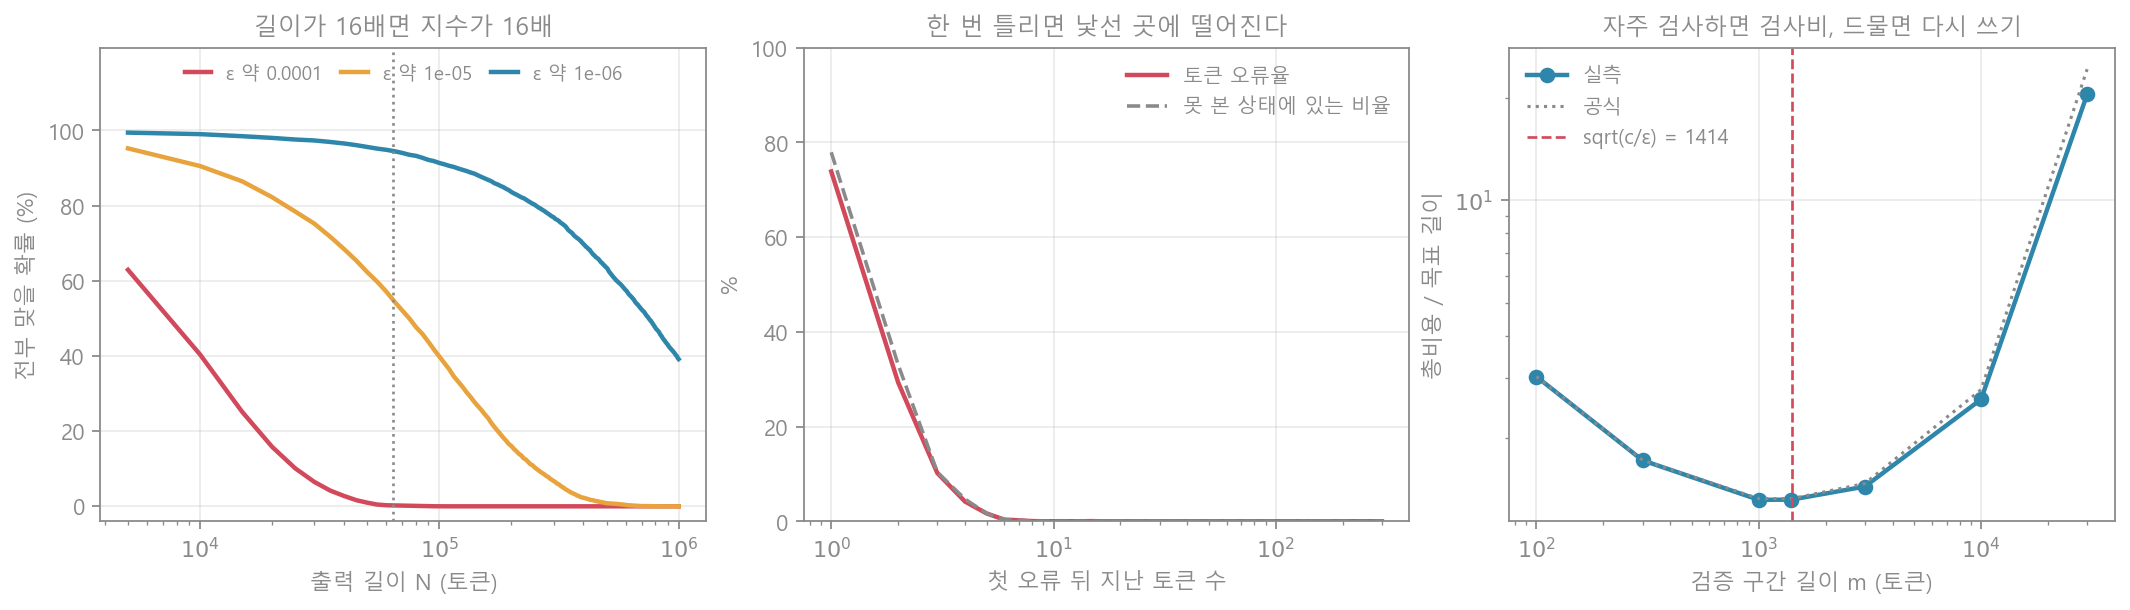
[A] 전부 맞을 확률
궤적 6,000개를 100만 토큰까지 만들어, 한 번도 틀리지 않은 비율을 셌다.
| 토큰당 오류율 (실측) | 6만 5천 토큰 | 공식 | 100만 토큰 | 공식 |
|---|---|---|---|---|
| 0.2% | 0.2% | 0.0% | 0.0% | |
| 54.4% | 55.1% | 0.0% | 0.0% | |
| 94.4% | 94.3% | 39.2% | 40.6% |
- 실측은 공식과 1.4%p 안에서 맞았다.
- 가운데 줄이 한도 변경의 의미를 보여 준다. 10만 토큰에 한 번 틀리는 모델은 예전 한도에서는 절반 넘게 온전한 출력을 냈지만, 100만 토큰에서는 6,000번 중 한 번도 온전하지 못했다.
- 100만 토큰을 절반 이상 온전하게 내려면 이 백만분의 1보다 작아야 한다. 에서도 39.2% 였다.
100만 토큰 실험은 빠르게 돌리려고 모델의 확률표에서 뽑았다(상태가 1,000가지뿐이라 모델의 출력 분포를 표로 만들 수 있다). 신경망을 토큰마다 직접 돌린 짧은 생성도 확인했다. , 2,000토큰에서 전부 맞은 비율이 15.3%, 공식은 13.5% 였다. 2%p 쯤 높은 것은 [C]에서 설명한다.
[B] 한 번 틀린 뒤
인 설정에서, 일부러 틀린 숫자 하나를 쓰게 한 뒤 이어지는 300토큰을 봤다(궤적 20,000개).
| 관찰 | 값 |
|---|---|
| 본 상태의 평균 오류율 | |
| 못 본 상태의 평균 오류율 | 88.3% |
| 틀린 직후 못 본 상태에 있을 확률 | 77.9% |
| 틀린 직후 첫 토큰의 오류율 | 73.9% |
| 이어진 300토큰의 추가 오류 수 | 평균 1.2개 (독립이라면 0.03개) |
| 추가 오류가 하나도 없었던 비율 | 24.5% |
- 오류율이 에서 73.9% 로, 한 토큰 만에 수천 배 뛴다. 틀린 숫자 하나가 모델을 본 적 없는 상태로 떨어뜨리기 때문이다.
- 오류는 무더기로 온다. 첫 오류 뒤 추가 오류는 평균 1.2개로, 독립 가정(0.03개)의 40배다.
- 예상보다 빨리 회복했다. 10번째 토큰에서는 오류율이 0.0% 로 돌아왔고, 300토큰 뒤에 못 본 상태에 남은 궤적은 없었다. 이 과제는 직전 세 숫자만 보기 때문에, 헤매다가 본 상태에 한 번 들어서면 다시 익숙한 길을 탄다. 나는 오류가 눈덩이처럼 불어날 것으로 예상했는데 이 장난감에서는 그렇지 않았다.
회복이 빠른 것은 이 과제의 성질이지 일반적인 사실이 아니다. 실제 긴 출력에서는 앞의 오류가 뒤 전체의 전제가 된다. 함수 이름을 잘못 지으면 그 뒤의 호출이 전부 그 이름을 따라간다. 이 실험이 보여 주는 것은 “틀린 직후가 가장 위험하다”까지다.
[C] 구간마다 검증하고 되돌리기
목표 10만 토큰, , 검증 한 번의 값을 200토큰으로 두었다. 한 번에 쓰면 전부 맞을 확률은 0.005% 다.
| 구간 길이 | 구간당 평균 시도 | 총비용 ÷ 목표 길이 | 공식 |
|---|---|---|---|
| 100 | 1.01번 | 3.03배 | 3.03배 |
| 300 | 1.03번 | 1.72배 | 1.72배 |
| 1,000 | 1.10번 | 1.32배 | 1.33배 |
| 1,400 | 1.14번 | 1.32배 | 1.33배 |
| 3,000 | 1.32번 | 1.44배 | 1.47배 |
| 10,000 | 2.55번 | 2.60배 | 2.77배 |
| 30,000 | 16.95번 | 20.48배 | 24.28배 |
- 가장 싼 곳은 = 1,000~1,400 이고, 이론값 와 맞는다.
- 0.005% 였던 완주가 비용 1.32배로 100% 가 된다. 한 번에 성공할 때까지 통째로 다시 쓰는 것과는 비교가 안 된다(그쪽은 평균 2만 번을 써야 한다).
- 구간이 길 때는 실측이 공식보다 싸다(30,000에서 20.48배 대 24.28배). 긴 생성이 머무는 순환 궤도 위 상태들의 오류율이 에서 까지 고르지 않기 때문이다. 오류율이 낮은 궤도에서 시작한 구간은 쉽게 통과한다. 평균 하나로 만든 공식은 이것을 놓쳐서 조금 비관적이다. [A]의 직접 생성이 공식보다 높았던 것도 같은 이유다.
4. 흔한 오해와 한계
“출력 한도가 늘었으니 16배 긴 일을 맡기면 된다.” 한도는 “쓸 수 있다”이지 “온전하다”가 아니다. 같은 에서 온전할 확률은 지수적으로 줄어든다. Google 이 강조한 “한 흐름 안에서 도구를 부르고 고친다”가 사실은 [C]의 검증과 되돌리기다. 긴 출력의 값은 길이 자체가 아니라 그 안에서 검증하며 갈 수 있는가에 있다.
“오류율이 충분히 낮으면 검증은 필요 없다.” 에서도 100만 토큰은 39.2% 였다. 검증 없이 100만 토큰을 믿으려면 이 아래여야 한다.
“검증은 자주 할수록 좋다.” 에서는 비용이 3.03배였다. 검사에도 값이 있다. 검사가 쌀수록, 오류가 잦을수록 자주 하는 것이 맞다.
이 실험이 다루지 못한 것.
- 검증기가 완벽하다고 가정했다. 실제 검증(테스트, 리뷰)은 오류를 놓친다. 놓친 오류는 그대로 최종 결과에 남는다.
- 토큰 하나의 오류가 똑같이 치명적이라고 보았다. 실제로는 주석의 오타와 조건문의 부호가 다르다. 고칠 수 있는 오류와 전체를 무너뜨리는 오류를 구분하지 않았다.
- 오류가 구간 안에서 끝난다고 보았다. 앞 구간의 설계 실수가 뒤에서야 드러나면 한 구간만 되돌려서는 못 고친다.
- 장난감의 은 내가 온도로 정한 값이다. 실제 모델의 은 과제마다 다르고, 긴 문맥에서 달라질 수 있다.
5. 한 문단 요약
Gemini 4 Argon 은 한 번의 출력 한도를 64K 에서 1M 토큰으로 16배 늘렸다. 토큰당 오류율이 이면 토큰이 전부 맞을 확률은 이라서, 길이가 16배가 되면 지수가 16배가 된다. 장난감 모델에서 일 때 6만 5천 토큰은 54.4% 가 온전했지만 100만 토큰은 한 번도 온전하지 못했고, 에서도 39.2% 였다. 한 번 틀리면 모델은 본 적 없는 문맥에 떨어져 다음 토큰의 오류율이 73.9% 로 뛰었다. 다만 이 과제에서는 10토큰 안에 회복했다. 토큰마다 검증해 틀린 구간만 다시 쓰면, 한 번에 성공할 확률이 0.005% 였던 10만 토큰을 1.32배의 비용으로 끝낼 수 있었다. 가장 싼 구간 길이는 = 1,414 토큰이었다. 긴 출력의 쓸모는 길이가 아니라, 그 길이 안에서 검증하고 되돌릴 수 있느냐에 달려 있다.
참고
- MarkTechPost — Google DeepMind Unveils Gemini 4 Argon with 1M Output Tokens (2026-09-30)
- DataCamp — Gemini 4 Argon: Benchmarks, Pricing, and Access
- mixed-news — Gemini 4 Argon lifts Google’s output limit to 1M tokens, but only cyber defenders have it
- Bengio 외 — Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks (2015) (노출 편향)
- Ross, Gordon, Bagnell — A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning (2011) (오류가 쌓이는 속도)
- 연재: GPU 120만 개 글 · 에이전트와 도구 사용 편 · 디코딩과 샘플링 편