인지야공/오늘의 AI 이슈/18번째 글
5,010억 개 중 230억 개만 켠다 — 4.6% 의 산수
실행:
python 딥러닝/daily/DAILY_2026_10_08_sparse_moe.py(RTX 5080 16GB, 1분 남짓) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. Beam 은 손에 없어서(가중치는 10월 중 공개 예정) 같은 구조를 작게 만들어 쟀다. Beam 의 속도나 성능을 잰 것이 아니다.
1. 무슨 일이 있었나
10월 5일, Reflection AI 가 첫 공개 가중치 모델 Beam 을 발표했다 (Reflection 공식, DataCamp, Unite.AI, Technology.org).
| 항목 | 내용 |
|---|---|
| 구조 | 희소 전문가 혼합(sparse Mixture-of-Experts) |
| 파라미터 | 전체 501B, 토큰마다 쓰는 것은 23B |
| 사전학습 | 23.8조 토큰, Nvidia GB300 NVL72 에서 4주 이내 |
| 강화학습 | 약 10,500개 GPU 로 4주 |
| 문맥 창 | 최대 100만 토큰 |
| 공개 | 가중치·기술 보고서·모델 카드는 10월 중 Apache 2.0 으로 공개 예정. 지금은 신청자에게 먼저 제공 |
회사는 코딩과 에이전트 과제에서 중국의 공개 모델들과 겨룰 만하고, 추론 벤치마크에서 계산을 3~4배 덜 쓴다고 주장했다. 가중치가 아직 나오지 않아 이 주장은 외부에서 확인되지 않았다.
이 글이 보는 것은 숫자 두 개의 비율이다. . 모델의 95% 는 토큰 하나를 만들 때 쉬고 있다. 이 설계가 무엇을 사고 무엇을 치르는지 셈한다.
2. 핵심 개념 — 담아 둔 것과 켠 것
전문가 혼합
전문가 혼합 편에서 본 구조다. 큰 층 하나를 전문가 여러 개로 쪼개고, 토큰마다 라우터가 그중 몇 개만 고른다. 병원에 과가 수십 개 있어도 환자 한 명은 두세 과만 들르는 것과 같다. 병원의 크기(담아 둔 지식)와 환자 한 명의 진료 시간(켠 계산)이 따로 논다.
| 기호 | 뜻 |
|---|---|
| 담아 둔 전문가의 수 | |
| 토큰 하나가 켜는 전문가의 수 | |
| 활성 비율. Beam 은 파라미터 기준으로 4.6% | |
| 배치. 동시에 처리하는 토큰의 수 |
Beam 의 공개 수치로 메모리를 셈하면 이렇다(스크립트에서 계산).
| 자료형 | 전체를 담는 데 | 토큰 하나가 읽는 양 |
|---|---|---|
| bf16 (16비트) | 1,002 GB | 46 GB |
| 4비트 양자화 | 250 GB | 11.5 GB |
메모리 대역폭 글에서 본 것처럼, 토큰 하나를 만드는 시간은 읽은 바이트 ÷ 대역폭이다. 희소 모델은 담는 데 1,002 GB 가 들지만 읽는 것은 46 GB 다. 용량과 속도를 따로 살 수 있다는 것이 이 설계의 요점이다.
둘째 식 — 배치의 함정
토큰 하나는 전문가의 4.6% 만 읽는다. 그런데 서버는 토큰을 한 개씩 처리하지 않고 여러 요청을 묶는다. 토큰마다 고르는 전문가가 다르다. 토큰 개가 각자 개씩 고르면, 합쳐서 건드리는 전문가는 금방 늘어난다.
숫자로 따라가 보자. 전문가 64개 중 3개씩 고른다(4.7%).
- 토큰 하나가 어떤 전문가를 안 고를 확률은 .
- 토큰 16개가 모두 그 전문가를 안 고를 확률은 .
- 그러니 그 전문가가 한 번이라도 쓰일 확률은 . 전문가의 절반 넘게를 읽어야 한다.
3. 직접 재 보기
전문가 하나를 8192×8192 bf16 행렬(128 MB)로 만들었다. 전문가 64개면 8.6 GB 다.
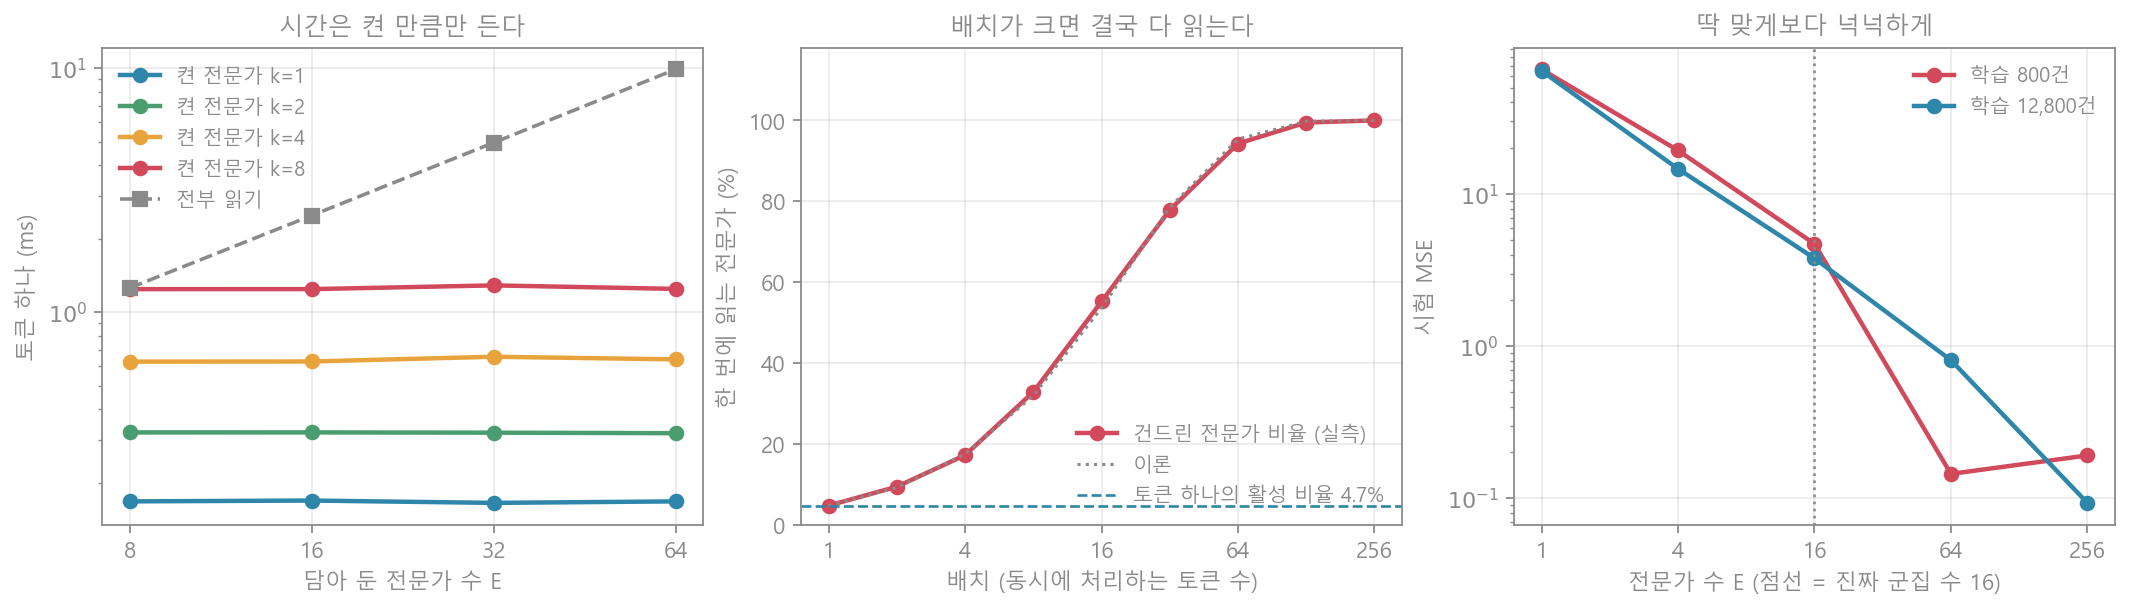
[A] 토큰 하나: 시간은 켠 만큼만 든다
배치 1에서, 담아 둔 전문가 수 와 켜는 수 를 바꿔 가며 토큰 하나의 시간을 쟀다.
| 담아 둔 전문가 | 담아 둔 양 | k=1 | k=2 | k=4 | k=8 | 전부 읽으면 |
|---|---|---|---|---|---|---|
| 8 | 1.1 GB | 0.168 ms | 0.322 ms | 0.628 ms | 1.245 ms | 1.26 ms |
| 16 | 2.1 GB | 0.169 ms | 0.322 ms | 0.629 ms | 1.245 ms | 2.49 ms |
| 32 | 4.3 GB | 0.166 ms | 0.321 ms | 0.658 ms | 1.289 ms | 4.96 ms |
| 64 | 8.6 GB | 0.168 ms | 0.320 ms | 0.642 ms | 1.247 ms | 9.90 ms |
- 세로로 읽으면 변화가 없다. 전문가를 8개에서 64개로 8배 늘려도 k=1 의 시간은 0.168 ms 그대로다. 담아 둔 양은 시간에 들어오지 않는다.
- 가로로 읽으면 정비례한다. k 가 두 배면 시간도 두 배다.
- 전문가 64개를 전부 읽으면 9.90 ms 다. 3개만 켜는 경우(아래 [B]의 배치 1, 0.55 ms)의 18.0배다.
Beam 이 주장하는 “추론 계산 3~4배 절약”이 어디서 오는지 구조만으로도 짐작이 된다. 같은 501B 를 전부 읽는 모델과 비교하면 이득은 훨씬 크고, 23B 짜리 조밀한 모델과 비교하면 속도는 같고 담아 둔 지식이 많다.
[B] 배치를 키우면 결국 다 읽는다
전문가 64개, 토큰마다 3개(활성 4.7%, Beam 의 4.6% 에 맞췄다). 토큰마다 전문가를 무작위로 고르게 하고 배치를 키웠다.
| 배치 | 건드린 전문가 (실측) | 이론 | 한 번의 시간 | 토큰당 |
|---|---|---|---|---|
| 1 | 3.0개 (4.7%) | 3.0 | 0.55 ms | 0.550 ms |
| 4 | 11.0개 (17%) | 11.2 | 1.92 ms | 0.480 ms |
| 16 | 35.3개 (55%) | 34.3 | 6.39 ms | 0.400 ms |
| 64 | 60.3개 (94%) | 61.0 | 12.92 ms | 0.202 ms |
| 256 | 64.0개 (100%) | 64.0 | 14.14 ms | 0.055 ms |
- 건드리는 전문가 수는 2절의 식과 1개 안에서 맞았다. 절반을 넘기는 배치는 이론상 이다.
- 배치 16 에서 이미 모델의 55% 를 읽는다. “4.6% 만 쓴다”는 토큰 하나의 이야기이고, 묶음 전체로는 사라진다.
- 배치 256 에서 한 번의 시간(14.14 ms)은 전문가를 전부 읽는 시간(9.90 ms)보다 길다. 메모리에서 읽는 양으로는 희소성의 이득이 남지 않았다.
- 토큰당 시간은 계속 줄어든다(0.550 → 0.055 ms). 그런데 이것은 희소성 덕이 아니라, 읽은 전문가를 여러 토큰이 나눠 쓰는 배치의 이득이다. 조밀한 모델도 똑같이 얻는다.
정리하면, 희소 모델의 속도 이득은 혼자 쓰는 환경(내 PC, 로봇, 배치가 작은 서버)에서 가장 크다. 요청을 수백 개씩 묶는 큰 서버에서는 메모리를 읽는 양이 조밀한 모델과 비슷해지고, 남는 이득은 곱셈 횟수(연산)가 적다는 것뿐이다.
[C] 전문가는 몇 개가 맞나
전문가를 늘리면 전문가 하나가 보는 데이터는 줄어든다. 501B 를 23B 씩 쓰면 파라미터 하나가 학습 신호를 받는 토큰은 전체의 4.6% 다. 그래서 “데이터가 정해져 있으면 전문가를 너무 늘릴 때 굶어서 나빠진다”고 예상했다.
진짜 군집이 16개이고 군집마다 규칙이 다른 장난감 과제로 쟀다(시드 3개 평균, 잡음만 남으면 MSE 0.09).
| 학습 데이터 | 전문가 수 | 시험 MSE | 실제로 쓰인 전문가 | 쓰인 전문가 하나가 본 학습 건수 |
|---|---|---|---|---|
| 800 | 4 | 19.347 | 4.0 | 183 |
| 800 | 16 | 4.701 | 11.7 | 55 |
| 800 | 64 | 0.144 | 16.0 | 51 |
| 800 | 256 | 0.191 | 16.7 | 45 |
| 12,800 | 16 | 3.780 | 11.3 | 821 |
| 12,800 | 64 | 0.808 (0.093~1.353) | 15.3 | 798 |
| 12,800 | 256 | 0.093 | 16.0 | 796 |
예상은 틀렸다. 굶어서 나빠지지 않았다.
- 남는 전문가는 굶지 않고 그냥 안 쓰인다. 전문가를 256개 줘도 쓰인 것은 16~17개였다. 쓰인 전문가가 본 데이터는 전문가 수와 거의 무관했다(51건과 45건).
- 딱 맞게 주면 오히려 나쁘다. 군집이 16개인데 전문가를 16개 주면 11.7개만 쓰였다. 몇 개가 같은 군집을 두고 겹치거나 죽어서, 남은 전문가가 여러 군집을 떠맡았다. MSE 는 4.701 로, 64개를 줬을 때(0.144)의 33배다.
- 데이터가 800건뿐일 때는 256개(0.191)가 64개(0.144)보다 조금 나빴다. 시드 범위(0.153~0.238)가 넓어서 “과하면 살짝 손해일 수 있다” 정도만 말할 수 있다.
전문가를 넉넉히 두는 것은 낭비가 아니라 라우터가 군집을 다 찾을 여유였다. 다만 이 여유의 값은 메모리다. 안 쓰이는 전문가도 자리는 차지한다.
4. 흔한 오해와 한계
“501B 모델이니 501B 만큼 똑똑하다.” 토큰 하나를 만드는 계산은 23B 다. 501B 는 고를 수 있는 지식의 폭이고, 한 번에 쓰는 깊이가 아니다.
“4.6% 만 쓰니 메모리도 4.6% 면 된다.” 어느 전문가가 불릴지 미리 알 수 없어서 전부 올려 둬야 한다. bf16 로 1,002 GB, 4비트로도 250 GB 다. 공개 가중치라도 집에서 돌릴 크기가 아니다.
“희소 모델은 언제나 빠르다.” [B]에서 배치 16 이면 모델의 55% 를 읽었다. 이득이 가장 큰 것은 배치 1 이다.
“전문가가 많으면 데이터가 모자라 굶는다.” 내 예상이었고 [C]에서 틀렸다. 다만 실제 학습에서는 전문가가 고르게 쓰이도록 보조 손실을 넣는다. 그러면 남는 전문가도 억지로 데이터를 나눠 받으므로 결과가 다를 수 있다. 이 실험은 그런 손실 없이 쟀다.
실험의 한계.
- [A]와 [B]는 행렬 곱 하나로 만든 모형이다. 실제 모델에는 어텐션과 라우터 계산이 더해진다.
- [B]에서 전문가를 무작위로 골랐다. 실제로는 비슷한 요청이 비슷한 전문가를 고르므로, 건드리는 전문가가 식보다 천천히 늘 수 있다. 식은 가장 나쁜 쪽에 가깝다.
- [B]에서 조밀한 모델의 큰 배치 시간은 직접 재지 않았다. 배치 1 로 전부 읽는 시간과 견주었다.
- Beam 의 실제 전문가 수와 층 구조는 기술 보고서가 나와야 알 수 있다. 여기서 쓴 “64개 중 3개”는 4.6% 라는 비율만 맞춘 것이다.
5. 한 문단 요약
Reflection 의 Beam 은 파라미터 501B 중 토큰마다 23B(4.6%)만 쓰는 희소 전문가 혼합 모델이다. 담는 데는 bf16 로 1,002 GB 가 들지만 토큰 하나가 읽는 것은 46 GB 다. 작은 모형에서 토큰 하나의 시간은 담아 둔 전문가 수와 무관하게 0.168 ms 였고 켠 수에만 비례했다. 64개 중 3개만 켜면 전부 읽을 때보다 18.0배 빨랐다. 그런데 토큰마다 다른 전문가를 고르기 때문에, 배치 16 이면 전문가의 55% 를, 배치 64 면 94% 를 읽는다. 희소성의 속도 이득은 배치가 작을 때의 것이다. 전문가 수는 진짜 군집 수에 딱 맞추면 일부가 겹치거나 죽어 MSE 가 4.701 이었고, 넉넉히 64개를 주면 0.144 였다. 남는 전문가는 굶지 않고 그냥 안 쓰였다. 희소 설계는 메모리를 내고 “고를 수 있는 폭”을 사는 거래다.
참고
- Reflection — Introducing Beam: Reflection’s 501B open-weight model (2026-10-05)
- DataCamp — Beam: Reflection AI’s 501B Open-Weight Model
- Unite.AI — Reflection AI Unveils Beam, a 501B-Parameter Open-Weight Model
- Technology.org — Reflection AI Launches Beam Open-Weight Model (2026-10-06)
- Shazeer 외 — Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer (2017)
- Jiang 외 — Mixtral of Experts (2024)
- 연재: 전문가 혼합 편 · 메모리 대역폭 글 · 산술 강도와 메모리 대역폭 노트