인지야공/딥러닝 기초 정리/34번째 글
가지치기와 복권 가설 — 가중치의 90% 를 지워도 되는 이유
실행:
python NN_63_pruning.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 8분. 추론 시간은 CPU 1스레드로 쟀다) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
학습이 끝난 신경망의 가중치는 대부분 0 근처에 몰려 있다. 그렇다면 작은 것들은 지워도 되지 않을까. 이것이 가지치기(pruning) 다. 양자화 편이 가중치 하나에 쓰는 비트를 줄였다면, 가지치기는 가중치의 개수를 줄인다. 이 편은 질문 셋을 잰다.
- 얼마나 지워도 되나. 무엇을 기준으로 지워야 하나
- 지우고 남은 작은 망을 처음부터 학습할 수는 없나 (복권 가설)
- 지우면 정말 빨라지나
1. 지운다는 것
마스크
가중치 행렬 와 같은 모양의 0/1 행렬 을 둔다. 실제로 쓰는 가중치는 둘을 자리별로 곱한 것이다.
| 기호 | 뜻 |
|---|---|
| 한 층의 가중치 행렬 | |
| 마스크. 1 이면 남기고 0 이면 지운다 | |
| 같은 자리끼리 곱하기 | |
| 문턱값. 절댓값이 이보다 작은 가중치를 지운다 | |
| 가지치기한 뒤 실제로 쓰는 가중치 |
크기 기준 가지치기는 절댓값이 작은 순서로 지운다. 근거는 단순하다. 가중치 를 0 으로 바꾸면 그 연결의 출력이 만큼 바뀐다. 가 작으면 바뀌는 양도 작다.
문턱값을 정하는 방법은 둘이다.
- 전역: 모든 층의 가중치를 한 줄로 세워 작은 것부터 지운다. 층마다 지워지는 비율이 달라진다.
- 층별: 층마다 같은 비율을 지운다.
지운 뒤에는 보통 재학습한다. 남은 가중치가 빈자리를 메우도록 몇 스텝 더 학습하는 것이다. 지워진 자리는 스텝마다 다시 0 으로 눌러 둔다.
한 번에 지우기와 나눠 지우기
90% 를 한 번에 지울 수도 있고, 조금 지우고 학습하기를 되풀이할 수도 있다. 매 회 남은 것의 비율 를 지우면 회 뒤에 남는 비율은 다음과 같다.
로 따라가 보면 1회 80%, 2회 64%, 3회 51.2% 이고, 10회 뒤에 가 남는다. 90% 를 지우는 데 학습을 열 번 한다는 뜻이다.
복권 가설
여기서 질문이 하나 생긴다. 다 배운 뒤에 90% 를 지워도 된다면, 처음부터 그 10% 만 가지고 학습하면 되지 않나. 해 보면 잘 안 된다. 작은 망을 처음부터 학습하면 큰 망을 학습해 줄인 것보다 못하다.
복권 가설(Frankle·Carbin, 2019)은 이 차이를 이렇게 설명한다. 무작위로 초기화한 큰 망 안에는, 따로 떼어 학습해도 전체만큼 배우는 작은 부분망이 들어 있다. 이것을 “당첨 복권”이라 부른다. 당첨을 정하는 것은 연결의 모양(마스크)만이 아니라 그 연결이 처음에 받은 초기값까지다. 큰 망은 복권을 많이 사는 셈이고, 학습은 그중 당첨된 것을 찾아내는 과정이라는 것이다.
확인하는 절차는 다음과 같다.
- 큰 망을 초기화하고 그 초기값 을 따로 저장한다
- 학습한 뒤 작은 가중치를 지워 마스크 을 얻는다
- 남은 가중치를 의 값으로 되감는다
- 에서 다시 학습한다. 2~4 를 되풀이한다
대조군은 둘이다. 같은 마스크에 초기값만 새로 뽑은 것, 그리고 초기값은 그대로 두고 마스크의 자리만 무작위로 바꾼 것. 가설이 맞다면 둘 다 당첨 표보다 못해야 한다.
낱개로 지우기와 통째로 지우기
| 방식 | 지우는 단위 | 남는 것 |
|---|---|---|
| 비구조적 (낱개) | 가중치 하나 | 같은 크기의 행렬, 군데군데 0 |
| 구조적 (통째) | 뉴런·채널·헤드 하나 | 더 작은 행렬 |
낱개로 지우면 지울 자리를 가장 자유롭게 고를 수 있다. 대신 행렬의 크기는 그대로다. 0 을 건너뛰려면 희소 형식으로 저장해야 하는데, 그때는 값마다 자리 번호를 함께 적어야 한다.
이 편의 모델로 계산하면(실측이 아니라 산수다) 다음과 같다.
| 계산 | 크기 | |
|---|---|---|
| 원래 (32비트 값 108,000개) | 432 KB | |
| 90% 지움, 값 + 열 번호 (각 32비트) | 86 KB |
가중치는 10% 가 남았는데 저장 공간은 20% 다. 절반을 지운 정도로는 자리 번호 때문에 이득이 없다.
2. 직접 재 보기
모델은 완전연결 256 → 300 → 100 → 12 이고 가중치는 108,000개다(1층 76,800, 2층 30,000, 3층 1,200). 편향은 지우지 않았다. 데이터는 16×16 도형 12종, 학습 3,600장, 시험 2,400장이다. 무작위로 찍으면 8.3% 다. 가지치기하지 않은 기준 모델은 학습 정확도 100.0%, 시험 정확도 78.9% 다(시드 3개, 78.7~79.4). 학습 데이터를 다 외운 과적합 상태라는 점을 기억해 둔다.
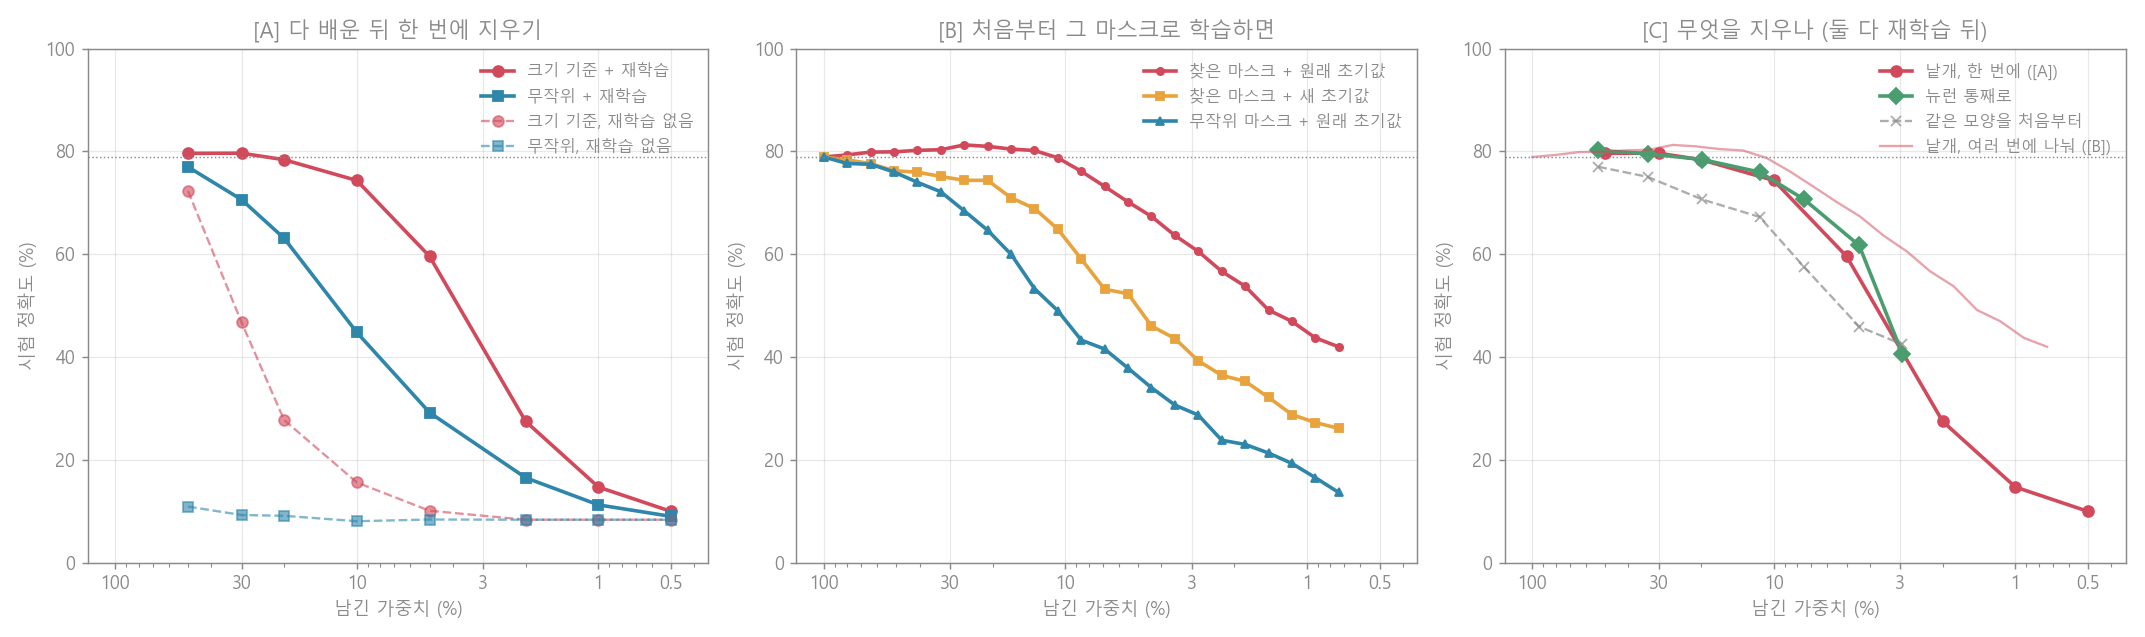
[A] 다 배운 뒤 한 번에 지우기
기준 모델을 1,500스텝 학습한 뒤 한 번에 지웠다. 재학습은 1,500스텝이다. 시드 3개 평균이다.
| 지운 비율 | 남은 가중치 | 크기 기준 (재학습 없음) | 무작위 (재학습 없음) | 크기 기준 + 재학습 | 무작위 + 재학습 |
|---|---|---|---|---|---|
| 50% | 54,000 | 72.3% | 10.9% | 79.6% | 77.0% |
| 70% | 32,400 | 46.7% | 9.3% | 79.7% | 70.6% |
| 80% | 21,600 | 27.7% | 9.1% | 78.4% | 63.1% |
| 90% | 10,800 | 15.6% | 8.0% | 74.4% | 44.8% |
| 95% | 5,400 | 10.1% | 8.4% | 59.6% | 29.2% |
| 98% | 2,160 | 8.3% | 8.3% | 27.5% | 16.5% |
| 99% | 1,080 | 8.3% | 8.3% | 14.7% | 11.2% |
- 80% 까지는 손해가 없다. 크기 기준으로 지우고 재학습하면 78.4% 로, 기준 78.9% 와 0.5%p 차이다. 50
70% 에서는 기준보다 조금 높았다(79.679.7%). - 90% 에서 4.5%p, 95% 에서 19.3%p 를 잃는다. 손해는 서서히 오다가 어느 지점부터 급해진다.
- 무엇을 지우느냐가 중요하다. 90% 를 무작위로 지우면 재학습해도 44.8% 다. 크기 기준과 29.6%p 차이다.
- 재학습 없이는 절반만 지워도 깎인다. 크기 기준으로 50% 를 지우면 72.3%, 70% 면 46.7% 다. 무작위는 절반만 지워도 찍는 수준(10.9%)이 된다. “작은 가중치는 없어도 된다”는 말은 재학습까지 포함해야 맞다.
전역과 층별의 차이는 작았다.
| 지운 비율 | 전역 + 재학습 | 층별 + 재학습 |
|---|---|---|
| 80% | 78.4% | 79.0% |
| 90% | 74.4% | 74.6% |
| 95% | 59.6% (57.2~62.2) | 57.6% (53.8~60.3) |
| 98% | 27.5% (26.9~28.4) | 28.9% (24.0~31.7) |
어느 쪽이 낫다고 말할 수 없다. 차이가 시드 범위 안이다. 그런데 전역 기준이 실제로 고른 비율은 층마다 크게 달랐다(시드 0).
| 전체에서 지운 비율 | 1층에 남은 비율 | 2층 | 3층 |
|---|---|---|---|
| 90% | 5.1% | 21.2% | 42.3% |
| 98% | 0.3% | 5.8% | 17.9% |
입력에 가까운 큰 층이 가장 많이 지워지고, 클래스 점수를 내는 마지막 층이 가장 많이 남는다. 이렇게 다르게 골랐는데도 층별과 정확도가 같았다는 것이 이 표에서 읽을 수 있는 전부다.
예상이 빗나간 것 하나. 첫 층에서 지워지는 연결은 도형이 닿지 않는 가장자리 픽셀에 몰릴 것이라고 예상했다. 그렇지 않았다.
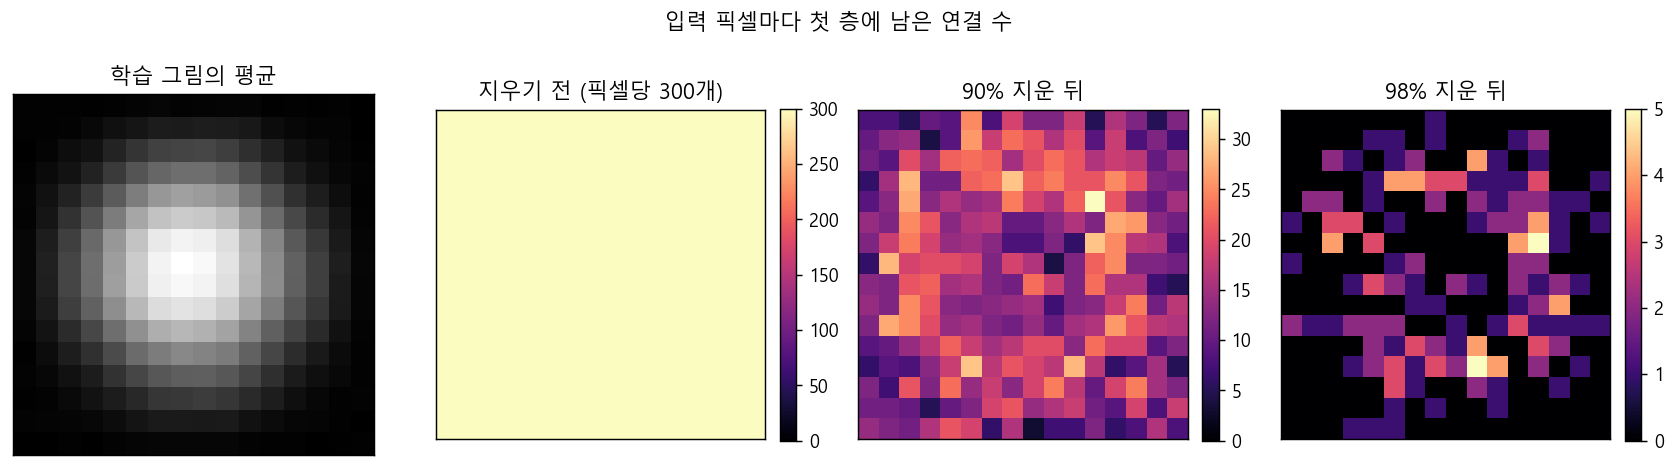
90% 를 지운 뒤 픽셀 하나에 남은 연결은 가운데 8×8 에서 평균 15.3개, 바깥에서 15.4개로 같았다. 98% 를 지우면 256개 픽셀 가운데 146개가 연결을 전부 잃는데, 그때도 가운데 1.0개, 바깥 0.7개로 차이가 작다. 이 데이터는 도형의 중심이 최대 3픽셀까지 움직이고 잡음이 전체에 깔려 있어서, 쓸모없다고 잘라 말할 픽셀이 없었던 것으로 보인다.
[B] 복권 가설
매 회 남은 가중치의 20% 를 지우고, 남은 것을 초기값으로 되감아 1,500스텝을 다시 학습했다. 22회 되풀이했다. 시드 3개 평균이고 괄호는 범위다.
| 회 | 남은 비율 | 찾은 마스크 + 원래 초기값 | 찾은 마스크 + 새 초기값 | 무작위 마스크 + 원래 초기값 |
|---|---|---|---|---|
| 0 | 100% | 78.9% | 78.9% | 78.9% |
| 6 | 26.2% | 81.3% (81.0~81.9) | 74.4% (73.7~75.0) | 68.4% (68.2~68.8) |
| 9 | 13.4% | 80.2% (79.7~80.8) | 68.9% (68.5~69.4) | 53.3% (51.7~54.9) |
| 10 | 10.7% | 78.8% (77.5~80.5) | 64.9% (63.7~67.0) | 49.0% (47.5~50.0) |
| 13 | 5.5% | 70.2% (69.3~70.9) | 52.3% (49.3~54.6) | 37.8% (36.9~39.0) |
| 16 | 2.8% | 60.6% (59.3~61.3) | 39.3% (37.0~40.6) | 28.7% (27.6~30.0) |
| 22 | 0.74% | 42.0% (41.5~42.4) | 26.1% (25.3~26.8) | 13.6% (12.8~14.8) |
- 10.7% 만 남기고 처음부터 학습해 전체와 같은 정확도가 나왔다(78.8% 대 78.9%). 가중치 11,597개다.
- 26% 를 남겼을 때는 전체보다 2.4%p 높았다(81.3%). 기준 모델이 학습 데이터를 외운 상태였으므로, 연결을 줄인 것이 규제로 작용한 것으로 읽는다. 과적합과 규제 편에서 본 것과 같은 방향이다.
- 초기값이 당첨의 일부다. 같은 마스크에 초기값만 새로 뽑으면 10.7% 에서 64.9% 로, 13.9%p 낮다. 세 시드의 범위가 겹치지 않는다.
- 마스크도 당첨의 일부다. 초기값을 그대로 두고 자리만 무작위로 바꾸면 49.0% 다. 마스크를 잃는 손해(29.8%p)가 초기값을 잃는 손해보다 컸다.
- 가중치 798개(0.74%)로도 당첨 표는 42.0% 를 낸다. 무작위 마스크는 13.6% 로 찍는 수준에 가깝다.
당첨 표는 빨리 배우기도 한다. 학습 100스텝째의 시험 정확도다.
| 남은 비율 | 찾은 마스크 + 원래 초기값 | 찾은 마스크 + 새 초기값 |
|---|---|---|
| 100% | 31.1% | 33.1% |
| 51.2% | 48.2% | 24.6% |
| 21.0% | 53.9% | 18.3% |
| 10.7% | 38.5% | 16.0% |
가중치를 5분의 1 로 줄인 망이 전체 망보다 같은 스텝에 22.8%p 앞서 있다.
한 번에 지우기와 견주면. [A] 에서 90% 를 한 번에 지우고 재학습한 것은 74.4% 였다. 나눠 지운 쪽은 10.7% 를 남기고 78.8% 다. 95% 근처에서는 59.6% 대 70.2% 로 더 벌어진다. 다만 공짜가 아니다. 나눠 지운 쪽은 10.7% 에 닿기까지 학습을 열 번, 5.5% 까지 열세 번 했다. 그리고 두 방법은 지우는 횟수만이 아니라 되감기를 하느냐도 다르다. 어느 쪽 덕인지는 이 실험으로 가를 수 없다.
[C] 낱개로 지우기와 뉴런 통째로 지우기
뉴런을 통째로 지울 때는 “들어오는 가중치의 크기 × 나가는 가중치의 크기”가 작은 뉴런부터 지웠다. 두 은닉층에서 같은 비율을 남겼고 1,500스텝 재학습했다. 대조군으로 같은 모양의 작은 망을 처음부터 1,500스텝 학습했다.
| 남긴 뉴런 | 망의 모양 | 가중치 수 (비율) | 통째로 지움 + 재학습 | 같은 모양을 처음부터 |
|---|---|---|---|---|
| 60% | 256-180-60-12 | 57,600 (53.3%) | 80.2% | 77.0% |
| 25% | 256-75-25-12 | 21,375 (19.8%) | 78.4% | 70.7% |
| 15% | 256-45-15-12 | 12,375 (11.5%) | 76.0% | 67.3% |
| 10% | 256-30-10-12 | 8,100 (7.5%) | 70.7% | 57.5% |
| 6% | 256-18-6-12 | 4,788 (4.4%) | 61.7% | 45.9% |
| 4% | 256-12-4-12 | 3,168 (2.9%) | 40.6% (34.5~46.5) | 42.4% (37.6~46.5) |
- 큰 망을 학습해 줄인 것이 작은 망을 처음부터 학습한 것보다 낫다. 256-30-10-12 에서 70.7% 대 57.5% 로 13.2%p 차이다. 복권 가설이 설명하려던 바로 그 현상이다.
- 맨 아래 줄에서는 차이가 사라진다. 둘째 은닉층이 뉴런 4개인데 클래스는 12개다. 이 폭에서는 어디서 출발하든 정보가 지나갈 길이 좁다.
내 예상과 달랐던 것. 같은 가중치 수라면 자리를 자유롭게 고르는 낱개 쪽이 더 정확할 것이라고 예상했다. 한 번에 지운 경우에는 그렇지 않았다.
| 남은 가중치 | 낱개, 한 번에 ([A]) | 뉴런 통째로 | 낱개, 나눠서 ([B]) |
|---|---|---|---|
| 약 10~11% | 74.4% (10%) | 76.0% (11.5%) | 78.8% (10.7%) |
| 약 4~5% | 59.6% (5%) | 61.7% (4.4%) | 67.4% (4.4%) |
통째로 지운 쪽이 한 번에 낱개로 지운 쪽과 같거나 조금 높다. 낱개가 앞선 것은 여러 번에 나눠 지웠을 때뿐이다. 세 열의 남은 비율이 정확히 같지 않으므로 1~2%p 차이는 읽지 않는다. “낱개가 항상 더 정확하다”가 이 설정에서 성립하지 않았다는 것까지만 말한다.
빨라지는가. CPU 1스레드에서 2,048장을 한 묶음으로 넣었을 때의 시간이다(300회의 중앙값, 정확도는 시드 0).
| 모델 | 남은 가중치 | 추론 시간 | 원래 대비 | 정확도 |
|---|---|---|---|---|
| 원래 | 100% | 4.83 ms | 1.0배 | 78.9% |
| 낱개 90% 지움, 0 을 채워 둔 행렬 | 10% | 4.93 ms | 1.0배 | 74.8% |
| 낱개 90% 지움, 희소 형식(CSR) | 10% | 1.70 ms | 2.8배 | 74.8% |
| 낱개 98% 지움, 희소 형식(CSR) | 2% | 0.67 ms | 7.2배 | 26.9% |
| 뉴런 25% 남김 | 19.8% | 1.20 ms | 4.0배 | 78.5% |
| 뉴런 10% 남김 | 7.5% | 0.53 ms | 9.1배 | 71.1% |
- 0 을 채워 둔 행렬은 조금도 빨라지지 않았다(4.93ms 대 4.83ms). 행렬 곱셈은 값이 0 인지 보지 않고 전부 곱한다. 마스크만 씌운 가지치기는 계산량으로 보면 아무것도 하지 않은 것이다.
- 희소 형식으로 바꾸면 빨라지지만 지운 만큼은 아니다. 가중치가 10분의 1 인데 시간은 2.8분의 1 이다. 자리 번호를 따라가며 띄엄띄엄 읽는 비용이 든다.
- 통째로 지운 쪽이 같은 시간에 더 정확하다. 뉴런 25% 를 남긴 망은 희소 형식 90% 보다 빠르고(1.20ms 대 1.70ms) 가중치는 두 배 많으며 정확도는 3.7%p 높다. 작아진 조밀 행렬은 하드웨어가 가장 잘하는 계산이다.
3. 흔한 오해와 한계
“가지치기하면 모델이 빨라진다.” 0 을 채워 둔 행렬은 4.83ms 가 4.93ms 였다. 빨라지려면 희소 형식과 그것을 지원하는 연산이 있거나, 구조를 통째로 지워야 한다.
“작은 가중치는 쓸모없다.” 재학습 없이 작은 것 70% 를 지우면 78.9% 가 46.7% 가 된다. 하나하나는 작아도 합치면 크다. 지워도 되는 것은 남은 가중치가 다시 맞춰질 기회를 얻기 때문이다.
“10% 로 충분하다면 처음부터 10% 짜리 망을 학습하면 된다.” 무작위로 고른 10% 를 학습하면 49.0%, 같은 가중치 수의 좁은 망을 처음부터 학습하면 67.3%(11.5%)다. 어느 10% 인지는 큰 망을 학습해 봐야 알 수 있었다. 당첨 표를 찾는 데 전체 학습을 열 번 했으므로, 이 실험의 복권 가설은 학습 비용을 줄여 주지 않는다. 줄어드는 것은 추론 비용이다.
“낱개로 지우는 쪽이 항상 더 정확하다.” 한 번에 지웠을 때는 뉴런을 통째로 지운 쪽과 차이가 없었다.
실험의 한계. 작은 완전연결망과 도형 데이터다. 기준 모델이 과적합 상태라, 가지치기가 정확도를 올린 구간은 규제 효과가 섞여 있다. 과적합하지 않은 모델에서는 “손해 없이 지울 수 있는 비율”이 더 작을 수 있다. 복권 가설은 큰 모델에서 초기값이 아니라 학습 초반의 값으로 되감아야 성립한다고 보고돼 있는데(Frankle 외, 2020), 그 변형은 재지 않았다. 추론 시간은 CPU 한 대, 배치 하나, 이 크기의 행렬에서 잰 값이다. 행렬이 훨씬 크거나 희소 연산 전용 하드웨어를 쓰면 희소 형식의 성적이 달라진다. 기울기나 헤시안으로 중요도를 재는 기준, 학습 전에 지우는 방법은 다루지 않았다.
4. 한 문단 요약
가지치기는 가중치를 0 으로 바꿔 개수를 줄이는 일이다. 다 배운 망에서 절댓값이 작은 가중치 80% 를 지우고 재학습하면 정확도가 78.9% 에서 78.4% 로, 90% 를 지우면 74.4% 로 내려간다. 같은 90% 를 무작위로 지우면 44.8% 다. 재학습 없이는 70% 만 지워도 46.7% 가 되므로, 지워도 되는 것은 남은 가중치가 다시 맞춰지기 때문이다. 여러 번에 나눠 지우고 그때마다 초기값으로 되감으면 10.7% 만 남기고도 전체와 같은 78.8% 가 나온다. 그 마스크에 초기값만 새로 뽑으면 64.9%, 자리만 무작위로 바꾸면 49.0% 다. 연결의 모양과 처음 받은 값이 함께 당첨을 정한다. 계산은 다른 문제다. 0 을 채워 둔 행렬은 빨라지지 않았고(4.93ms 대 4.83ms), 희소 형식은 가중치가 10분의 1 일 때 2.8배 빨랐다. 뉴런을 통째로 지워 행렬 자체를 줄인 쪽이 9.1배로 가장 빨랐다.
참고
- LeCun, Denker, Solla — Optimal Brain Damage (1989)
- Han 외 — Learning both Weights and Connections for Efficient Neural Networks (2015)
- Frankle, Carbin — The Lottery Ticket Hypothesis (2019)
- Frankle 외 — Linear Mode Connectivity and the Lottery Ticket Hypothesis (2020) (학습 초반 값으로 되감기)
- Liu 외 — Rethinking the Value of Network Pruning (2019) (줄인 구조를 처음부터 학습하는 대조군)
- 연재: 양자화 편 · 가중치 초기화 편 · 지식 증류 편