인지야공/딥러닝 기초 정리/17번째 글
하이퍼파라미터 탐색 — 격자보다 무작위, 그리고 많이 고를수록 생기는 착시
실행:
python NN_61_hparam_search.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 1분 남짓) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
모델이 스스로 배우는 값을 파라미터라 하고, 사람이 학습 전에 정해 줘야 하는 값을 하이퍼파라미터라 한다. 학습률, 배치 크기, 가중치 감쇠, 층의 폭 같은 것들이다. 최적화 편과 과적합과 규제 편에서 이 값들이 각각 무엇을 하는지 봤다. 이 편은 그 값들을 어떻게 찾는가를 다룬다. 세 가지를 잰다.
- 여러 값 중 무엇이 결과를 정하나
- 정해진 횟수 안에서 어떻게 뽑아야 하나. 가지런한 격자인가, 무작위인가
- 그렇게 고른 “최고”의 점수는 믿을 만한가
1. 격자가 손해 보는 이유
축마다 서로 다른 값을 몇 개 시험하나
하이퍼파라미터가 둘이고 학습을 16번 할 수 있다고 하자.
- 격자 탐색: 축마다 4개 값을 정해 개의 조합을 모두 돈다.
- 무작위 탐색: 범위 안에서 16개의 점을 아무렇게나 뽑는다.
격자가 꼼꼼해 보인다. 그런데 두 값 중 하나만 중요하다면 이야기가 달라진다. 격자는 중요한 축에서 서로 다른 값을 4개만 시험한다. 나머지 12번은 이미 본 값을 되풀이한 것이다. 무작위는 16번 모두 다른 값이다.
한 번이라도 걸릴 확률
잘 되는 설정이 전체 범위의 비율 만큼을 차지한다고 하자. 무작위로 번 뽑아 한 번이라도 그 안에 들 확률은 이렇다.
| 기호 | 뜻 |
|---|---|
| 탐색 범위 중 “잘 되는” 설정이 차지하는 비율 | |
| 시험한 설정의 수 |
숫자 예: 면 에서 다. 하이퍼파라미터가 몇 개든 이 식은 같다. 격자는 차원이 늘 때마다 필요한 횟수가 곱으로 늘지만(축마다 4개면 ), 무작위는 만 본다.
고르는 일 자체가 점수를 부풀린다
후보 여럿의 검증 점수를 보고 최고를 고른다. 그런데 검증 점수에는 우연이 섞여 있다. 검증셋이 유한하고, 학습 자체도 시드에 따라 흔들린다. 최고점을 받은 후보는 “실력이 좋은 후보”이면서 동시에 “운이 좋았던 후보”다. 그래서 승자의 검증 점수는 그 후보의 진짜 실력보다 높다. 승자의 저주라 부른다.
| 기호 | 뜻 |
|---|---|
| 검증셋 | 하이퍼파라미터를 고르는 데 쓰는 데이터. 학습에는 쓰지 않는다 |
| 시험셋 | 고르는 데도 쓰지 않고 마지막에 한 번만 보는 데이터. 진짜 실력의 추정치다 |
| 부풀림 | 승자의 검증 점수 − 승자의 시험 점수 |
우연의 크기가 클수록(검증셋이 작을수록), 견준 후보가 많을수록 부풀림은 커진다. 검증셋과 시험셋을 따로 두는 이유가 이것이다.
2. 직접 재 보기
모델은 16×16 도형 12종을 가르는 은닉층 128의 MLP 다. SGD(모멘텀 0.9)로 8에폭만 학습한다. 고를 값은 학습률( ~ 3)과 가중치 감쇠( ~ ) 둘이고, 둘 다 로그 축에서 고르게 뽑는다. 학습 3,600장, 검증 2,400장, 시험 12,000장이다.
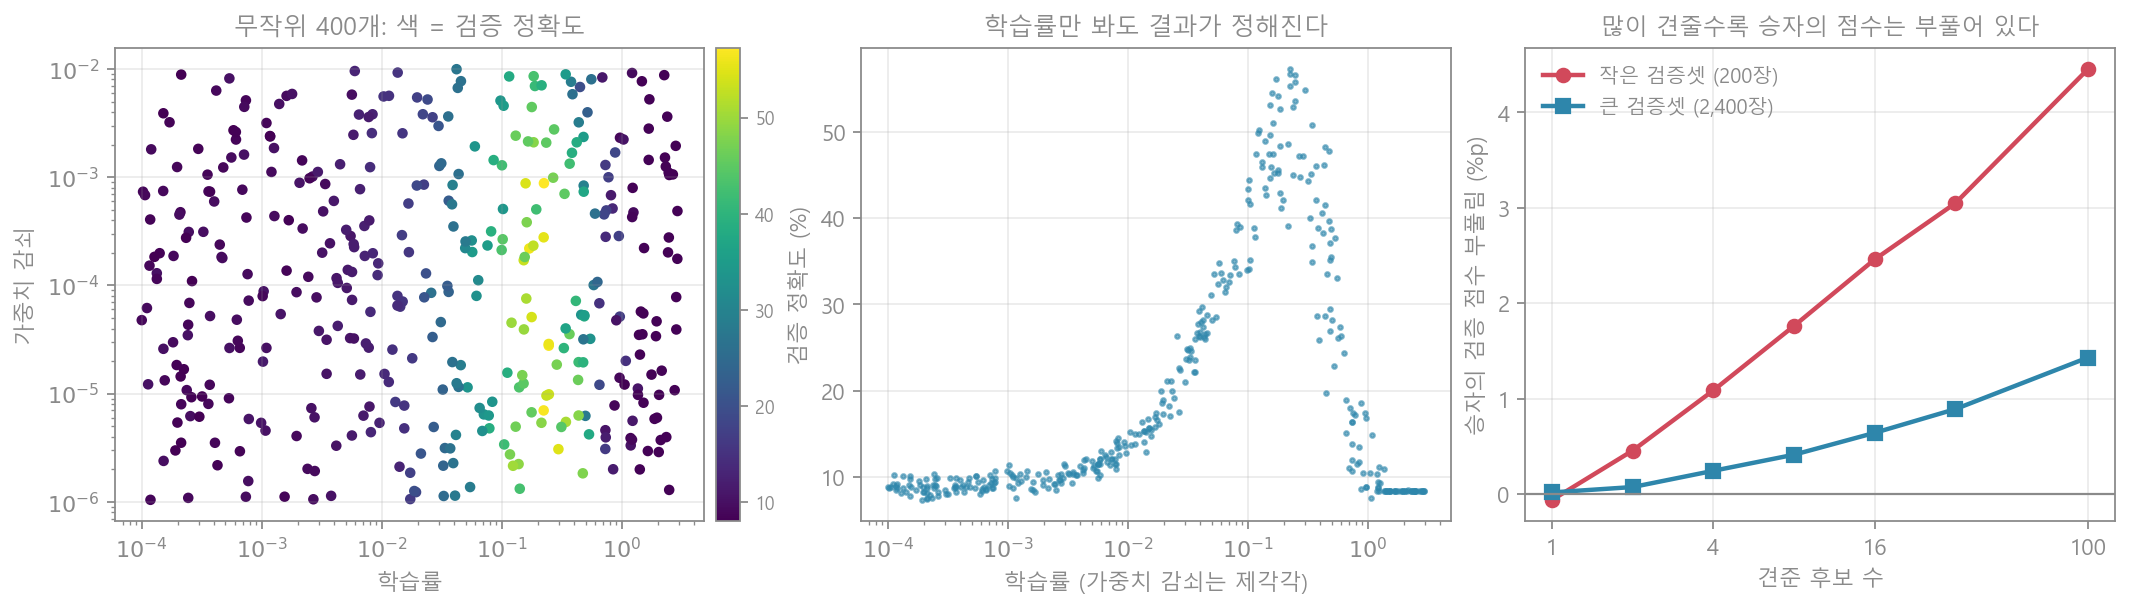
[A] 무엇이 결과를 정하나
무작위 설정 400개를 학습했다.
| 관찰 | 값 |
|---|---|
| 검증 정확도: 최고 / 중앙값 / 최저 | 57.3% / 11.7% / 7.3% (찍기 8.3%) |
| 분산 중 학습률이 설명하는 몫 | 86.3% |
| 분산 중 가중치 감쇠가 설명하는 몫 | 0.8% |
| 최고에서 2%p 안에 든 설정 | 400개 중 6개 (1.5%) |
| 그 6개의 학습률 범위 | 0.170 ~ 0.247 (탐색 범위 로그 폭의 4%) |
| 그 6개의 가중치 감쇠 범위 | ~ (거의 아무 데나) |
- 절반이 넘는 설정이 찍기 수준이다. 중앙값이 11.7% 다. 탐색 범위를 넓게 잡으면 대부분의 설정은 쓸모가 없다.
- 결과를 정하는 것은 학습률 하나다. 학습률을 8구간으로 나눈 평균 정확도는 9%, 9%, 11%, 16%, 31%, 48%, 24%, 9% 로 크게 움직인다. 가중치 감쇠를 8구간으로 나누면 18~22% 로 평평하다. 왼쪽 그림에서 색이 세로 띠로만 바뀌는 것이 이것이다.
- 잘 되는 학습률 구간은 좁다. 로그 폭의 4% 다.
[B] 격자 16번 대 무작위 16번
4×4 격자는 위치를 조금씩 옮겨 12번 돌렸다(격자 하나만 보면 운이 섞인다). 무작위 16개는 위 400개에서 16개를 뽑는 일을 2,000번 했다.
| 방법 | 찾은 최고 검증 정확도 (평균) | 범위 | 최고에서 2%p 안까지 간 비율 |
|---|---|---|---|
| 4×4 격자 | 41.7% | 30.0 ~ 54.8 | 12번 중 0번 |
| 무작위 16개 | 49.4% | 하위 5% 37.2, 상위 5% 56.8 | 22% |
같은 16번인데 무작위가 평균 7.7%p 높다. 격자가 시험한 학습률은 4가지, 무작위는 16가지다. 1절의 식으로도 맞는다. 일 때 16번 중 한 번이라도 걸릴 확률은 이고, 실측은 22% 였다.
예산을 바꾸면 이렇다.
| 무작위로 뽑는 수 | 찾은 최고 (평균) | 운이 나쁜 5% 의 경우 |
|---|---|---|
| 4 | 35.7% | 11.4% |
| 9 | 44.5% | 25.9% |
| 16 | 49.1% | 35.5% |
| 25 | 51.8% | 43.5% |
| 64 | 55.2% | 50.2% |
4번만 뽑으면 스무 번에 한 번은 찍기 수준(11.4%)에서 끝난다. 탐색에서 무서운 것은 평균이 아니라 운이 나쁜 경우다. 횟수가 늘면 평균보다 바닥이 훨씬 빨리 올라온다.
[C] 승자의 저주
[A]에서 400개 중 최고였던 설정(학습률 0.225, 가중치 감쇠 )을 시드만 바꿔 100번 다시 학습했다.
| 관찰 | 값 |
|---|---|
| 400개 중 뽑혔을 때의 검증 정확도 | 57.3% |
| 같은 설정 100번의 시험 정확도 평균 | 49.25% |
| 표준편차 | 4.90%p (최저 33.9% ~ 최고 57.3%) |
최고점 57.3% 는 그 설정의 실력이 아니었다. 같은 설정의 평균은 49.3% 다. 400개 중 1등이 된 것은 좋은 학습률을 골랐기 때문이기도 하고, 그 가운데서도 시드 운이 가장 좋았기 때문이기도 하다. 8%p 가 운이었다. 이 실험에서 나는 “같은 설정이면 결과가 거의 같을 것”이라고 예상했는데 틀렸다. 8에폭만 학습한 탓에 시드에 따라 33.9% 에서 57.3% 까지 벌어졌다.
이제 이 100개를 후보로 놓고, 검증 점수로 최고를 고를 때 그 점수가 얼마나 부풀어 있는지 쟀다(4,000번 반복, 검증셋 자체가 쉽거나 어려운 정도는 뺐다).
| 견준 후보 수 | 부풀림: 작은 검증셋 (200장) | 부풀림: 큰 검증셋 (2,400장) |
|---|---|---|
| 1 | −0.06%p | +0.02%p |
| 4 | +1.09%p | +0.25%p |
| 16 | +2.46%p | +0.64%p |
| 32 | +3.05%p | +0.89%p |
| 100 | +4.45%p | +1.43%p |
- 후보가 하나면 부풀림이 없다. 고르지 않았으니 운이 끼어들 틈이 없다.
- 견준 후보가 많을수록 부풀림이 커진다. 100개 중 승자의 검증 점수는 작은 검증셋에서 4.45%p 부풀어 있었다.
- 검증셋이 크면 줄어든다. 2,400장이면 1.43%p 다. 검증 정확도 하나의 표준오차가 200장에서 3.54%p, 2,400장에서 1.02%p 인 것과 같은 비율이다(표본 오차 노트).
- 고르는 것이 헛일은 아니었다. 100개 중 승자의 실제 시험 정확도는 작은 검증셋으로 골라도 56.35% 로, 아무거나 집었을 때(49.30%)보다 높았다. 검증 점수는 실력을 알려 주기는 하되 과장한다.
3. 흔한 오해와 한계
“격자가 더 체계적이니 더 낫다.” 중요한 값이 일부일 때는 반대다. 격자는 중요하지 않은 축에 예산의 대부분을 쓴다. 그리고 무엇이 중요한지는 해 보기 전에는 모른다. [A]에서 가중치 감쇠는 분산의 0.8% 였다.
“무작위는 운에 맡기는 것이다.” 운에 맡기되 그 운을 계산할 수 있다. 이 그 계산이고 실측과 맞았다(21% 와 22%).
“검증 정확도가 가장 높은 모델이 가장 좋은 모델이다.” 가장 좋을 가능성이 높은 모델이다. 그 점수 자체는 [C]에서 최대 4.45%p 부풀어 있었다. 보고할 숫자는 시험셋에서 따로 재야 한다.
“좋은 하이퍼파라미터를 찾았다.” [C]의 57.3% 는 시드 하나의 결과였다. 설정이 좋은지 확인하려면 그 설정을 시드를 바꿔 몇 번 더 돌려 봐야 한다.
실험의 한계. 하이퍼파라미터가 둘뿐이고 하나가 거의 무의미한 경우다. 격자에게 불리한 조건이다. 두 값이 모두 중요하고 서로 얽혀 있으면 차이는 줄어든다. 8에폭만 학습해서 시드 흔들림이 유난히 크다. 충분히 학습하면 [C]의 표준편차 4.90%p 는 훨씬 작아진다. 앞선 결과를 보고 다음 후보를 고르는 방법(베이즈 최적화, 일찍 버리기)은 재지 않았다. 무작위 탐색은 그 방법들의 기준선이다.
4. 한 문단 요약
하이퍼파라미터 탐색에서 격자는 축마다 몇 개의 값만 시험한다. 결과를 정하는 값이 일부일 때 이것은 큰 손해다. 무작위 설정 400개를 학습하자 검증 정확도 분산의 86.3% 를 학습률이, 0.8% 를 가중치 감쇠가 설명했고, 잘 되는 설정은 1.5% 뿐이었다. 같은 16번의 예산으로 4×4 격자는 평균 41.7%, 무작위는 49.4% 를 찾았다. 무작위로 번 뽑아 좋은 설정이 한 번이라도 걸릴 확률은 이고 실측과 맞았다. 고른 뒤에도 조심할 것이 있다. 400개 중 최고였던 57.3% 는 같은 설정을 시드만 바꿔 다시 돌리자 평균 49.3% 였다. 실력이 비슷한 후보 100개 중 검증 점수로 고른 승자의 점수는 검증셋 200장에서 4.45%p, 2,400장에서 1.43%p 부풀어 있었다. 많이 견줄수록, 검증셋이 작을수록 승자의 점수는 덜 믿을 만하다.
참고
- Bergstra, Bengio — Random Search for Hyper-Parameter Optimization (2012)
- Li 외 — Hyperband: A Novel Bandit-Based Approach to Hyperparameter Optimization (2018)
- Cawley, Talbot — On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation (2010)
- Bouthillier 외 — Accounting for Variance in Machine Learning Benchmarks (2021)
- 연재: 최적화 편 · 과적합과 규제 편 · 표본 오차 노트