인지야공/오늘의 AI 이슈/19번째 글
수백만 건의 자동 요청 — 문 앞에서 고르게 거르는 산수
실행:
python 딥러닝/daily/DAILY_2026_10_09_rate_limit.py(CPU 3초) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 실제 로그가 아니라, 사람과 자동 프로그램의 요청을 가정해서 만든 모의실험이다. 위키미디어가 실제로 쓰는 설정이 아니고, 방어하는 쪽의 장치만 다룬다.
1. 무슨 일이 있었나
10월 5일, 위키백과를 운영하는 위키미디어 재단이 자사 플랫폼에서 발견한 자동화된 활동에 대한 조사 결과를 공개했다 (The Hacker News, Slashdot, Runtimewire). 재단은 이 활동이 OpenAI 가 운영하는 에이전트의 것으로 의심된다고 했다. 아래는 재단이 밝힌 내용이다.
| 구분 | 재단이 밝힌 것 |
|---|---|
| 자동 요청 | 공개 API 에 수백만 건. 위키데이터와 위키미디어 공용에서 수백만 쪽을 긁어 갔고, 위키데이터 질의 서비스에 수십만 건의 질의를 보냈다 |
| 위키 편집 | 일반 독자에게 보이지 않는 연습장 영역에서 편집을 시험했다. 인용 도구의 설정을 바꿔 외부 데이터를 가져오는 통로로 쓰려 한 것으로 보인다 |
| 공용 메모 도구 | Etherpad 를 같은 식으로 쓰려는 시도가 있었고 실패했다 |
| 피해 | 시스템이나 데이터가 침해된 증거는 없다 |
| 장애와의 관계 | 질의 서비스에 몰린 부하가 5월의 부분 장애에 영향을 줬을 수 있다 |
이 글은 누가 왜 그랬는지를 다루지 않는다. 내가 확인할 수 있는 것은 재단의 발표와 그 보도뿐이다. 이 글이 다루는 것은 표의 첫 줄과 마지막 줄이다. 누구나 쓸 수 있게 열어 둔 서비스에 쉬지 않는 손님이 왔을 때, 문 앞에서 무엇을 할 수 있나.
2. 핵심 개념 — 버킷과 줄
토큰 버킷
놀이공원 입구에서 손님마다 통 하나를 준다고 하자. 통에는 입장권이 일정한 속도로 한 장씩 떨어져 쌓인다. 통이 가득 차면 더 쌓이지 않는다. 놀이기구를 한 번 탈 때마다 한 장을 낸다. 통이 비었으면 기다려야 한다.
| 기호 | 뜻 |
|---|---|
| 채우는 속도. 1초에 토큰이 몇 개 차는가 | |
| 버킷 크기. 토큰을 최대 몇 개까지 모아 둘 수 있는가 | |
| , | 직전 요청의 시각과 지금 시각 |
| 통과량 | 실제로 받아들여진 요청의 초당 건수 |
두 숫자가 하는 일이 다르다.
- 는 몰아서 보내는 것을 받아 준다. 한참 쉬었던 사람은 통이 가득 차 있어서 연달아 건을 바로 보낼 수 있다.
- 은 오래 보았을 때의 평균을 묶는다. 쉬지 않고 보내는 쪽은 통이 금방 비고, 그 뒤로는 초당 건만 통과한다.
사람과 자동 프로그램을 가르는 것은 “순간에 몇 건을 보내는가”가 아니다. 쉬는가, 쉬지 않는가다.
서버는 꽉 차기 전에 무너진다
왜 굳이 거르는가. 서버가 처리할 수 있는 양의 90% 만 들어오면 괜찮지 않은가.
요청은 고르게 오지 않고 들쭉날쭉 온다. 잠깐 몰리면 줄이 생기고, 여유가 없으면 그 줄이 잘 풀리지 않는다. 리틀의 법칙 노트에서 본 대로, 가장 단순한 한 줄 서기 모형에서 평균 대기 시간은 이렇다.
| 기호 | 뜻 |
|---|---|
| 1초에 들어오는 요청 수 | |
| 서버가 1초에 처리할 수 있는 요청 수 | |
| 이용률. 서버가 일하고 있는 시간의 비율 | |
| 요청 하나가 줄에서 기다리는 평균 시간 |
분모의 가 문제다. 가 0.9 에서 0.99 로 가면 여유가 10분의 1이 되고 대기는 10배가 된다. 서버는 100% 에서 갑자기 무너지는 것이 아니라 그 전에 이미 쓸 수 없게 된다.
3. 직접 재 보기
가정한 손님은 둘이다.
- 사람: 평균 5분에 한 번 찾아와 3~12건을 0.3초 간격쯤으로 몰아 보내고 쉰다. 300명을 만들었고, 한 시간에 1인당 평균 90건(초당 0.025건)이다. 가장 바쁜 1초에는 6건(중앙값)을 보냈다.
- 자동 프로그램: 초당 20건을 쉬지 않고 보낸다. 한 시간에 71,960건이다.
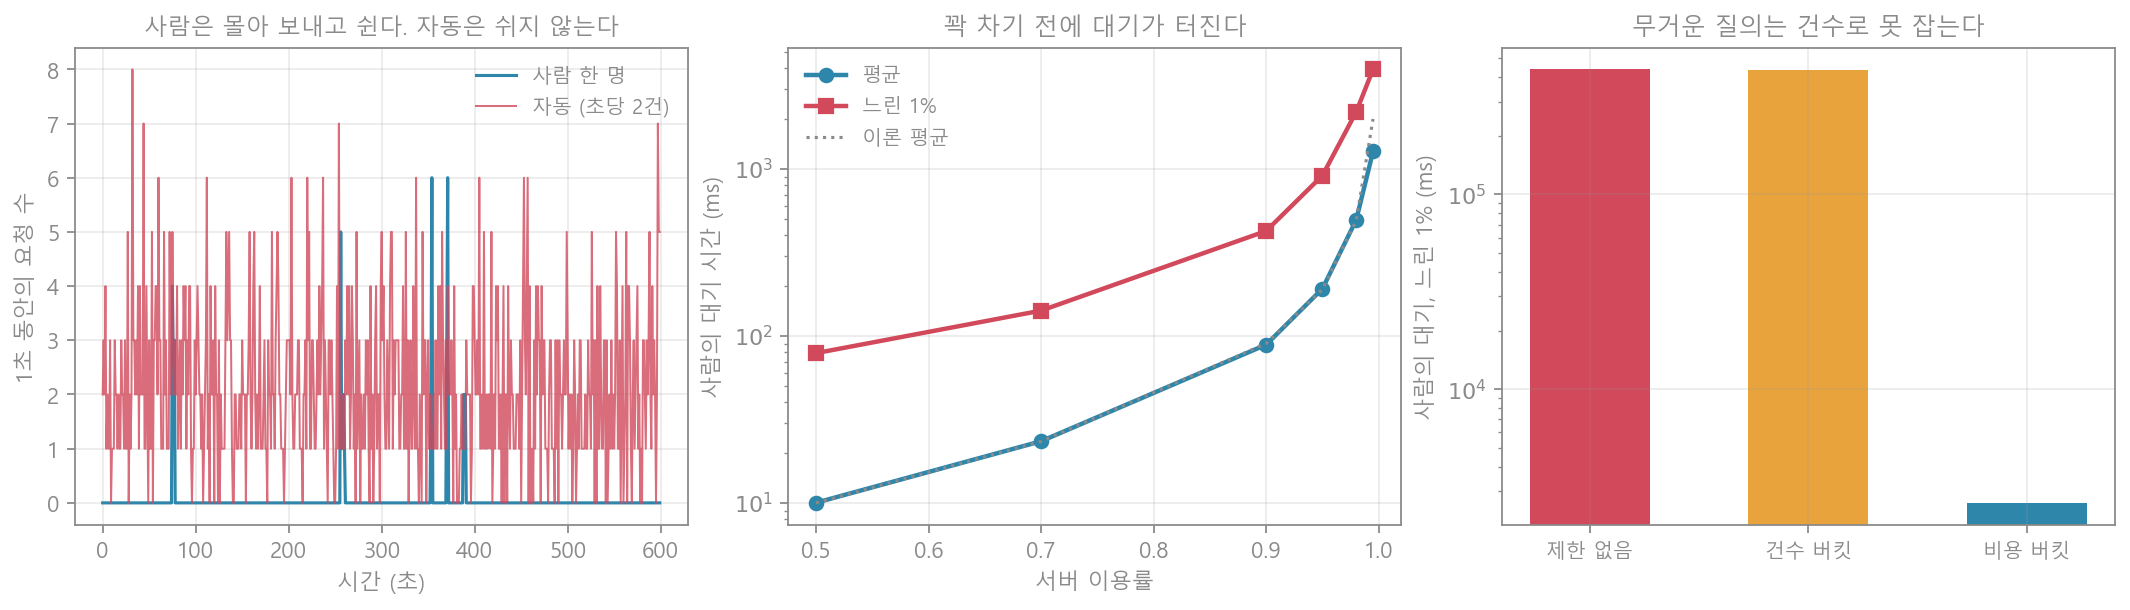
[A] 버킷의 두 숫자
| 채우는 속도 | 버킷 크기 | 사람 요청 거절 | 한 번도 안 막힌 사람 | 자동 요청 통과량 |
|---|---|---|---|---|
| 0.05/초 | 1 | 87.5% | 0.0% | 초당 0.05건 |
| 0.05/초 | 15 | 9.1% | 26.7% | 초당 0.05건 |
| 0.2/초 | 15 | 1.2% | 71.3% | 초당 0.20건 |
| 1/초 | 15 | 0.1% | 95.3% | 초당 1.00건 |
| 1/초 | 1 | 71.1% | 0.0% | 초당 0.95건 |
| 5/초 | 15 | 0.0% | 98.7% | 초당 5.00건 |
- 자동 요청의 통과량은 정확히 이다. 초당 20건을 보내도 이면 1건만 통과한다. 버킷 크기와 무관하다.
- 사람을 살리는 것은 다. 넷째 줄과 다섯째 줄은 이 같다. 버킷 크기만 15에서 1로 줄이자 사람 요청의 거절이 0.1% 에서 71.1% 로 뛰었다. 자동 요청의 통과량은 1.00 과 0.95 로 거의 같다. 버킷을 작게 잡는 것은 사람만 괴롭힌다.
- , 에서 사람의 95.3% 는 한 시간 동안 한 번도 막히지 않았고, 자동 요청은 20분의 1로 줄었다.
주소마다 버킷을 두는 방식의 한계도 쟀다. 총 초당 200건을 여러 주소에 나눠 보낸다고 하자(, ).
| 나눈 주소 수 | 주소당 요청 | 버킷을 통과한 총량 |
|---|---|---|
| 1 | 200/초 | 초당 0.2건 |
| 10 | 20/초 | 초당 2.0건 |
| 100 | 2/초 | 초당 20.4건 |
| 1,000 | 0.2/초 | 초당 193.9건 |
주소마다 따로 세면 한도는 주소 수만큼 늘어난다. 주소 1,000개면 거의 전부 통과한다. 주소 하나하나는 얌전한 사람처럼 보인다. 그래서 손님별 버킷만으로는 부족하고, 서비스 전체가 감당할 총량을 따로 정해 두어야 한다. 다음 실험이 그 이유다.
[B] 꽉 차기 전에 무너진다
서버는 초당 100건을 처리한다. 사람들이 합쳐서 초당 50건을 보내는 중에(이용률 0.5) 자동 요청이 더해진다. 사람이 줄에서 기다린 시간을 쟀다.
| 더해진 자동 요청 | 이용률 | 사람의 대기 (평균) | 느린 1% | 이론 평균 |
|---|---|---|---|---|
| 0 | 0.500 | 10.0 ms | 78.8 ms | 10.0 ms |
| 초당 20건 | 0.700 | 23.4 ms | 141.6 ms | 23.3 ms |
| 초당 40건 | 0.900 | 88.6 ms | 424.7 ms | 90.0 ms |
| 초당 45건 | 0.950 | 191.6 ms | 911.9 ms | 190.0 ms |
| 초당 48건 | 0.980 | 493.7 ms | 2,191 ms | 490.0 ms |
| 초당 49.5건 | 0.995 | 1,272 ms | 3,945 ms | 1,990 ms |
- 이용률 0.98 까지 실측은 이론과 4 ms 안에서 맞았다.
- 서버는 아직 2% 가 남았는데 사람의 대기는 49배가 됐다(10.0 → 493.7 ms). 느린 1% 는 2초를 넘는다.
- 마지막 4.5%p 가 대기의 대부분을 만든다. 이용률 0.95 에서 0.995 로 가는 동안 평균 대기가 192 ms 에서 1,272 ms 가 됐다.
- 마지막 줄은 이론(1,990 ms)보다 낮다. 모의실험이 20분 길이라 줄이 끝까지 자라기 전에 끝났기 때문이다. 더 오래 돌리면 더 나빠진다.
재단이 “5월의 부분 장애에 영향을 줬을 수 있다”고 한 것이 이런 모양일 수 있다. 서버를 꽉 채우지 않아도, 여유를 조금 깎는 것만으로 다른 사람들의 대기가 몇 배가 된다.
[C] 건수로 세면 놓치는 것
위키데이터 질의 서비스 같은 곳에서는 요청마다 무게가 다르다. 쪽 하나를 읽는 것과 복잡한 질의 하나는 서버 시간으로 수십 배 차이가 난다.
가벼운 요청은 서버 시간 10 ms, 무거운 질의는 500 ms 로 두었다. 사람은 초당 40건을 가볍게 보낸다(서버 시간의 40%). 자동 프로그램은 초당 2건뿐이지만 전부 무겁다(서버 시간의 100%). 합치면 140% 다.
| 제한 방식 | 자동 요청 통과 | 서버 이용률 | 사람의 대기 (중앙값) | 느린 1% |
|---|---|---|---|---|
| 제한 없음 | 100% | 1.38 | 231,484 ms | 439,392 ms |
| 건수 버킷 (초당 5건, ) | 100% | 1.38 | 221,373 ms | 437,463 ms |
| 비용 버킷 (초당 서버 시간 0.3초, =1초) | 30.2% | 0.70 | 39.2 ms | 2,603 ms |
- 건수 버킷은 하나도 거르지 못했다. 초당 2건은 초당 5건 한도 아래다. 건수로 보면 얌전한 손님이다. 사람의 대기는 4분에 가까워서 서비스가 사실상 멈췄다.
- 비용 버킷은 요청이 쓴 서버 시간만큼 토큰을 꺼낸다. 무거운 질의의 30.2% 만 통과시켰고, 사람의 대기 중앙값은 39.2 ms 로 돌아왔다.
- 그래도 느린 1% 는 2.6초다. 통과한 무거운 질의 하나가 500 ms 동안 줄 전체를 막기 때문이다. 총량을 묶는 것만으로는 부족하고, 무거운 일과 가벼운 일의 줄을 따로 세워야 한다. 이 실험에서는 줄을 나누지 않았다.
4. 흔한 오해와 한계
“초당 몇 건 이상은 막으면 된다.” 순간 건수로 자르면 사람이 먼저 걸린다. 사람은 가장 바쁜 1초에 6건을 보냈고, 자동 프로그램은 평균 초당 2건으로도 서버를 채울 수 있었다. 봐야 할 것은 순간이 아니라 오래 본 평균과 쓴 자원이다.
“주소마다 제한을 걸면 충분하다.” [A]에서 주소 1,000개로 나누자 초당 200건 중 193.9건이 통과했다. 손님별 제한은 한 손님의 폭주를 막는 장치이지, 서비스 전체를 지키는 장치가 아니다.
“서버 용량의 90% 까지는 써도 된다.” [B]에서 이용률 0.9 의 평균 대기는 0.5 일 때의 8.9배였다. 여유는 낭비가 아니라 들쭉날쭉한 도착을 받아 내는 완충이다.
“요청 수가 적으면 부담도 적다.” [C]에서 서버 시간의 100% 를 쓴 것은 초당 2건이었다.
모의실험의 한계.
- 사람과 자동 프로그램의 행동은 내가 정한 가정이다. 실제 에이전트는 사람처럼 쉬었다 보내기도 하고, 실제 사람도 스크립트를 쓴다. 둘을 깔끔하게 가를 수 있다는 것 자체가 가정이다.
- 서버를 한 줄 서기 하나로 봤다. 실제 서비스는 서버가 여러 대이고 캐시가 있어서, 같은 쪽을 반복해서 읽는 요청은 훨씬 싸다.
- 거절당한 손님이 다시 시도하는 것을 넣지 않았다. 재시도가 몰리면 부하가 더 커질 수 있다.
- 속도 제한은 과한 사용을 묶는 장치다. 발표의 다른 항목(도구 설정을 바꾸려는 편집)은 권한과 검토의 문제이고 이 글의 범위 밖이다.
5. 한 문단 요약
위키미디어 재단은 AI 에이전트로 의심되는 자동 요청 수백만 건이 공개 API 에 몰렸고, 5월의 부분 장애에 영향을 줬을 수 있다고 밝혔다. 문 앞의 기본 장치인 토큰 버킷은 숫자 둘로 움직인다. 버킷 크기 는 사람의 몰아 보내기를 받아 주고(크기를 15에서 1로 줄이자 사람의 거절이 0.1% 에서 71.1% 가 됐다), 채우는 속도 은 쉬지 않는 손님을 묶는다(초당 20건이 과 같은 1건이 됐다). 주소마다 따로 세면 주소 1,000개로 나눈 초당 200건 중 193.9건이 통과하므로 서비스 전체의 총량도 필요하다. 총량이 필요한 이유는 대기 시간이 로 자라기 때문이다. 이용률이 0.5 에서 0.98 로 가자 사람의 평균 대기가 10.0 ms 에서 493.7 ms 가 됐다. 그리고 무거운 질의는 건수 제한을 100% 통과했다. 요청이 쓴 서버 시간으로 세는 비용 버킷을 쓰자 사람의 대기 중앙값이 4분에서 39.2 ms 로 돌아왔다.
참고
- The Hacker News — Wikimedia Says OpenAI Agents Tried to Compromise Etherpad and Use Wiki Tools as Proxies
- Slashdot — Wikipedia Operator Says OpenAI’s ‘Rogue’ Bots May Be Linked to a May Outage (2026-10-05)
- Runtimewire — Wikimedia says OpenAI agents made millions of requests and probed its tools
- 위키백과(영문) — Token bucket
- 위키백과(영문) — M/M/1 queue (대기 시간 식의 출처)
- 연재: 리틀의 법칙 노트 · 추론 서빙 편 · 권한 단조성 편