인지야공/딥러닝 기초 정리/31번째 글
자기지도 학습 — 라벨 없이 먼저 배우기
실행:
python NN_62_self_supervised.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 4분) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다.
전이 학습과 파국적 망각 편에서는 라벨이 붙은 다른 과제로 몸통을 먼저 학습했다. 그런데 라벨은 비싸다. 사람이 하나하나 붙여야 한다. 라벨 없는 데이터는 거의 공짜로 얼마든지 있다. 지금의 큰 모델들은 전부 이 라벨 없는 데이터로 먼저 배운다.
라벨이 없는데 무엇을 맞히게 하나. 데이터 자신에게서 문제를 만든다. 이것이 자기지도 학습이다. 이 편은 세 가지를 잰다.
- 라벨 없이 먼저 배우면, 라벨이 적을 때 얼마나 이득인가
- 문제를 만드는 두 방식(가려 놓고 맞히기, 같은 그림 알아보기)은 같은 것을 배우나
- 문제를 어떻게 만드느냐가 배우는 내용을 어떻게 바꾸나
1. 데이터가 스스로 내는 문제
방식 하나 — 가려 놓고 맞히기
그림의 일부를 가리고, 가린 부분을 채우게 한다. 정답은 원래 그림에 있으니 라벨이 필요 없다. 문장에서 단어를 가리고 맞히게 하는 것, 다음 단어를 맞히게 하는 것도 같은 생각이다.
| 기호 | 뜻 |
|---|---|
| 원래 그림의 번째 화소 | |
| 모델이 채워 넣은 값 | |
| 가린 화소들의 집합. 가린 자리만 채점한다 |
방식 둘 — 같은 그림 알아보기 (대조 학습)
그림 한 장을 두 가지로 살짝 바꾼다(옮기고, 잡음을 넣고). 이 둘은 같은 그림에서 나왔다는 것을 맞히게 한다. 묶음 안의 다른 그림들은 모두 “다른 그림”이다. 같은 것끼리는 특징을 가깝게, 다른 것끼리는 멀게 만든다.
| 기호 | 뜻 |
|---|---|
| , | 같은 그림의 두 변형에서 뽑은 특징 벡터 (길이를 1로 맞춘다) |
| 묶음 안의 다른 모든 특징 | |
| 두 특징이 얼마나 비슷한가 (내적) | |
| 온도. 작을수록 차이를 날카롭게 본다. 이 실험은 0.2 |
이 식은 소프트맥스와 교차 엔트로피 편의 분류 손실 그대로다. 클래스가 “묶음 안의 어느 그림이 내 짝인가”일 뿐이다. word2vec 편의 “진짜 쌍과 가짜 쌍 가르기”와도 같은 뼈대다.
머리만 학습해서 재는 법
사전학습한 몸통이 쓸 만한지 재는 표준 방법이 선형 프로브다. 몸통을 얼리고, 그 위에 선형층 하나(머리)만 라벨로 학습한다. 머리가 단순할수록, 정확도가 높다는 것은 몸통이 이미 클래스를 곧은 선으로 가를 수 있게 정리해 놓았다는 뜻이다.
| 용어 | 뜻 |
|---|---|
| 몸통 | 입력에서 특징을 뽑는 층들. 여기서는 합성곱 2층과 완전연결 1층, 출력 64차원 |
| 머리 | 특징을 받아 클래스 점수를 내는 선형층 하나 |
| 선형 프로브 | 몸통을 얼리고 머리만 학습해 잰 정확도 |
| 미세조정 | 몸통까지 함께 학습하는 것 |
| 증강 | 그림을 뜻이 바뀌지 않게 살짝 바꾸는 것(옮기기, 잡음, 회전 등) |
2. 직접 재 보기
데이터는 16×16 도형 12종이다. 도형 4계열(원, 사각형, 마름모, 십자)마다 세 변형(전체 밝음, 오른쪽이 어두움, 아래가 어두움)이 있다. 라벨을 버린 그림 6,000장으로 몸통을 사전학습하고, 라벨이 붙은 그림 몇 장으로 머리를 학습한 뒤 시험 3,600장으로 잰다(시드 3개 평균).
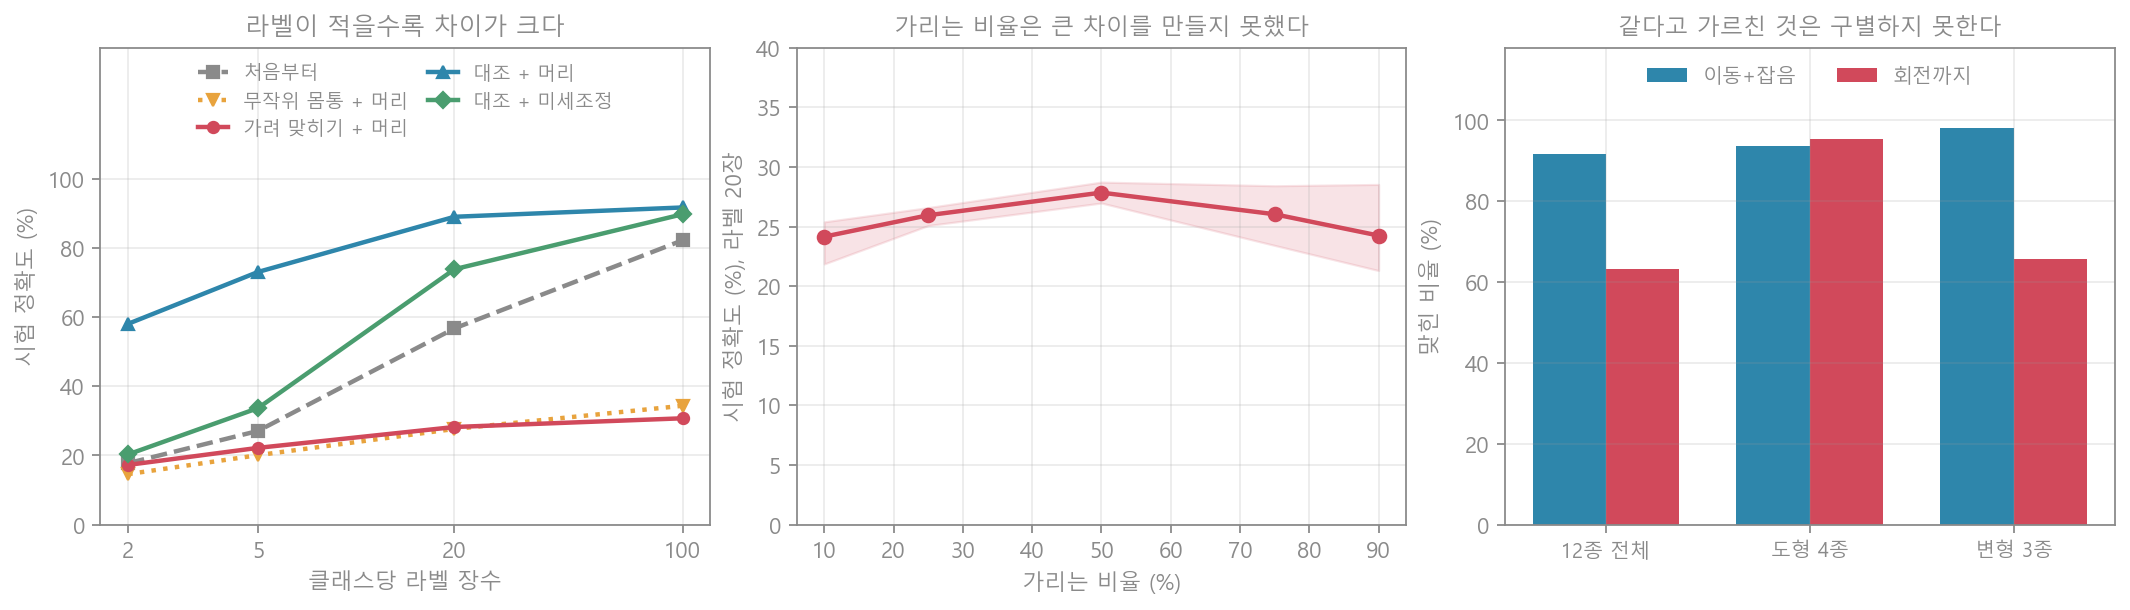
[A] 라벨이 적을 때
| 클래스당 라벨 | 처음부터 | 머리만: 무작위 몸통 | 머리만: 가려 맞히기 | 머리만: 대조 | 미세조정: 대조 |
|---|---|---|---|---|---|
| 2장 | 17.8% | 14.6% | 17.3% | 58.1% | 20.3% |
| 5장 | 27.1% | 20.1% | 22.2% | 73.1% | 33.7% |
| 20장 | 56.8% | 27.7% | 28.2% | 89.1% | 73.9% |
| 100장 | 82.3% | 34.4% | 30.8% | 91.8% | 89.8% |
- 대조 학습으로 배운 몸통은 라벨 24장(클래스당 2장)으로 58.1% 를 맞혔다. 처음부터 배우면 17.8% 다. 찍기가 8.3% 이니, 처음부터 배운 쪽은 거의 못 배운 것이다.
- 라벨 240장(클래스당 20장)이면 89.1% 다. 처음부터 배운 모델은 라벨을 1,200장 써도 82.3% 였다. 라벨 5분의 1로 더 높은 정확도다.
- 차이는 라벨이 늘수록 줄어든다(2장에서 40.3%p, 100장에서 9.5%p).
- 미세조정은 라벨이 적을 때 오히려 손해다. 클래스당 2장에서 머리만 학습하면 58.1%, 몸통까지 고치면 20.3% 다. 좋은 특징을 24장으로 망가뜨린 것이다. 전이 학습 편에서 본 “데이터가 아주 적으면 몸통을 얼려라”와 같은 결과다.
가려 놓고 맞히기는 예상과 달랐다. 무작위 몸통과 차이가 없었다(2장에서 17.3% 대 14.6%, 100장에서는 30.8% 대 34.4% 로 오히려 낮다). 사전학습은 잘 됐다. 가린 자리의 복원 오차는 0.0512 로, 그림에 넣은 잡음의 분산(0.0625)보다 작다. 복원은 할 줄 아는데 그 특징이 분류에는 쓸모가 없었다. 특징 64차원 중 늘 같은 값만 내는 죽은 차원이 무작위 몸통은 8개, 가려 맞히기는 33개였다(대조는 28개). 가린 화소를 채우는 데는 “어디에 얼마만 한 덩어리가 있나”면 충분하고, 그것은 “어떤 도형인가”와 다른 정보다. 미세조정을 해도 처음부터 배운 것과 비슷했다(클래스당 20장에서 57.3% 대 56.8%).
[B] 얼마나 가려야 하나
가리는 비율을 바꿔 봤다(클래스당 라벨 20장, 머리만 학습).
| 가리는 비율 | 시험 정확도 | 시드 3개 범위 | 가린 자리 복원 오차 |
|---|---|---|---|
| 10% | 24.1% | 21.9~25.4 | 0.0473 |
| 25% | 25.9% | 25.1~26.6 | 0.0480 |
| 50% | 27.8% | 27.0~28.7 | 0.0513 |
| 75% | 26.0% | 23.4~28.4 | 0.0607 |
| 90% | 24.2% | 21.3~28.5 | 0.0710 |
50% 에서 가장 높지만 차이는 3.7%p 이고, 어느 비율도 무작위 몸통(27.7%)을 뚜렷이 넘지 못했다. 가리는 비율은 이 실험에서 답이 아니었다. 큰 그림 모델에서 “75% 를 가려야 잘 배운다”고 알려진 것과 다르다. 그 결과는 자연 사진과 훨씬 큰 모델에서 나온 것이다. 여기 그림은 16×16 이고 잡음이 커서, 가린 화소를 맞히는 문제가 “덩어리의 위치와 크기”만으로 거의 풀린다.
[C] 무엇을 같다고 가르쳤나
대조 학습은 “두 변형은 같은 그림”이라고 가르친다. 그러면 모델은 변형이 바꾸는 것을 무시하도록 배운다. 변형에 90도 회전을 넣어 봤다. 이 데이터에서 회전은 무해하지 않다. “오른쪽이 어둡다”를 90도 돌리면 “아래가 어둡다”가 된다.
| 대조 학습에 쓴 변형 | 12종 정확도 | 도형 4종 맞힘 | 변형 3종 맞힘 | 오른쪽/아래 어두움을 서로 헷갈림 |
|---|---|---|---|---|
| 이동 + 잡음 | 91.8% | 93.6% | 98.1% | 0.7% |
| 이동 + 잡음 + 회전 | 63.1% | 95.5% | 65.7% | 42.0% |
(클래스당 라벨 100장, 머리만 학습)
- 회전을 넣자 12종 정확도가 28.7%p 떨어졌다.
- 떨어진 곳은 정확히 한 군데다. 도형 종류는 여전히 95.5% 맞히는데, “오른쪽이 어둡다”와 “아래가 어둡다”를 42.0% 헷갈린다. 동전 던지기(50%)에 가깝다.
- 모델이 못 배운 것이 아니라 배운 대로 한 것이다. 돌려도 같은 그림이라고 가르쳤으니, 돌리면 달라지는 정보를 버렸다.
자기지도 학습에는 라벨이 없지만 사람의 판단이 빠진 것은 아니다. 무엇을 같다고 볼지를 정하는 변형의 선택이 그 판단이다. 사진에서 좌우 뒤집기는 대개 괜찮지만, 글자를 읽는 과제에서는 ‘b’ 와 ‘d’ 를 같게 만든다.
3. 흔한 오해와 한계
“자기지도 학습은 사람의 지식 없이 배운다.” 라벨은 없지만 문제를 사람이 설계한다. [C]에서 변형 하나를 더 넣었더니 특정 구별이 사라졌다.
“복원을 잘하면 좋은 특징이다.” [A]에서 가려 맞히기는 복원 오차가 잡음 수준까지 내려갔지만 분류에는 무작위 몸통만큼이었다. 사전 과제를 잘 푸는 것과 뒤의 과제에 쓸모 있는 것은 다른 일이다.
“가려 맞히기는 대조 학습보다 못하다.” 이 실험에서만 그렇다. 언어 모델과 큰 그림 모델은 가려 맞히기(또는 다음 것 맞히기)로 잘 배운다. 문장에서 가린 단어를 맞히려면 뜻을 알아야 하지만, 잡음 많은 16×16 그림에서 가린 화소를 맞히는 데는 덩어리의 위치면 족하다. 가린 것을 맞히기 위해 무엇을 알아야 하는가가 배우는 내용을 정한다.
“사전학습했으면 미세조정해야 한다.” 클래스당 라벨 2장에서 미세조정은 37.8%p 손해였다.
측정에서 주의한 것. 처음에는 머리 학습에서 특징을 표준화하지 않았다. 그랬더니 대조 학습의 클래스당 20장 정확도가 63.7% 로 나왔다. 표준화한 뒤에는 89.1% 다. 방법마다 특징의 크기가 달라서, 같은 600스텝에 머리가 덜 배운 채 끝난 것이었다. 선형 프로브의 숫자는 프로브를 어떻게 학습했는지에 크게 달려 있다. 이 글의 표는 모두 표준화한 뒤의 값이다.
실험의 한계. 작은 합성곱망과 도형 12종이다. 라벨 없는 데이터 6,000장은 시험과 같은 분포에서 나왔는데, 실제로는 사전학습 데이터와 뒤의 과제가 다른 경우가 많다. 대조 학습의 변형(상하좌우 2칸 이동)이 이 데이터의 클래스와 무관한 변화와 정확히 맞아떨어진 것도 대조 쪽에 유리했다.
4. 한 문단 요약
자기지도 학습은 라벨 대신 데이터 자신에게서 문제를 만들어 몸통을 먼저 학습한다. 라벨 없는 그림 6,000장으로 “같은 그림의 두 변형 알아보기”를 학습한 몸통은, 라벨이 클래스당 2장일 때 58.1%(처음부터는 17.8%), 20장일 때 89.1%(처음부터는 56.8%)를 맞혔다. 처음부터 배운 모델은 라벨을 5배 써도 82.3% 였다. “가려 놓고 맞히기”는 복원은 잘했지만 분류에는 무작위 몸통과 차이가 없었다. 가린 화소를 채우는 데 필요한 정보가 도형을 가르는 정보와 달랐기 때문이다. 라벨이 아주 적을 때는 몸통까지 고치는 미세조정이 오히려 손해였다(58.1% 대 20.3%). 그리고 변형에 90도 회전을 넣자 “오른쪽이 어둡다”와 “아래가 어둡다”를 42.0% 헷갈렸다. 무엇을 같다고 가르쳤는지가 무엇을 구별할 수 있는지를 정한다.
참고
- Chen 외 — A Simple Framework for Contrastive Learning of Visual Representations (SimCLR, 2020)
- He 외 — Masked Autoencoders Are Scalable Vision Learners (2021)
- Devlin 외 — BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding (2018)
- Tian 외 — What Makes for Good Views for Contrastive Learning? (2020)
- 연재: 전이 학습과 파국적 망각 편 · word2vec 편 · 소프트맥스와 교차 엔트로피 편