인지야공/오늘의 AI 이슈/21번째 글
40걸음을 8걸음으로 — 스텝 증류가 하는 일
실행:
python 딥러닝/daily/DAILY_2026_10_11_step_distill.py(검증 환경: torch 2.8.0+cu129, RTX 5080, 4분) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. Qwen 의 모델을 돌린 것이 아니라, 2차원 점 데이터로 만든 아주 작은 모델에서 원리만 잰 것이다. Qwen 이 Turbo 를 어떤 방법으로 학습했는지는 공개되지 않았고, 이 글은 그것을 추측하지 않는다.
1. 무슨 일이 있었나
10월 9일, 알리바바의 Qwen 팀이 이미지 생성·편집 모델 Qwen-Image-2.1 의 가속판 Qwen-Image-2.1-Turbo 를 공개했다 (MarkTechPost, OrcaRouter, Kingy AI, 공식 GitHub). 아래는 보도에 실린 내용이고, 기술 사항은 모두 Qwen 의 모델 카드와 설정 파일에서 나온 것이다.
| 구분 | 보도된 내용 |
|---|---|
| 걸음 수 | 기본 모델의 예제는 40스텝, Turbo 는 8스텝 |
| 구조 | 기본 모델과 같은 70억 파라미터 생성기. LoRA 가 아니라 통째로 된 체크포인트다 |
| 안내 없는 샘플링 | “CFG 1 이 기본값”. 조건 없는 쪽을 한 번 더 계산하는 단계를 쓰지 않는다 |
| 걸음 간격 | 8스텝의 시각표가 체크포인트 설정에 들어 있어 자동으로 불러온다. 스텝 수만 바꿔서는 덮어써지지 않고, 다른 시각표는 “평가되지 않았다” |
| 라이선스 | Qwen Research License. 연구·평가 목적만 허용하고 상업적 이용은 별도 허가가 필요하다 |
| 공개하지 않은 것 | 증류 방법의 이름과 학습 세부, 속도·지연 측정값, 기본 모델과의 품질 비교 |
확인해 둘 것이 셋 있다.
- MarkTechPost 와 GitHub 는 접속이 막혀 직접 읽지 못했다. 위 표는 모델 카드를 옮긴 두 해설 글(OrcaRouter, Kingy AI)에 기대고 있다. 두 글 모두 모델을 직접 돌려 보지 않았다고 밝혔다.
- “약 5배 빠르다”는 표현이 돌지만 Qwen 이 낸 측정값은 없다. 40 을 8 로 나눈 산수다.
- 품질이 얼마나 유지되는지에 대한 수치는 아직 없다. 공개된 것은 Qwen 이 고른 예시 그림뿐이다.
그래서 이 글은 “8스텝이 40스텝만큼 좋은가”를 판정하지 않는다. 대신 걸음 수를 줄이면 무엇이 무너지고, 증류가 그것을 어떻게 되돌리는지를 작은 모델로 잰다.
2. 핵심 개념 — 길을 따라 걷기
그림은 한 번에 나오지 않는다
확산 계열의 모델은 잡음에서 출발해 조금씩 그림 쪽으로 걸어간다. 이 편에서는 그 계열 가운데 식이 가장 단순한 흐름 모델로 설명한다. 큰 틀은 확산 모델 편과 같다.
- 시각 에는 순수한 잡음, 에는 데이터가 있다.
- 모델은 속도장 를 배운다. “지금 에 있고 시각이 라면 어느 방향으로 얼마나 빨리 가야 하는가”다.
- 그림을 만들 때는 잡음 한 점에서 출발해 속도를 따라 에서 까지 간다.
| 기호 | 뜻 |
|---|---|
| 지금의 위치 (이미지 모델이라면 만들어지는 중인 그림) | |
| 시각. 1 이 잡음, 0 이 데이터 | |
| 신경망이 내는 속도 | |
| 걸음 수(스텝 수). 신경망을 부르는 횟수와 같다 | |
| 걸음을 떼는 시각들. , |
걸음을 떼는 법
속도는 위치마다 다르므로 길은 휘어 있다. 그 길을 정확히 따라가려면 아주 잘게 걸어야 한다. 실제로는 걸음으로 끊어 걷는다.
“지금 자리의 속도로, 다음 시각까지 곧장 간다”는 뜻이다(오일러 방법). 걸음이 크면 길이 휘는 것을 못 따라가고 바깥으로 벗어난다.
스텝 증류
스텝 증류는 큰 걸음이 길 위에 떨어지도록 속도를 다시 가르치는 일이다.
- 선생 모델을 잘게(여기서는 40걸음) 돌려 길을 얻는다.
- 그 길에서 다섯 걸음마다 한 점씩, 모두 9개의 점 을 적어 둔다.
- 학생은 ” 에서 한 걸음에 에 닿는 속도”를 맞히도록 학습한다.
오른쪽은 그 구간에서 선생이 실제로 간 평균 속도다. 선생은 그 자리의 순간 속도를 냈고, 학생은 구간 전체의 평균을 낸다. 지식 증류 편의 증류가 큰 모델의 답을 작은 모델에 옮겼다면, 이것은 같은 크기의 모델에 긴 계산의 결과를 옮긴다. 이것은 여러 증류 방법 가운데 가장 단순한 꼴이고, 실제 제품이 쓰는 방법은 이보다 복잡하다.
걸음을 어디에 놓나
8걸음을 같은 간격으로 놓을 필요는 없다. 길이 많이 휘는 구간에 걸음을 더 쓰면 같은 8걸음으로 더 정확해진다. 걸음의 시각표를 한쪽으로 치우치게 하는 흔한 식이 있다.
이면 같은 간격이고, 이면 잡음 쪽( 가 큰 쪽)에 걸음이 촘촘해지고, 이면 데이터 쪽에 촘촘해진다. Turbo 가 시각표를 체크포인트에 넣어 둔 것은, 학생이 그 시각들에서만 학습됐기 때문이라고 읽을 수 있다. 이것은 내 해석이다.
신경망을 몇 번 부르나
그림 한 장의 비용은 거의 전부 신경망을 부르는 횟수다.
| 설정 | 계산 | 호출 횟수 |
|---|---|---|
| 40걸음 | 40 | |
| 40걸음 + 안내(CFG): 조건 있는 쪽과 없는 쪽을 둘 다 계산 | 80 | |
| 8걸음, 안내 없음 | 8 |
기본 모델이 안내를 쓰는지는 내가 읽은 자료에 없었다. 쓴다면 호출이 10분의 1 이 되고, 안 쓴다면 5분의 1 이다. 어느 쪽이든 산수이고 측정값이 아니다.
3. 직접 재 보기
데이터는 2차원 평면의 점이다. 반지름 2 인 원 위에 가우시안 봉우리 8개를 놓았다(표준편차 0.05). 선생은 은닉층 3개(각 256)짜리 완전연결망이고 20,000스텝 학습했다. 시드 3개의 평균이다.
품질은 좋은 표본의 비율로 잰다. 만든 점 20,000개 가운데 가장 가까운 봉우리 중심에서 표준편차의 3배 안에 떨어진 점의 비율이다. 진짜 데이터는 98.9% 다.
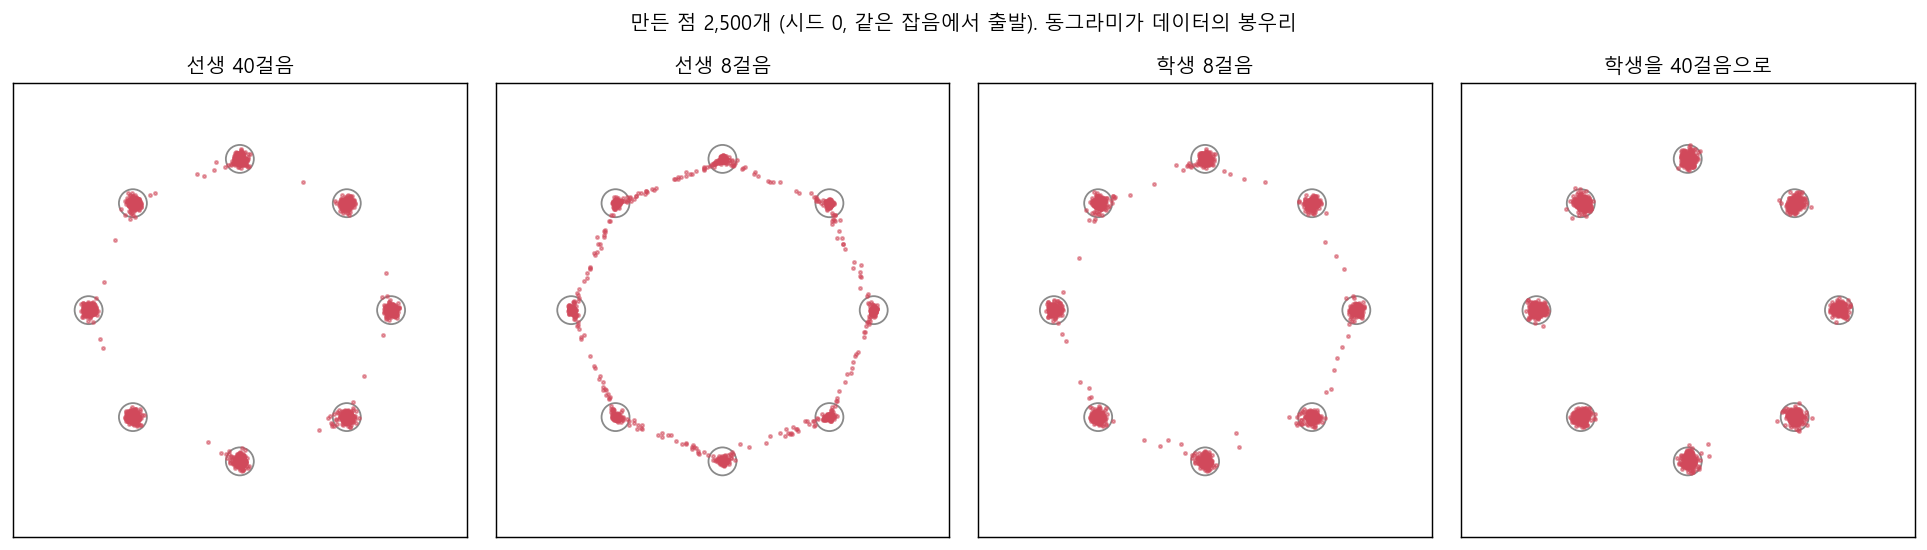
[A] 걸음 수를 줄이면
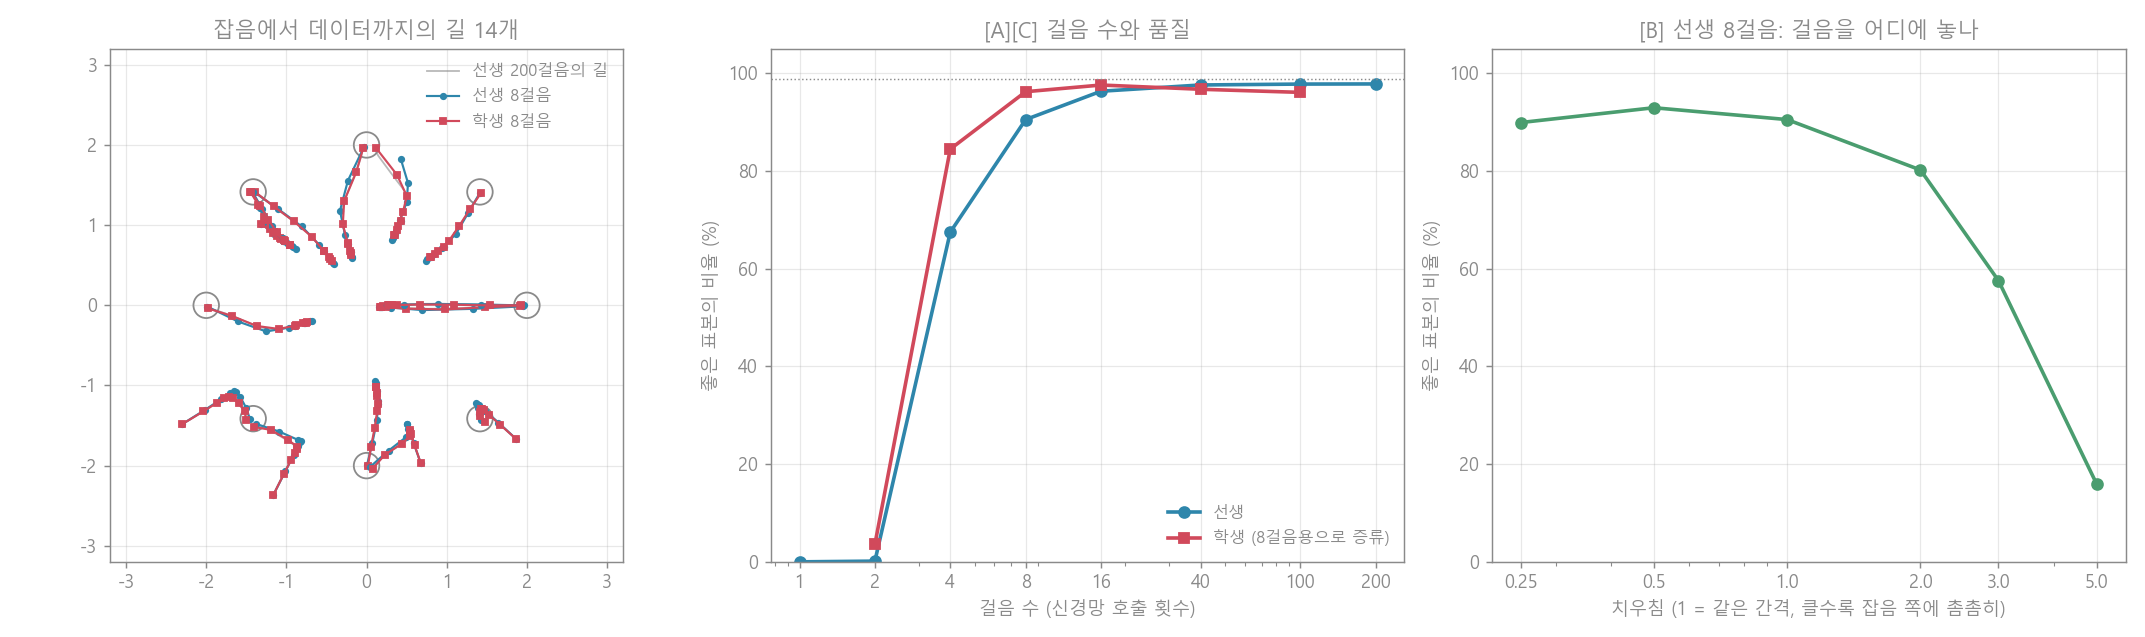
선생을 같은 간격으로 1~200걸음 돌렸다. “거리”는 같은 잡음에서 출발해 200걸음으로 간 결과와 얼마나 떨어졌는지의 평균이다.
| 걸음 수 | 좋은 표본 | 만든 봉우리 | 200걸음 결과와의 거리 |
|---|---|---|---|
| 1 | 0.0% | 0 / 8 | 2.001 |
| 2 | 0.1% | 0 / 8 | 0.724 |
| 4 | 67.5% | 8 / 8 | 0.144 |
| 8 | 90.5% | 8 / 8 | 0.058 |
| 16 | 96.3% | 8 / 8 | 0.027 |
| 40 | 97.6% | 8 / 8 | 0.009 |
| 100 | 97.8% | 8 / 8 | 0.002 |
| 200 | 97.8% | 8 / 8 | 0 |
- 40걸음이면 충분했다. 40걸음과 200걸음의 차이는 0.2%p 다. 걸음을 더 늘려도 얻는 것이 없다.
- 8걸음에서 7.1%p 를 잃는다(97.6% → 90.5%). 그림에서 보면 봉우리 사이로 점이 흘러 나와 원을 따라 번진다.
- 1걸음은 전부 실패다. 거리 2.001 은 원의 반지름과 같다. 한 걸음짜리 표본이 모두 원의 한가운데에 떨어졌다는 뜻이다. 잡음에서 본 “데이터 쪽”은 여덟 봉우리의 평균, 곧 중심이기 때문이다. 어느 봉우리로 갈지는 걸어가면서 정해진다.
- 거리는 걸음 수를 두 배로 늘릴 때마다 대략 절반이 된다(0.058 → 0.027). 오일러 방법의 오차가 걸음 크기에 비례한다는 교과서의 내용과 맞는다.
[B] 8걸음을 어디에 놓나
선생은 그대로 두고 8걸음의 시각표만 바꿨다.
| 치우침 | 걸음을 떼는 시각 | 좋은 표본 |
|---|---|---|
| 0.25 | 1.00, 0.64, 0.43, 0.29, 0.20, 0.13, 0.08, 0.03, 0 | 89.9% |
| 0.5 | 1.00, 0.78, 0.60, 0.45, 0.33, 0.23, 0.14, 0.07, 0 | 92.9% |
| 1 (같은 간격) | 1.00, 0.88, 0.75, 0.62, 0.50, 0.38, 0.25, 0.12, 0 | 90.5% |
| 2 | 1.00, 0.93, 0.86, 0.77, 0.67, 0.55, 0.40, 0.22, 0 | 80.2% |
| 3 | 1.00, 0.95, 0.90, 0.83, 0.75, 0.64, 0.50, 0.30, 0 | 57.6% |
| 5 | 1.00, 0.97, 0.94, 0.89, 0.83, 0.75, 0.62, 0.42, 0 | 15.9% |
- 같은 모델, 같은 8걸음인데 92.9% 에서 15.9% 까지 갈린다. 가중치는 하나도 바꾸지 않았다.
- 이 데이터에서는 데이터 쪽에 걸음을 조금 더 쓴 가 가장 좋았다. 봉우리가 아주 좁아서(표준편차 0.05) 마지막에 정확히 내려앉는 데 걸음이 필요하다. 는 마지막 한 걸음이 에서 0 까지를 한 번에 건너뛰고, 그 걸음에서 무너진다.
- 큰 이미지 모델에서는 흔히 을 쓴다. 이 실험과 방향이 반대다. 어느 쪽이 좋은지는 데이터에 달려 있고, 이 결과를 이미지 모델로 옮겨서는 안 된다. 옮길 수 있는 것은 “걸음 수가 적을수록 시각표가 결과를 크게 가른다”는 것까지다.
[C] 스텝 증류
선생의 40걸음 궤적을 8걸음에 따라가도록 학생을 4,000스텝 학습했다. 학생은 선생의 가중치에서 출발했고, 시각표는 같은 간격이다.
| 모델 | 신경망 호출 | 좋은 표본 | 만든 봉우리 | 선생 40걸음 결과와의 거리 |
|---|---|---|---|---|
| 선생 40걸음 | 40 | 97.6% | 8 / 8 | 0 |
| 선생 8걸음 | 8 | 90.5% | 8 / 8 | 0.050 |
| 학생 8걸음 | 8 | 96.2% | 8 / 8 | 0.011 |
- 학생은 8걸음으로 96.2% 를 냈다. 선생이 8걸음에서 잃은 7.1%p 가운데 5.7%p 를 되찾았다. 40걸음과의 차이는 1.4%p 다.
- 같은 잡음에서 거의 같은 곳에 닿는다. 선생 40걸음의 결과와의 거리가 0.050 에서 0.011 로 줄었다. 봉우리의 표준편차(0.05)보다 작다.
- 봉우리 8개를 모두 만들었다. 이 방법은 선생의 길을 그대로 따라가는 것이라 다양성을 잃을 까닭이 없다. 판별기를 쓰는 다른 증류 방법은 사정이 다를 수 있고, 그것은 재지 않았다.
학생을 다른 걸음 수로 돌리면. Turbo 의 모델 카드는 다른 시각표가 “평가되지 않았다”고 했다. 학생을 8걸음이 아닌 수로 돌려 봤다.
| 학생의 걸음 수 | 좋은 표본 | 선생 40걸음 결과와의 거리 |
|---|---|---|
| 2 | 3.6% | 0.492 |
| 4 | 84.5% | 0.083 |
| 8 | 96.2% | 0.011 |
| 16 | 97.6% | 0.030 |
| 40 | 96.7% | 0.031 |
| 100 | 96.1% | 0.035 |
- 품질은 무너지지 않았다. 걸음을 늘려도 96~98% 를 유지했다. 걸음 수를 바꾸면 망가질 것이라는 내 예상은 품질에 대해서는 틀렸다.
- 그런데 닿는 곳이 달라진다. 선생의 결과와의 거리는 8걸음에서 가장 작고(0.011), 16걸음 이상에서는 세 배(0.030~0.035)다. 걸음을 늘릴수록 선생에 가까워지는 것이 아니라 멀어진다. 학생이 배운 것은 순간 속도가 아니라 “한 걸음이 8분의 1 일 때의 평균 속도”이기 때문이다. 그 속도로 잘게 걸으면 다른 길이 나온다.
- 걸음을 더 줄이는 데에는 도움이 된다. 4걸음에서 학생은 84.5%, 선생은 67.5% 였다. 다만 2걸음은 여전히 실패다(3.6%).
4. 흔한 오해와 한계
“8스텝이면 5배 빠르다.” 신경망 호출이 5분의 1 이라는 뜻이다. 실제 시간에는 글 인코더, 그림을 복원하는 단계, 모델을 올리는 시간이 더해지고 이것들은 줄지 않는다. Qwen 은 속도 측정값을 내지 않았다.
“걸음 수는 품질과 속도 사이의 손잡이일 뿐이다.” 증류한 모델에서는 아니다. 학생은 8걸음에서 선생과 가장 가까웠고, 걸음을 늘리자 오히려 멀어졌다.
“증류하면 모델이 작아진다.” 스텝 증류는 크기를 줄이지 않는다. Turbo 도 기본 모델과 같은 70억 파라미터다. 줄어드는 것은 부르는 횟수다.
“시각표는 사소한 설정이다.” 같은 가중치, 같은 8걸음에서 시각표만으로 92.9% 와 15.9% 가 갈렸다.
실험의 한계. 2차원 점 데이터와 작은 완전연결망이다. 이미지의 차원에서는 길이 휘는 모양도, 좋은 시각표도 다르다. 증류 방법은 궤적의 구간 평균 속도를 맞히는 가장 단순한 것 하나만 썼다. 분포를 맞추는 방법이나 판별기를 함께 쓰는 방법은 다루지 않았고, Qwen 이 무엇을 썼는지는 모른다. 안내(CFG)를 없애는 것은 걸음 수와는 별개의 증류인데 이 실험에는 조건이 없어서 재지 못했다. “좋은 표본의 비율”은 봉우리가 뚜렷한 이 데이터에서만 뜻이 있는 척도다. 이미지의 품질은 이렇게 한 숫자로 재어지지 않는다.
5. 한 문단 요약
Qwen 이 이미지 모델의 잡음 제거를 40스텝에서 8스텝으로 줄인 Turbo 를 공개했다. 증류 방법과 품질·속도의 측정값은 공개되지 않았다. 작은 흐름 모델로 원리를 재 보면, 잡음에서 데이터로 가는 길은 휘어 있어서 선생을 그냥 8걸음으로 돌리면 좋은 표본이 97.6% 에서 90.5% 로 떨어지고 2걸음이면 0.1% 가 된다. 선생의 40걸음 궤적에서 구간마다의 평균 속도를 배운 학생은 8걸음으로 96.2% 를 냈고, 같은 잡음에서 선생과 거의 같은 곳(거리 0.011)에 닿았다. 걸음을 어디에 놓느냐도 컸다. 같은 가중치의 8걸음이 시각표에 따라 92.9% 에서 15.9% 까지 갈렸다. 학생을 다른 걸음 수로 돌려도 품질은 유지됐지만 선생의 결과와의 거리는 세 배가 됐다. 줄어든 걸음 수는 모델에 새겨진 것이고, 시각표가 가중치와 함께 배포되는 까닭이다.
참고
- MarkTechPost — Alibaba Qwen Releases Qwen-Image-2.1-Turbo, an 8-Step 7B Image Model (2026-10-09)
- OrcaRouter — Qwen-Image-2.1-Turbo: the 8-step schedule now lives in the weights (2026-10-09)
- Kingy AI — Qwen Image 2.1 Turbo: Eight Steps and a License Catch (2026-10-09)
- QwenLM/Qwen-Image-2.1 (GitHub)
- Salimans, Ho — Progressive Distillation for Fast Sampling of Diffusion Models (2022)
- Lipman 외 — Flow Matching for Generative Modeling (2022)
- Liu, Gong, Liu — Flow Straight and Fast: Rectified Flow (2022)
- 관련 글: 확산 모델 편 · 지식 증류 편 · GAN 편