인지야공/오늘의 AI 이슈/20번째 글
한 시간을 이야기했는데 알림이 0건 — 언제 알릴지 정하는 산수
실행:
python 딥러닝/daily/DAILY_2026_10_10_sequential_alert.py(CPU 6초) 이 글의 수치는 전부 그 스크립트를 돌려 얻은 것이다. 실제 대화가 아니라, 메시지마다 점수 하나가 나온다고 가정해서 만든 모의실험이다. OpenAI 가 실제로 쓰는 규칙은 공개되지 않았고, 이 글은 그것을 추측하지 않는다.
1. 무슨 일이 있었나
10월 7일, 미국의 비영리 단체 Common Sense Media 의 Youth AI Safety Institute 가 ChatGPT for Teens 를 시험한 보고서를 냈다 (NPR, 10월 9일, Bloomberg, 10월 7일, Cryptopolitan, Resultsense). ChatGPT for Teens 는 13~17세로 확인된 사용자를 위한 모드이고, 연결된 보호자에게 위기 신호를 알리는 기능이 있다. 아래는 보도에 실린 내용이다.
| 구분 | 보도된 내용 |
|---|---|
| 시험 규모 | 4,000개가 넘는 프롬프트. 청소년 모드 출시 전과 후에 걸쳐 시험했다 |
| 알림의 목표 | OpenAI 는 한 시간 안에 알리는 것을 목표로 둔다 |
| 새 계정 | 보호자와 연결한 새 계정 열몇 개에서 위기에 해당하는 대화를 5분에서 한 시간까지 했고, 알림은 0건이었다 |
| 이력이 있는 계정 | 몇 주에 걸쳐 민감한 대화가 쌓인 계정에서만 알림이 왔다. 한 계정은 첫 알림이 3시간 뒤, 둘째 알림이 그로부터 3일 뒤였다. 다른 한 계정은 한 시간 안에 두 번 왔다 |
| 단체의 결론 | 알림이 말의 심각함이 아니라 계정의 이력을 따라간다. 종합 평가는 18세 미만 전체에 “받아들일 수 없는 위험” |
| OpenAI 의 반박 | 독립 평가는 환영하지만 이 시험이 안전장치의 실제 작동을 정확히 반영하지 않는다고 본다. 계정 연결 뒤 알림이 켜지기까지 몇 시간이 걸릴 수 있어, 시험 다수가 그 전에 끝났을 수 있다 |
| 단체의 재반박 | 충분히 오래 연결돼 있던 계정에서도 제때 온 알림은 없었다 |
확인해 둘 것이 셋 있다.
- 보고서 원문은 읽지 못했다. 위 표는 보도를 옮긴 것이고, 계정 수와 시험 기간의 정확한 값은 보도에 없었다.
- 양쪽의 주장이 엇갈린다. 시험이 알림이 켜지기 전에 끝났는지는 바깥에서 확인할 수 없다.
- OpenAI 가 알림을 어떤 규칙으로 울리는지는 공개되지 않았다.
그래서 이 글은 누가 옳은지를 가리지 않는다. 대신 “알림이 이력을 따라가는가, 심각함을 따라가는가”라는 구분이 알고리즘으로는 무엇의 차이인지를 본다.
2. 핵심 개념 — 언제 울릴 것인가
화재경보기의 문제
화재경보기를 생각한다. 연기가 조금 날 때마다 울리면 요리할 때마다 울리고, 사람들은 경보기를 꺼 버린다. 연기가 방을 가득 채워야 울리면 너무 늦다. 경보기는 두 가지를 동시에 줄여야 한다.
- 오경보: 아무 일도 없는데 울리는 것
- 지연: 일이 시작된 뒤 울리기까지 걸리는 시간
둘은 서로 반대로 움직인다. 이 거래를 다루는 분야가 순차 탐지다. 데이터가 하나씩 들어오는 동안 “지금 울릴까, 하나 더 볼까”를 매번 정한다.
모형
메시지마다 분류기가 걱정 점수 하나를 낸다고 하자.
| 기호 | 뜻 |
|---|---|
| 메시지의 순서 (1, 2, 3, …) | |
| 번째 메시지의 걱정 점수 | |
| 걱정스러운 메시지의 점수가 평소보다 평균적으로 높은 정도. 클수록 신호가 뚜렷하다 | |
| 기준값. 점수가 이보다 낮으면 “평소 쪽”으로 친다 | |
| 번째 메시지까지 쌓인 증거 | |
| 문턱값. 가 이것을 넘으면 알린다 |
평소 메시지의 점수는 0 근처에서, 걱정스러운 메시지의 점수는 근처에서 흩어진다고 가정한다(둘 다 표준편차 1). 면 한 메시지만 봐도 거의 확실하고, 이면 평소 메시지와 많이 겹친다. 에둘러 말하는 경우가 뒤쪽이다.
규칙 1 — 메시지를 하나씩 본다
가장 단순한 규칙은 “점수가 높은 메시지가 하나라도 나오면 알린다”이다.
뚜렷한 메시지에는 즉시 반응한다. 하지만 흐린 신호는 몇 개가 이어져도 하나하나가 문턱을 못 넘으면 영영 안 울린다.
규칙 2 — 쌓아서 본다 (CUSUM)
CUSUM(누적합)은 메시지마다 “기준값보다 얼마나 높았는가”를 더해 간다. 다만 0 아래로는 내려가지 않게 한다.
- 평소 메시지는 가 대체로 음수라 가 0 으로 돌아간다. 옛 일을 잊는 장치다.
- 걱정스러운 메시지가 이어지면 가 계단처럼 올라간다.
, 로 따라가 본다.
| 메시지 | 점수 | ||
|---|---|---|---|
| 1 | 0.2 | -0.3 | 0 |
| 2 | -0.6 | -1.1 | 0 |
| 3 | 1.4 | 0.9 | 0.9 |
| 4 | 0.9 | 0.4 | 1.3 |
| 5 | 1.8 | 1.3 | 2.6 |
| 6 | 1.1 | 0.6 | 3.2 |
| 7 | 2.0 | 1.5 | 4.7 → 알림 |
3번부터 7번까지 어느 메시지도 점수가 2.0 을 넘지 않았다. 하나씩 보는 규칙이 문턱값을 3 쯤에 두었다면 한 번도 울리지 않는다. 쌓아서 보면 7번 메시지에서 울린다.
걱정스러운 메시지가 이어질 때 는 메시지 하나에 평균 씩 오른다. 그래서 알림까지 걸리는 메시지 수는 대략 다음과 같다.
, 라면 일 때 16개, 일 때 2.3개다. 신호가 뚜렷할수록 빨리 울린다. 심각도가 속도에 들어가 있다.
규칙 3 — 횟수를 센다
또 하나의 흔한 규칙은 “점수가 일정 값을 넘은 메시지(깃발)가 개 쌓이면 알린다”이다.
구현이 쉽고 설명하기도 쉽다. 그런데 이 규칙에서 메시지 하나는 아무리 뚜렷해도 깃발 하나다. 점수가 2.1 이든 6.0 이든 똑같이 1 을 더한다. 그리고 깃발이 이미 쌓여 있는 계정은 몇 개만 더 나오면 울리고, 깃발이 0개인 새 계정은 개를 처음부터 채워야 한다. “이력을 따라가는 알림”이 어떤 모양인지 보여 주는 가장 단순한 규칙이라 대조군으로 골랐다. 실제 서비스가 이 규칙을 쓴다는 뜻이 아니다.
기저율
마지막으로 하나 더. 걱정스러운 대화는 드물다. 드문 일을 찾는 경보는 오경보율이 낮아 보여도 알림의 대부분이 가짜가 된다.
| 기호 | 뜻 |
|---|---|
| 전체 대화 가운데 정말 걱정스러운 대화의 비율 | |
| 잡는 비율 | 걱정스러운 대화에서 알림이 울리는 비율 |
| 오경보율 | 평소 대화에서 알림이 울리는 비율 |
, 잡는 비율 100%, 오경보율 1% 라면 다. 알림 11건 중 10건이 가짜다.
3. 직접 재 보기
한 시간에 메시지 20개를 주고받는다고 가정했다. 이 숫자와 아래의 기저율은 내가 정한 가정이고, 실제 통계가 아니다.
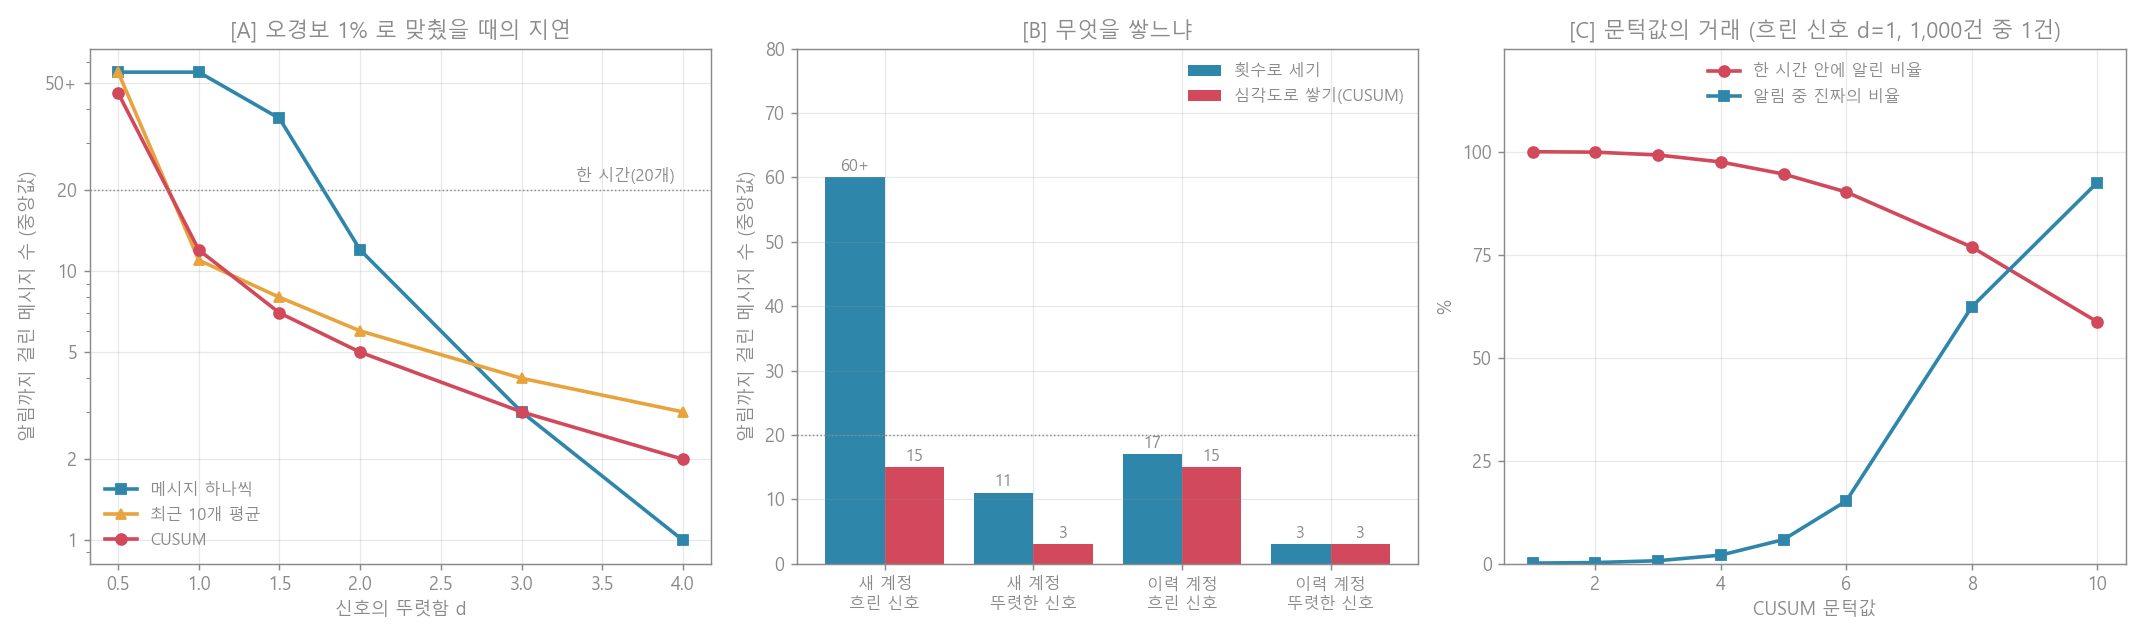
[A] 하나씩 보기와 쌓아서 보기
세 규칙의 문턱값을, 평소 메시지 60개짜리 대화의 1% 에서만 울리도록 맞췄다(다시 재면 0.88~1.05%). 그런 다음 11번째 메시지부터 걱정스러운 메시지가 이어지게 했다. 대화 5만 건이다.
| 신호의 뚜렷함 | 하나씩: 지연 (한 시간 안) | 최근 10개 평균: 지연 (한 시간 안) | CUSUM: 지연 (한 시간 안) |
|---|---|---|---|
| 0.5 | 50개 초과 (2.1%) | 50개 초과 (15.5%) | 46개 (18.9%) |
| 1.0 | 50개 초과 (9.4%) | 11개 (79.5%) | 12개 (87.7%) |
| 1.5 | 37개 (31.3%) | 8개 (99.7%) | 7개 (99.9%) |
| 2.0 | 12개 (68.9%) | 6개 (100%) | 5개 (100%) |
| 3.0 | 3개 (99.9%) | 4개 (100%) | 3개 (100%) |
| 4.0 | 1개 (100%) | 3개 (100%) | 2개 (100%) |
지연은 알림까지 걸린 메시지 수의 중앙값이다.
- 흐린 신호()에서 차이가 가장 크다. 하나씩 보는 규칙은 한 시간 안에 9.4% 만 잡았다. 같은 오경보율의 CUSUM 은 87.7% 다.
- 아주 뚜렷한 신호()에서는 하나씩 보는 쪽이 한 메시지 빠르다. 쌓는 규칙은 한 번에 문턱을 넘지 못해 두 개가 필요했다. 실제 장치라면 둘을 함께 두는 것이 자연스럽다.
- 는 어느 규칙도 한 시간 안에 20% 를 못 잡았다. 분류기가 구분하지 못하는 신호는 쌓는다고 생기지 않는다. 쌓기는 약한 증거를 모으는 것이지 없는 증거를 만드는 것이 아니다.
[B] 횟수로 세기와 심각도로 쌓기
이번에는 계정 단위로 본다. 최근 메시지 200개를 이력으로 두고, 평소 이력의 1% 에서만 울리도록 두 규칙을 맞췄다.
- 횟수 규칙: 점수가 2 를 넘으면 깃발. 평소 메시지의 2.27% 가 깃발을 받고, 200개 이력에는 평균 4.55개가 쌓인다. 문턱은 깃발 11개가 됐다(오경보 0.66%).
- CUSUM: 문턱값 7.96.
새 계정(깃발 0개)과 이력이 있는 계정(깃발이 이미 8개)에서, 걱정스러운 메시지가 이어질 때 알림까지 걸린 메시지 수의 중앙값이다. 괄호는 한 시간(20개) 안에 알린 비율이다.
| 계정 | 신호 | 횟수로 세기 | 심각도로 쌓기 (CUSUM) |
|---|---|---|---|
| 새 계정 | 흐림 () | 60개 초과 (0.0%) | 15개 (77.2%) |
| 새 계정 | 뚜렷함 () | 11개 (100%) | 3개 (100%) |
| 이력 있음 | 흐림 () | 17개 (63.5%) | 15개 (77.1%) |
| 이력 있음 | 뚜렷함 () | 3개 (100%) | 3개 (100%) |
- 횟수 규칙은 계정에 따라 결과가 갈린다. 같은 흐린 신호인데 새 계정은 한 시간 안에 0.0%, 이력이 있는 계정은 63.5% 다. 말은 같고 달라진 것은 이력뿐이다.
- 횟수 규칙은 심각함에 둔하다. 새 계정에서 가장 뚜렷한 신호가 이어져도 11개를 다 채워야 울린다. 한 시간에 20개라는 가정으로는 33분이다. CUSUM 은 3개, 9분이다.
- CUSUM 은 계정의 이력과 무관했다(15개와 15개, 3개와 3개). 평소 메시지가 이어지면 가 0 으로 돌아가기 때문이다.
- 이 표가 보도된 현상과 같은 모양이라고 해서 실제 서비스가 횟수를 센다는 증거가 되지는 않는다. 알림이 켜지기 전에 시험이 끝났다는 OpenAI 의 설명으로도 “새 계정 0건”은 나올 수 있다.
[C] 문턱값을 낮추면
“그러면 문턱값을 낮춰 빨리 울리게 하면 되지 않나.” 걱정스러운 대화가 1,000건 중 1건이라고 가정하고, 한 시간(메시지 20개)짜리 대화에서 CUSUM 의 문턱값을 바꿔 봤다. 흐린 신호()다.
| 문턱값 | 한 시간 안에 알림 | 지연 (중앙값) | 평소 대화의 오경보 | 알림 중 진짜 | 진짜 1건당 가짜 |
|---|---|---|---|---|---|
| 2 | 99.9% | 4개 | 39.95% | 0.2% | 399.5건 |
| 4 | 97.5% | 7개 | 4.65% | 2.1% | 47.6건 |
| 6 | 90.2% | 11개 | 0.50% | 15.2% | 5.6건 |
| 8 | 76.8% | 15개 | 0.046% | 62.3% | 0.6건 |
| 10 | 58.7% | 19개 | 0.005% | 92.5% | 0.1건 |
- 빨리 알리는 값은 오경보다. 문턱값 4 는 97.5% 를 7개 만에 잡지만 알림 100건 중 진짜는 2건이다. 보호자는 약 48번 헛걸음하고 한 번 진짜를 만난다.
- 믿을 만한 알림은 늦고, 놓친다. 문턱값 10 은 알림의 92.5% 가 진짜지만 한 시간 안에 58.7% 만 잡는다.
- 신호가 조금만 뚜렷해져도 거래가 훨씬 쉬워진다. 에서는 문턱값 8 로 한 시간 안에 100% 를 6개 만에 잡으면서 알림의 68.3% 가 진짜였다. 문턱값을 만지는 것보다 메시지 하나의 점수를 더 정확하게 만드는 쪽이 값이 크다.
4. 흔한 오해와 한계
“알림이 안 온 것은 탐지기가 못 알아봤기 때문이다.” 그럴 수도 있고 아닐 수도 있다. 탐지기가 알아봤어도 울리는 규칙이 횟수를 요구하면 늦게 울린다([B]). 알아보는 것과 울리는 것은 다른 단계다.
“문턱값을 낮추면 해결된다.” 1,000건 중 1건이라는 가정에서 문턱값 4 는 알림의 97.9% 가 가짜였다. 가짜가 많은 알림은 무시되기 시작하고, 무시되는 알림은 없는 것과 같다.
“오래 지켜보면 결국 잡는다.” 는 메시지 50개를 봐도 중앙값이 46개였다. 분류기가 구분 못 하는 신호는 시간이 해결하지 못한다.
“쌓는 규칙이 항상 낫다.” 가장 뚜렷한 신호에서는 하나씩 보는 규칙이 한 메시지 빨랐다.
실험의 한계. 점수가 정규분포이고 메시지끼리 독립이라는 가정은 실제와 다르다. 실제 대화의 점수는 앞뒤 메시지와 얽혀 있고, 걱정스러운 메시지와 평소 메시지가 섞여 나온다. 한 시간에 메시지 20개, 걱정스러운 대화 1,000건 중 1건이라는 숫자는 내가 정한 것이다. 기저율이 달라지면 [C] 의 “알림 중 진짜” 열이 통째로 달라진다. 실제 장치에는 사람이 검토하는 단계, 계정 연결 상태, 연령 확인 같은 단계가 더 있을 수 있고, 지연은 그 어디에서나 생길 수 있다. 알림을 받은 보호자가 어떻게 반응하는지, 오경보가 청소년과 보호자의 신뢰에 주는 비용은 이 모형에 없다.
5. 한 문단 요약
Common Sense Media 는 ChatGPT for Teens 의 보호자 알림이 새 계정에서는 한 건도 오지 않았고 이력이 쌓인 계정에서만 왔다고 밝혔고, OpenAI 는 시험이 실제 작동을 반영하지 않는다고 반박했다. 알림은 오경보와 지연을 맞바꾸는 순차 탐지 문제다. 모의실험에서 메시지를 하나씩 보는 규칙은 흐린 신호를 한 시간 안에 9.4% 만 잡았고, 점수를 쌓는 CUSUM 은 같은 오경보율에서 87.7% 를 잡았다. 무엇을 쌓느냐도 갈랐다. 깃발의 횟수를 세는 규칙은 뚜렷한 신호가 이어져도 새 계정에서 메시지 11개가 지나야 울렸고, 이력이 있는 계정에서는 3개 만에 울렸다. 심각도를 쌓는 CUSUM 은 어느 계정에서나 3개였다. 문턱값을 낮춰 빨리 울리게 하면 알림 100건 중 진짜가 2건으로 줄었다. 거래를 가장 크게 바꾼 것은 문턱값이 아니라 메시지 하나를 얼마나 정확히 읽느냐였다.
혼자 감당하기 어려운 마음이 들 때는 자살예방상담전화 109(24시간), 청소년상담전화 1388 로 연락할 수 있다.
참고
- NPR — ChatGPT for Teens has special safeguards. A watchdog group finds most don’t work (2026-10-09)
- Bloomberg — ChatGPT for Teens Is Not Safe for Kids, Common Sense Media Report Says (2026-10-07)
- Cryptopolitan — ChatGPT for Teens alerted parents late or never, Common Sense finds
- Resultsense — ChatGPT teen safety alerts fall short, Common Sense finds (2026-10-08)
- Page — Continuous Inspection Schemes (1954) (CUSUM)
- 관련 글: 캘리브레이션 편 · 평가 편